DeepSeek R1本地RAG知识库搭建全攻略

基于Ollama、DeepSeek R1、Nomic和Cherry Studio,从零搭建本地私有化RAG知识库的实操指南与效果分析。
文章针对大模型在专业领域易产生幻觉的问题,介绍了RAG(检索增强生成)的解决方案。全文以B站UP主的保姆级教程为基础,拆解了RAG的索引、检索、生成三步工作流,并详细说明了如何用Ollama、DeepSeek R1 7B、Nomic Embedding和Cherry Studio四件套搭建本地私有化知识库。实操部分涵盖安装配置、模型拉取、知识库创建与数据导入。实测表明,7B小模型即使获得知识库上下文仍无法正确回答,切换云端API推理模型后效果显著提升,说明底层模型能力决定RAG效果上限。文章最后总结了分块策略、检索片段数等调优关键点及适用边界。
大模型在通用问题上表现惊艳,但一碰到专业领域就容易“胡编乱造”——这就是幻觉。要解决这个问题,RAG(检索增强生成)是目前最实用的方案之一。本文基于B站UP主的保姆级教程,拆解如何用Ollama、DeepSeek R1、Nomic向量模型和Cherry Studio,从零搭建一个本地私有化RAG知识库。
为什么需要RAG?大模型幻觉的根源
UP主在视频中直指痛点:大模型解决通用问题推理能力很强,但面对专业问题时回答往往笼统,甚至出现“驴唇不对马嘴”的幻觉。所谓幻觉,就是模型知识库里并不存在对应知识,却强行给出一个看似准确、实则错误的答案。
RAG的核心思路是“先查资料再回答”。它从大规模知识库中检索相关信息,再结合模型生成高质量反馈。相比直接向大模型提问,RAG在对抗幻觉、管理本地文件和数据安全方面优势明显,尤其适合对隐私敏感的企业或个人场景。
RAG工作流拆解:索引、检索、生成
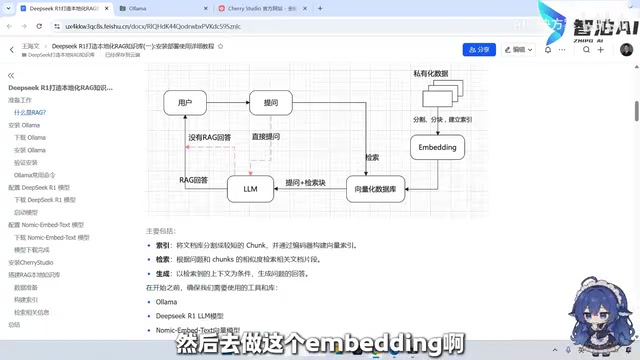
视频用一张流程图讲清了RAG的完整链路。没有RAG时,用户问题直接交给大模型,模型凭内部知识回答。加入RAG后,流程变成三步:
- 索引:将本地私有数据(PDF、Word、Excel、TXT,甚至视频音频)进行分割分块,通过embedding向量化后存入向量数据库。
- 检索:用户提问时,先在向量数据库中检索相关片段,而非直接抛给大模型。
- 生成:将检索到的相关片段与用户问题组合成上下文,一起送入大模型,模型参考这些内容生成综合答案。
UP主强调,检索环节的相似度匹配机制至关重要——分块质量、检索策略直接决定最终答案的准确性。这也是RAG落地时最需要调优的部分。
Embedding(向量化) 是RAG流程中的关键步骤。它通过嵌入模型将文本片段映射为高维数值向量,使语义相近的文本在向量空间中距离更近。Nomic Embedding即属于此类模型,负责把分割后的文档块转换为向量表示。向量数据库则专门存储这些向量,并支持高效的相似度检索(如余弦相似度)。用户提问时,系统同样将问题向量化,然后在数据库中查找最接近的片段。Embedding模型的质量直接影响检索的召回率和准确率,因此选择与领域匹配的嵌入模型是RAG调优的重要一环。
分块(Chunking)策略 决定了文本被分割的粒度。常见方式包括固定长度分块、按段落或标题分块、重叠分块等。分块过大可能导致噪声增加,过小则可能丢失上下文。检索片段数(即引用片段数量)则控制送入大模型的上下文长度,数量越多上下文越丰富,但也会增加推理负担和延迟。这些参数需要在具体场景中权衡调整。
工具选型:四个组件各司其职
搭建本地RAG知识库需要四个核心工具:
- Ollama:本地运行大语言模型的工具,下载安装简单,支持Windows等主流系统。
- DeepSeek广告 R1:选用7B版本作为本地推理模型。
- Nomic Embedding:文本向量化模型,负责将文档片段转为向量。
- Cherry Studio:集成多语言模型服务商的客户端平台,支持知识库管理、MCP工具调用等功能。
UP主特别提到,如果之前没下载过模型,Ollama的run命令会自动触发下载并启动;向量模型则用pull命令下载即可,不需要运行。
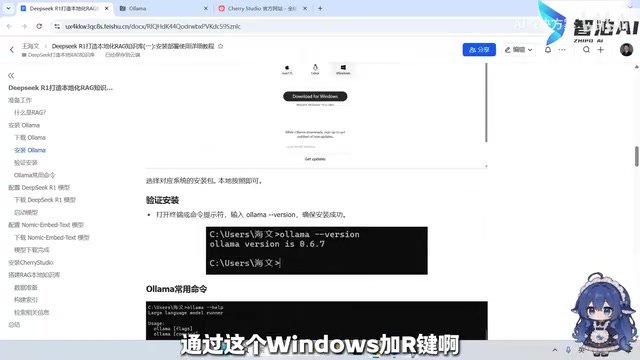
Ollama 是一个开源的本地大模型运行框架,它封装了模型下载、加载和推理的复杂过程,提供命令行和API接口。用户只需一条命令即可运行多种开源模型(如Llama、DeepSeek等),并支持自定义模型文件。其run命令用于启动模型(若未下载则自动拉取),pull命令仅下载模型而不运行,list查看本地模型,ps查看运行中的模型。Ollama降低了本地部署门槛,使非专业用户也能快速体验大模型。
DeepSeek R1 是深度求索公司发布的推理模型系列,包含不同参数规模(如7B、32B等)。7B版本适合本地轻量部署,但推理能力有限;更大参数版本或云端API则能提供更强的逻辑推理和知识运用能力。R1系列强调思维链推理,在复杂问题上表现更优,但需要更多计算资源。
Cherry Studio 是一款支持多模型服务商接入的客户端软件,集成了聊天、知识库管理、MCP工具调用等功能。它允许用户统一配置不同来源的模型(本地Ollama或云端API),并方便地切换。其知识库功能支持文档导入、自动分块、向量化及检索增强问答,简化了RAG应用的搭建流程。
实操步骤:从安装到知识库创建
安装Ollama并验证
从Ollama官网下载对应系统安装包,安装过程与普通软件无异。安装完成后,按Win+R打开命令行,输入ollama --version确认版本(UP主演示时为0.6.7),再用ollama --help查看常用命令,如create、run、stop、push、list、ps等。
拉取DeepSeek R1与Nomic模型
在命令行执行ollama run deepseek-r1:7b,首次运行会自动下载模型。接着用ollama pull nomic-embed-text下载向量模型。UP主提醒,7B模型推理能力有限,如果回答质量不理想,可以换用参数量更大的模型或调用API。
配置Cherry Studio
从官网下载Cherry Studio(一般选x64版本),打开后界面包含聊天助手和设置齿轮图标。在设置中可配置MCP工具、模型服务、知识库等。UP主称其支持市面上绝大多数大语言模型服务商,功能丰富。
创建知识库并导入数据
点击知识库按钮,添加新知识库并命名(如“课程测试”),嵌入模型可选默认的硅基流动或本地Ollama的Nomic模型——只要统一即可。请求文档片段数可调,拉满会增加上下文但速度变慢,UP主建议先用默认值测试。
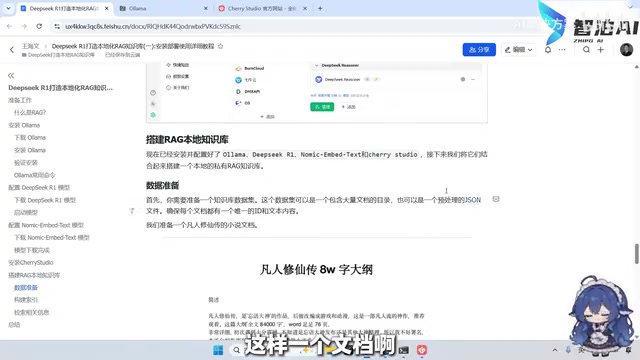
添加文件时支持格式非常多,UP主特意选择一本小说PDF来模拟真实业务中非标准格式的数据。导入后系统自动完成分割和向量化,无需手动干预。
实测效果:7B模型不够用,换API立竿见影
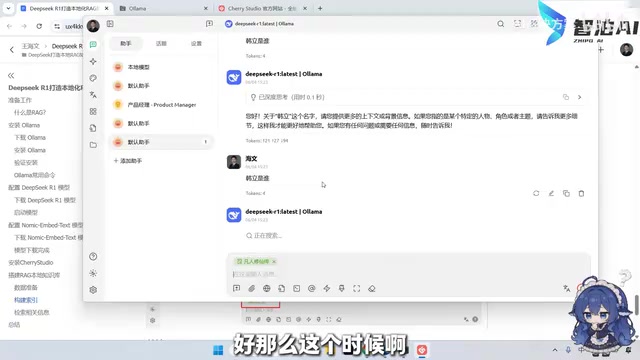
UP主先用本地DeepSeek R1 7B模型提问,发现它无法正确回答。加入知识库后,系统引用了30个片段作为上下文,但7B模型仍然给出错误答案。UP主解释:模型回复依赖推理能力,参数太小的模型即使给了资料也推理不出来。
随后切换到官网API的推理模型(视频中称为“gibbsake的resonance”),同样引用30个片段,模型经过思考后返回的结果基本正确,包括核心数据如年龄、事件等都对得上。这说明RAG的效果高度依赖底层模型能力——小模型适合轻量场景,专业应用建议用更强模型。
关键经验与适用边界
从这次实操可以提炼几点:本地RAG部署门槛确实不高,Ollama+Cherry Studio组合让非专业用户也能上手;但7B小模型在专业问答上力不从心,RAG能提供上下文,却弥补不了推理能力的短板。
对于隐私要求高、数据不出本地的场景,这套方案值得尝试;如果追求回答质量,建议搭配云端API或更大参数模型。UP主也提到,分块策略、检索片段数量、embedding模型选择都会影响最终效果,实际落地时需要针对自己的数据做调优。
视频最后UP主表示会继续分享更多RAG相关内容,评论区可留言交流。
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。
 科技前沿
GitHub日报·11月07日:Agent就绪与上下文压缩
2026年09月02日(周三)午间版 AI新闻速递+热点深度讨论
 科技前沿
ToolLens:用Rust打造的MCP网关,将数千工具精简为三个
ToolLens 是一个用 Rust 编写的开源 MCP 网关,只向 AI 智能体暴露三个工具而非数千个,通过网关模式解决工具数量膨胀带来的上下文压力,为 MCP 生态提供工程化参考。