DeepSeek开源推理框架DeepInfer,大模型黑箱被打破

DeepSeek开源推理框架DeepInfer,靠读写分离、缓存复用与投机解码把成本和延迟压到极低。
DeepSeek开源了大模型推理框架DeepInfer,据称日处理155万亿Token、首字延迟平均0.4秒、代码场景每秒输出300个Token,开源两周GitHub星标达25,000。它负责请求排队、分类、拆分调度与结果汇合,直接决定用户等待时间、首字速度和能耗成本。其核心手段包括读写分离(Prefill与Decode分别用不同规格机器)、缓存复用(约100PiB闪存缓存池,命中率96%,命中与未命中价格差50倍)、小模型先猜大模型再验,以及专家并行调度。英伟达与华为昇腾950同时首发。但缓存管理、读写、拆分调度、负载均衡三块核心代码并未开源。文章认为这既是降低行业门槛的格局之举,也可能是借生态扩张掌握标准制定权的阳谋。
DeepSeek再一次把桌子掀了。这次开源的并非又一个模型,而是大模型公司通常藏得最深的推理框架——DeepInfer。据B站UP主介绍,这套系统一天要扛住155万亿Token的请求量,开源两周GitHub星标就冲到25,000。它到底管什么、凭什么又快又便宜,以及DeepSeek把家底往外送图的是什么,值得拆开来看。
DeepInfer到底在管什么
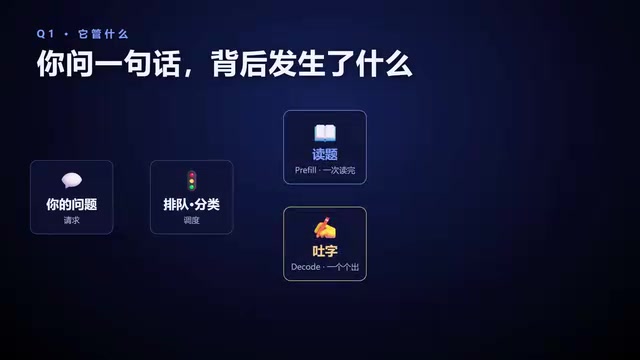
你问一句话,请求先排队分类,再拆成“图体”和“图字”两条线送进不同机器,算完汇合才轮到你看结果。DeepInfer管的就是这条流水线:你等多久、第一个字什么时候出来、烧多少电,全由它说了算。
换句话说,模型决定“答得好不好”,推理框架决定“答得快不快、贵不贵”。过去这部分是各家云厂商和模型公司的核心机密,现在DeepSeek广告把它摆到了桌面上。
两组数字看清它有多猛
据该UP主引用的数据,DeepInfer一天处理155万亿Token;用户等第一个字平均只要0.4秒;写代码场景每秒能吐300个Token;只按谷电价算,每张卡每小时进账38美元。这些指标放在一起,说明它在吞吐、延迟和成本三个维度上同时做到了相当激进的水平。
真正支撑这些数字的是下面几招工程手段。
第一招:读题和写字分两拨机器
读题是整段话从头算一遍,吃算力;写字是每吐一个字都要翻一遍笔记,吃带宽。就像饭店把切配和掌勺分开排班,读题用普通8卡机,写字用64到128卡的超节点,谁也不白花钱。
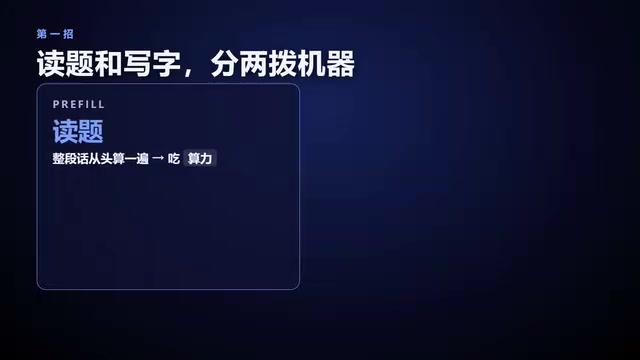
读题和写字的专业名称是Prefill(预填充)与Decode(解码),这是大模型推理的两个阶段。Prefill把用户输入的整段提示词一次性送进模型,计算出每个位置的Key/Value缓存,属于计算密集型任务,GPU算力利用率高但显存带宽压力相对小。Decode则是自回归地逐字生成,每生成一个Token都要读取全部历史KV缓存,访存量大而计算量小,是典型的带宽瓶颈。两者对硬件的需求截然不同,混跑会互相拖累,因此现代推理框架普遍采用PD分离(Prefill-Decode Disaggregation)架构,用不同规格的机器分别承载,这也是DeepInfer把读题和写字拆到两拨机器上的技术依据。
第二招:算过的不重算
对话前面没变,之前算好的结果直接调出来。缓存池是一个约100PiB的闪存集群:不命中缓存每秒6万Token,命中直接150万,差了25倍。线上96%的请求都能命中缓存。
这正是DeepSeek敢卖便宜的底气。官方价格表上,缓存命中的输入只要0.003美元,未命中是0.15美元,差了50倍。
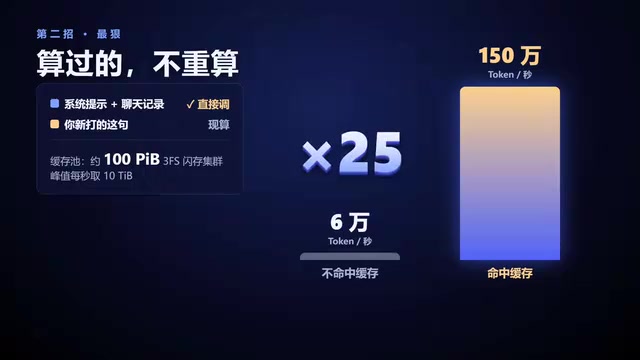
缓存复用的底层机制是KV Cache(键值缓存)。Transformer在生成每个Token时,需要根据之前所有Token的Key和Value计算注意力,若每次都重算,成本随上下文长度线性增长。把这些中间结果存下来复用,就避免了重复计算。多轮对话中,系统提示词和历史轮次往往不变,命中缓存的收益极大。业界常以Prefix Caching(前缀缓存)指代这一思路,难点在于跨请求、跨机器的缓存寻址与淘汰策略,以及在显存、内存、闪存之间做多级缓存分层。DeepSeek把缓存池做成约100PiB的闪存集群,正是用大容量低成本介质换取高命中率,从而把最贵的GPU算力省下来。
第三招:小模型先猜,大模型再验
再叠几招:小模型先猜、大模型再验;384个专家摊到64张卡上,热门专家多备一份。最终每张卡每秒能吐1.4万个Token。
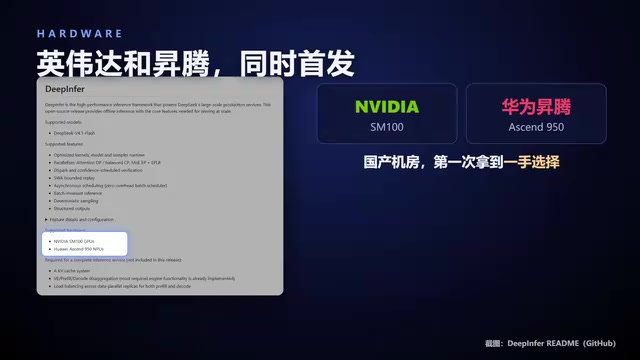
硬件层面同样关键——英伟达和华为昇腾950同时首发,国产机房第一次拿到一手选择。
这一招在学术界称为投机解码(Speculative Decoding)。其原理是先用一个参数量小、速度快的草稿模型连续生成若干个候选Token,再让大模型一次性并行验证这些候选,接受其中正确的部分、拒绝并修正错误的部分。由于大模型验证多个Token的计算成本接近验证一个,整体生成速度可以显著提升而不改变输出分布。业界还有Medusa、EAGLE等变体,用额外的预测头替代独立草稿模型。与之配套的专家并行(Expert Parallelism)则针对MoE架构:把众多专家分摊到多张卡上,热门专家多复制几份以缓解负载不均,这是稀疏大模型推理的关键调度技巧。
没有全交:留了一手
有意思的是,DeepSeek并没有把一切都开源。缓存管理、读写、拆分调度、负载均衡这三块代码没有放出来,只给了设计思路。
这恰恰是推理框架里最贴近业务、最难复制的部分。开源接口和设计、保留核心调度实现,既能让社区跟进,又不至于把护城河一次性填平。
未开源的缓存管理、读写、拆分调度与负载均衡,对应的正是推理框架中最考验工程积累的部分。缓存管理要处理命中判定、跨节点寻址、容量淘汰与一致性;拆分调度要决定每个请求走Prefill还是Decode、分配到哪台机器、如何排队与抢占;负载均衡则要在专家分布不均、请求长短差异巨大的情况下避免个别卡成为瓶颈。这些逻辑与具体硬件拓扑、集群规模和业务流量模式深度耦合,通用性差、调优成本高,往往是各家拉开性能差距的真正所在。只公开设计与接口、保留核心实现,是开源项目中常见的边界划分方式。
DeepSeek图什么
从模型权重、训练框架、算子库、3FS,到今天的推理框架,DeepSeek一样一样往外递。别人追不上前沿,差的不止是模型,还有这套推理功夫——现在它被直接摆在了桌上。
一种解读是真格局,让人人用得起智能;另一种解读是阳谋:带着昇腾一起,把行业标准攥在手里。两种说法并不互斥。开源推理框架能迅速扩大生态采用面,而生态一旦围绕DeepInfer的调度方式和硬件适配展开,标准制定权自然就落到开源方手里。
对开发者来说,短期最实际的变化是:部署大模型的推理成本和延迟门槛被进一步拉低,国产硬件也有了更成熟的落地路径。至于这步棋最终是利他还是利己,答案可能要等下一张桌子被掀开时才清楚。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。