Dify工作流实战:AI产品经理如何用低代码搭建业务流程
面向AI产品经理的Dify工作流入门:从三层抽象结构到珠宝定制报价的完整拆解。
本文系统梳理了Dify工作流的核心概念与实操思路。工作流介于大模型与智能体之间,本质是「稳定输入+人工编排规则+稳定输出」的低代码编辑器,以结果可控换取灵活性的牺牲。Dify分节点、子工作流、大workflow三层抽象,节点对应Agent的tool,子工作流对应skill。通过「买可乐」入门案例,文章揭示了工作流的脆弱性来源(硬规则无法处理自然语言变体),以及引入LLM节点做语义解析后如何弥补这一缺陷。进阶案例以珠宝定制报价为核心,拆解了BOM成本、工艺成本与DFM审核的分层核算逻辑,并指出工艺路线无法跨品类复用。对产品经理的实操建议是:做到demo级别即可,用模拟数据跑通流程逻辑,有硬规则用if-else,无规则才引入大模型节点。
工作流正在成为AI产品经理绕不开的一项技能。它介于大模型与智能体之间,本质上是一种偏向产品视角的低代码编辑器。这篇文章基于B站一堂AI产品经理实操课程的内容,系统梳理Dify工作流的核心概念、节点结构,以及一个真实的珠宝定制报价场景是如何被拆解成工作流的。
工作流、智能体与大模型的边界
很多人分不清工作流、智能体和大模型的区别。用课程里的说法:工作流更偏向于给产品经理使用的低代码编辑器,而智能体则是一个相对灵活的"大模型+工具"运行器。
三者的本质关系可以这样理解——无论大语言模型还是智能体,底层逻辑都是"输入+输出",中间是函数。工作流的特点在于,这个中间过程是由人去做编辑的:稳定的输入,加上稳定的输出,中间是人工编排的规则。这也解释了为什么工作流常被形容为"有多少人工就有多少智能"——它偏死板,但胜在结果可控、稳定。
这种稳定性恰恰契合了供应链等业务场景的需求。课程中反复强调,供应链流程比较吃稳定的结果,所以能用if-else硬规则判断的地方,就不要轻易替换成大模型节点,否则输出会变得不稳固。
Dify的安装与部署选择
Dify是市面上比较常见的开源工作流工具,同类产品还有扣子(Coze)里的工作流模板以及n8n。它提供两种部署方式:
- 云端SaaS版:免费,功能完整,直接在官网注册即可使用
- 本地社区版:需要借助Docker部署,还有面向企业的企业版
课程给出了一个很实在的建议:Windows用户不建议折腾本地Docker安装,因为门槛较高(早期需要开启WSL)。实在想本地部署又搞不定的,可以让智能体帮忙装Docker、拉镜像。对大多数学习者来说,直接用云端版是最省事的选择,功能一样全。
Docker是一种容器化技术,可以将应用程序及其所有依赖打包成一个独立的「容器」,在任意系统上一键运行,无需手动配置环境。对于Dify本地部署来说,Docker的作用是把Dify的后端服务、数据库、向量存储等多个组件一并封装,用一条命令(docker-compose up)即可启动全套服务。WSL(Windows Subsystem for Linux)是Windows内置的Linux兼容层,早期版本的Docker Desktop在Windows上必须依赖WSL才能运行,这也是课程建议Windows用户直接使用云端版的原因——本地部署涉及WSL开启、Docker安装、镜像拉取等多个步骤,对非开发背景的产品经理来说门槛较高。n8n是另一款开源工作流自动化工具,与Dify的主要区别在于n8n更偏向系统集成与自动化触发(类似Zapier),而Dify的工作流更强调与大模型的深度结合以及对话式应用的构建。
工作流的三层抽象结构
理解工作流,关键是看懂它的分层结构。
节点层是最基础的单元。开始、用户输入、HTTP请求、条件分支、大模型(LLM)、人工介入等等,每一个都是独立节点。以HTTP请求为例,正常要靠代码来写,但在Dify里可以直接把后台编辑好的模板拖过来,用低代码形式配置即可。
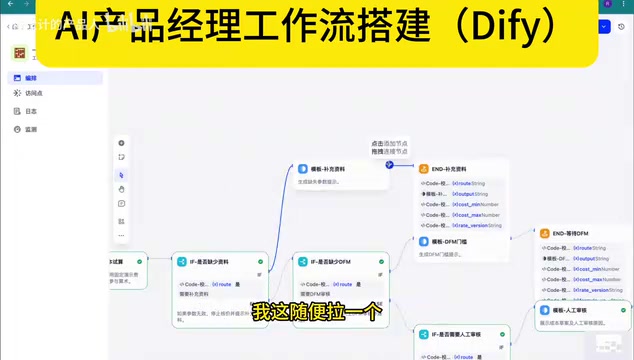
子工作流层是节点的聚合。比如"人工介入→条件分支→调大模型→前置条件分支"这一整条链路,就构成一条子工作流。整个链路必须是闭环的,最终要接一个输出节点。
大workflow层则是多条子工作流的整体聚合。
课程做了一个巧妙的对照:如果和智能体(Agent)比较,工作流里的单个节点对应Agent中的一个tool(工具),而子工作流则类似于skill(技能),只是调用起来更复杂。这个类比帮助我们理解工作流与智能体在抽象层级上的对应关系。
值得留意的一点是:功能越复杂,需要编辑的链路就越多,节点会呈指数级增长。一个条件分支下接大模型,大模型后再接条件分支,很容易衍生出无限多的节点。而人工介入节点通常作为兜底策略存在——所有工作流都应该设计一个兜底规则。
从买可乐到价格核算:入门案例拆解
课程用了一个极其接地气的例子来讲解工作流的三层逻辑:去便利店买可乐。
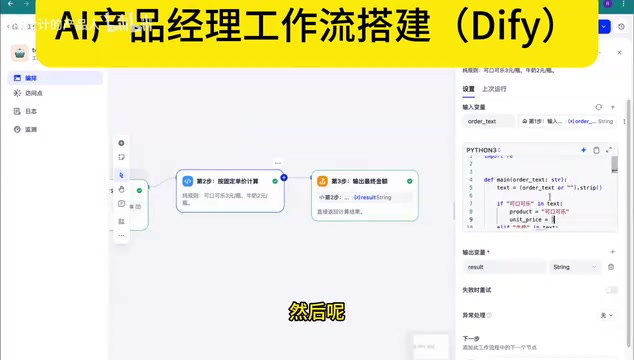
用户说"我要买三瓶可乐",老板脑子里做的事情拆成工作流就是:输入层(用户需求)→ 规则层(维护价格表 + 根据数量计算总价)→ 输出层(告知应付金额)。
实际演示中,"我买两瓶牛奶"最终输出"两瓶牛奶等于四块钱",因为价格表里牛奶单价是两块。这一层用code节点实现,逻辑就是瓶数乘以单价。
这个案例最有价值的地方在于揭示了工作流的脆弱性。当用户输入"我买三个可口可乐"时,系统返回"没看懂数量"——因为规则里写的单位是"瓶",而用户说的是"个",硬规则取不到。
解法就是引入LLM节点做语义解析。加一个大模型节点,无论用户说"三瓶""三个"还是"三箱",模型都能解析出来(三箱甚至能换算成36瓶),输出稳定的JSON再往下传。这就是工作流灵活性的来源:本身偏死板,但复合上语言模型做自然语言解析后,整体可以变得很灵活。当链路多到if-else枚举不完时,也可以让语言模型来判断该走哪条路径。
珠宝定制报价:一个真实的复杂工作流
课程的核心案例是一个企业级的"一键定制自动合价"需求——用户提交定制需求,系统自动报价。
这个场景要区分两种企业类型:如果供应商直接提供货品价目清单,中间核算就很简单,LLM解析后做加法即可;但如果是2C生产企业,就要考虑三个变量——物料成本、工艺成本、额外定制需求。
用户输入的合价条件包括:物料种类与克重、购买件数、表面工艺、质量档位、是否加急等。这里有个关键的产品思维:这些输入在真实生产中不能直接让用户填,前台工作流之前还要接后端系统(如OMS)把数据取过来,做一层封装。
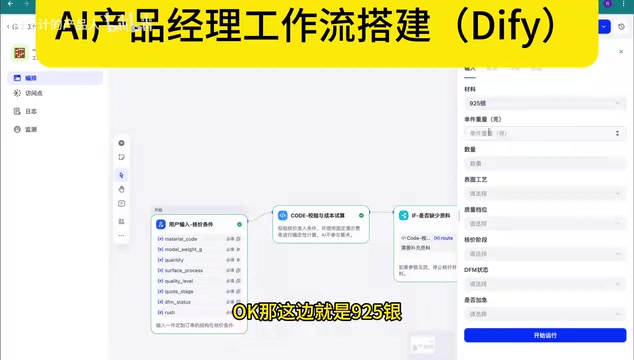
整个工作流分层核算:
- BOM成本:材质 × 重量 × 件数。银价需要引入一个file(价格目录),类似知识库引路。做demo时用虚拟/模拟数据即可,甚至硬编码都行,实际研发会接websearch获取当日材质价格。此外还要考虑损耗率,但损耗不作为用户输入,而是在中间按品类加入。
- 工艺成本:基础工艺路线已在后台硬编排,表面工艺(电镀/哑光/抛光)由用户定制。质量档位分70/80/90分,本质对应每道工序的人员处理时长。
- DFM审核(可生产性检验):这是一个二次报价机制。第一次给初估价,用户完善信息并经人工评估后,再给精准报价。
最终案例中,数据完整、经过DFM评估的订单核算出"成本区间1478元"这样一个非常精准的结果;而未经评估的订单,成本区间会明显更宽。加急订单则触发转人工,走非正常排产流程。
换品类时这套工作流能否复用?课程给了明确答案:BOM物料清单部分可以复用,但工艺路线无法复用——不同材质、不同品类的处理工艺不一样,导致成本规则存在差异。所以不同品类需要搭建不同的工作流。
DFM(Design for Manufacturability,可制造性设计审查)是制造业中的标准环节,指在产品设计阶段就评估其能否被高效、低成本地实际生产出来。在珠宝定制场景中,DFM审核的典型问题包括:设计的镂空结构是否过于脆弱、焊接点数量是否超出工艺承受范围、特定工艺组合是否存在冲突等。将DFM引入工作流的产品意义在于:它把本来需要工程师人工介入的二次评估,变成了一个可被流程化管理的节点——第一次报价是基于用户输入的初估,经过DFM人工或自动审核后才给出精准报价,这种「两阶段报价」机制既降低了因信息不完整导致的报价风险,也为后续生产排期提供了更可靠的成本基准。BOM(Bill of Materials,物料清单)则是制造业中描述一件产品由哪些原材料、零部件、数量构成的结构化清单,是工作流中成本核算的数据基础。
何时用工作流,何时用大模型节点
课程中的问答环节澄清了几个高频疑问,对产品经理尤其实用。
LLM节点 vs Code节点怎么选? 上游如果接的是后端API返回的结构化数据,就直接用code节点,不需要LLM解析用户意图。LLM节点通常只在两种情况下用:一是解析纯自然语言输入(如生产备注转JSON),二是当上游输出不明确、下游分支太多、无法用简单if-else判断时,让模型来做路径决策。
先判断后处理的原则:如果公司有硬规则,就用规则判断;如果没有明确规则,才加大模型节点。因为大模型输出不如硬编码稳固。
是否一定要搭工作流? 取决于需求是否会批量用AI替代人工。像发邮件这类高重复性劳动适合用工作流替代。而研发端最终用硬编码还是工作流,取决于流程是否多变——验证测试阶段用工作流灵活方便,一旦算法灰度出最优方案,往往会转成后端硬编码固化到系统里。
「灰度上线」是互联网产品发布新功能的常见策略,指先将新方案推送给一小部分用户(如5%的流量),收集数据对比新旧方案的效果,确认无误后再逐步扩大覆盖比例直至全量。课程提到算法团队会基于工作流产出的案例数据做灰度,其背后的逻辑是:工作流阶段相当于快速原型验证,用低成本方式跑通业务逻辑;一旦通过灰度对比确认某套决策路径效果最优,再由工程师将其固化为后端硬编码,以获得更好的性能、更强的稳定性和更低的边际成本。这也解释了为什么产品经理的工作流demo不需要接真实API——它的核心价值是验证流程逻辑是否正确,而非替代最终的生产级实现。
给AI产品经理的实操建议
对正在做AI项目的产品经理,课程给出的要求很务实:做到demo级别即可,不要求接真实API,用演示数据跑通输入输出得出正确结果就行。
流程上,先写PRD梳理具体流程,再把流程拆分成节点。三条以上并行分支就多写几个条件判断(在单个条件判断节点里多加班次)。页面原型用code或codex生成HTML交互即可,数据模拟,核心还是放在工作流的后端逻辑上。
这个demo主要给后端或算法看:给后端是演示流程逻辑,后端可能转成硬编码;给算法则通常是提供数据集(含bad case、正常case、中性case),算法会基于20个左右案例产出适配该数据集的工作流,再通过灰度上线对比效果。
还有一个长期积累的心得:产品经理要总结哪些节点是通用的(如自动核价节点尽量在多个工作流复用),但要避免把单套工作流编得太长——链路越长越容易跑不通。
相关推荐
Robinhood高管将亮相TechCrunch Disrupt 2026谈现代金融消费者
Robinhood产品营销副总裁Abhishek Fatehpuria将亮相TechCrunch Disrupt 2026,分享如何赢得现代金融消费者。早鸟报名9月25日前最高省200美元。
用ChatGPT批量生成可编辑学术PPT:科研人的效率工具实战
分享用ChatGPT批量生成可编辑学术PPT的完整流程:只需文献PDF、PPT模板和一段提示词,先出图再拼合转可编辑,半小时完成美观汇报PPT,并对比了ChatGPT与Codex的适用场景。
GPT-6满血版使用教程:通过GPT-work开启Ultra最高思考强度
本文详解如何付费使用GPT-6满血版:从Apple ID注册、Plus/Pro套餐充值,到通过GPT-work客户端工作模式开启GPT-6 Ultra最高思考强度与完整权限,并附网页版隐藏解锁路径。