用ChatGPT批量生成可编辑学术PPT:科研人的效率工具实战
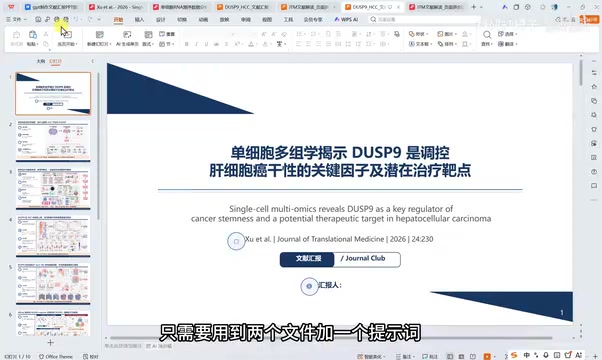
用ChatGPT「图像优先」三步流程,半小时内从文献PDF生成可编辑学术汇报PPT。
本文介绍了一套用ChatGPT批量生成学术汇报PPT的实用流程,核心逻辑是"两个文件+一段提示词":先上传文献PDF和PPT模板,通过结构化提示词让AI用图像生成模型逐页渲染PPT图片,再拼合成完整文件,最后一步转为可编辑版本,全程约半小时。提示词中必须声明"所有配图用图像生成模型",否则产出将极为简陋。模型在参考文献可靠性上已有明显改善,不再像早期那样凭空编造引用,但仍建议人工核查。工具选择上,ChatGPT适合PPT等内容创作任务,Codex则更擅长代码执行与生信流程分析。该方法门槛低、可复现性强,最终产出质量取决于输入模板的精美程度,专业内容解读仍需研究者自行把关。
做学术汇报、组会分享、文献解读,绕不开一件事——做PPT。对于生信、医学等专业的研究生来说,一份既美观又不繁琐的汇报PPT往往要耗费大量时间。B站一位专注生信分析的UP主分享了一套用 ChatGPT(结合 Codex)批量生成高质量学术PPT的完整流程,核心逻辑是「两个文件 + 一段提示词」,全程耗时不超过半小时,且产出的是可编辑版本。
本文梳理这套方法的关键环节,并分析它为何在科研场景中具备实用价值。
核心思路:先出图,再拼PPT,最后转可编辑
整个流程的巧思在于分成三步走,而不是直接让AI一次性输出PPT。
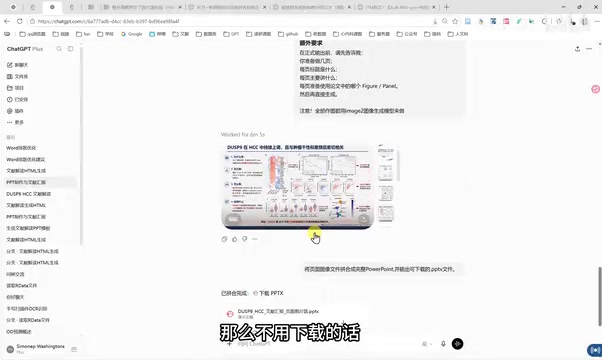
第一步,用 ChatGPT 的图像生成模型(原文称为 image 图像生成)先生成每一页PPT的图片,按固定的 16:9 比例、依照模板样式渲染。这一步决定了最终成品的观感。
第二步,把生成好的页面图像拼合成完整PPT,输出可下载的文件——但此时还是图片形式,不可编辑。
第三步,再补一段提示词,要求「1:1 还原成可编辑版本」,AI 便会把图片PPT转换成文字、图形都能修改的正式PPT。
这套「图像优先」的做法是全流程的关键。UP主特别提醒:提示词里一定要写明「全部做图都用图像生成模型」这句话。如果漏掉,得到的会是一份文字和配图都极其简陋、根本无法用于汇报的精简版PPT;加上之后,产出才会按模板生成美观、排版协调的成品。
需要准备的三样东西
方法本身并不复杂,输入只需三个要素:
1. 一篇文献 PDF
直接把要汇报的文献 PDF 导入 ChatGPT 即可,普通格式的学术文献都能处理。
2. 一份 PPT 模板
UP主使用的是自己之前做单细胞分析流程时手搓的讲解模板,并提到该模板此前已免费分享。他建议大家可以找一些更精美的现成模板,甚至同时准备多个模板做输入输出测试,比较后选定效果最好的一个长期使用。
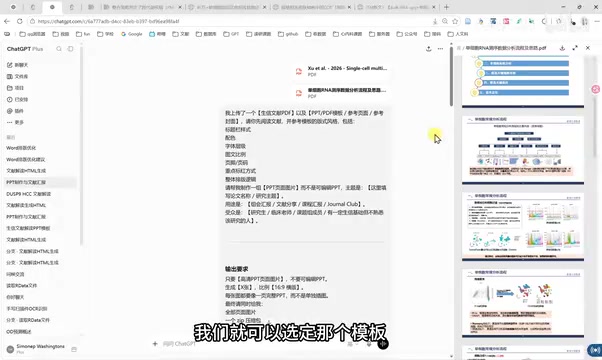
3. 一段较长的提示词
提示词虽长,但结构清晰,包含几个层次:
- 背景说明:告知AI已上传PDF与模板,任务是制作PPT;
- 用途与受众:例如组会汇报、文献分享,受众是有一定生信基础的研究生——这一点需要结合自身领域调整,加入专业要求;
- 输出要求:先只要PPT图片、固定 16:9 比例、指定页数,最终打包成压缩包,附带一份演讲稿和每页说明;
- 内容结构:研究背景、研究思路、数据来源与方法、结果解读、创新点、局限性、参考文献等;
- 图像生成声明:强制所有配图用图像生成模型完成。
参考文献不再「胡编」
值得关注的一个变化是文献引用的可靠性。UP主反复强调,现在让 ChatGPT 帮忙查找参考文献,结果「非常可靠」,找到的都是真实文献,而不像早期版本那样会凭空编造虚假的引用条目。
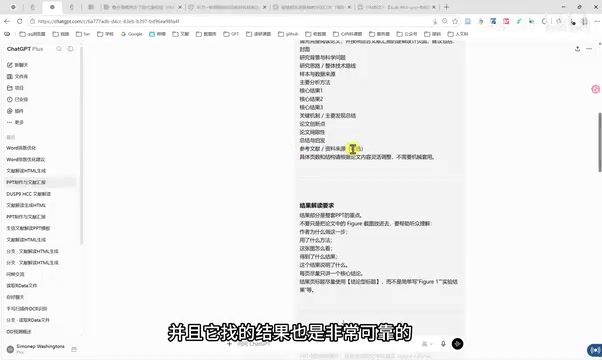
对科研工作者而言,这是一个重要的信任门槛。学术汇报中虚构文献是硬伤,模型在事实性引用上的改进,直接决定了它能否真正进入科研工作流。当然,实际使用中仍建议人工核对每一条引用。
早期大语言模型的"幻觉"(Hallucination)问题在学术引用场景中尤为危险。模型在训练时学习了大量论文写作格式,因此能生成格式完全正确、看似真实的参考文献条目——包括作者姓名、期刊名称、卷期号、年份——但这些信息可能是模型根据模式"拼凑"出来的虚构内容,在真实数据库中查无此文。这一现象曾导致多起学术丑闻,包括律师提交含虚假引用的法庭文书等事件。近期模型可靠性的提升,主要来源于检索增强生成(RAG)技术的引入以及对事实核查能力的专项强化,使模型在引用文献时更倾向于调用已索引的真实内容,而非凭空生成。即便如此,"看起来真实"与"确实存在"之间仍有差距,在正式学术场合逐条通过 PubMed、Google Scholar 等数据库核实仍是必要步骤。
ChatGPT 与 Codex 的分工差异
视频中也对比了用 Codex 生成PPT的效果,结论比较明确:做PPT优先用 ChatGPT,而不是 Codex。
原因有两点。一是速度:Codex 运行常常很慢,有时跑20分钟甚至一个小时。二是效果:UP主实测用 Codex 把图片PPT转成 1:1 可编辑版本时,产出「非常简短」,质量明显不如 ChatGPT。
他给出的定位建议是:ChatGPT 在文字处理上更强,适合做PPT这类内容生成任务;而 Codex 的强项在于执行类工作,比如跑代码、跑分析、跑单细胞流程(scRNA-seq pipeline)等,各有各的用武之地。
Codex 是 OpenAI 专门针对代码理解与生成训练的模型系列,其底层架构基于 GPT,但在大量代码语料上进行了专项微调,因此在执行结构化、逻辑严谨的程序任务时表现出色。它是 GitHub Copilot 早期版本的技术基础,擅长将自然语言描述转化为可运行代码。在 ChatGPT 的工具调用体系中,Codex 主要承担"执行层"角色——当任务需要实际运行脚本、调用文件系统、处理数据分析流程时,Codex 会被调度介入。这也解释了为何它在 scRNA-seq 等生物信息分析流程中有优势:这类任务本质上是代码执行而非内容创作。而PPT制作属于典型的自然语言理解加内容生成任务,ChatGPT 的通用语言能力更契合这一场景,两者分工本质上是"创作型任务 vs 执行型任务"的边界划分。
实用价值与需要注意的地方
从生产效率看,这套方法把一份学术汇报PPT的制作时间压缩到半小时以内,其中生成图片的两个环节分别约6-8分钟,对经常要做组会汇报、文献解读的研究生和科研团队来说确实能省下不少重复劳动。
不过也要理性看待几点:
- 模板质量决定上限:产出好不好,很大程度取决于输入的模板是否精美,值得多花时间挑选和测试。
- 专业内容需人工把关:AI对文献的解读、创新点和局限性的提炼,仍需研究者自己校对,避免理解偏差。
- 引用务必核实:即便模型可靠性提升,参考文献仍应逐条核查。
总体而言,这是一个门槛低、可复现性强的AI科研办公技巧。真正的价值不在于「一键生成」,而在于把AI当成排版和初稿助手,把研究者从繁琐的美化工作中解放出来,专注于内容本身。
相关推荐
无需框架:用Python+Ollama打造本地ReAct AI Agent
不依赖 LangChain 等框架,用纯 Python 配合本地 Ollama 从零打造具备工具调用能力的 ReAct AI Agent。100% 本地运行、无需 API 密钥,深入理解智能代理的推理循环与消息管理机制。
海外博主实测DeepSeek新Flash模型:KV缓存效率暴涨337倍
海外博主实测DeepSeek新Flash模型,KV缓存效率相比V1提升337倍。文章详解其架构重构、视觉生成、原生目标检测与AutoML能力,以及harness选择对性能的关键影响与实际适用场景。
DeepSeek V4.1 Flash编程工具实测:原生图像与缓存复用大升级
DeepSeek V4.1 Flash编程工具链迎来重大升级,新增原生图像输入、缓存复用优化、文件预览与智能体控制。本文详解开源Harness架构、安装配置及两个实测案例。