DeepSeek V4.1 Flash编程工具实测:原生图像与缓存复用大升级
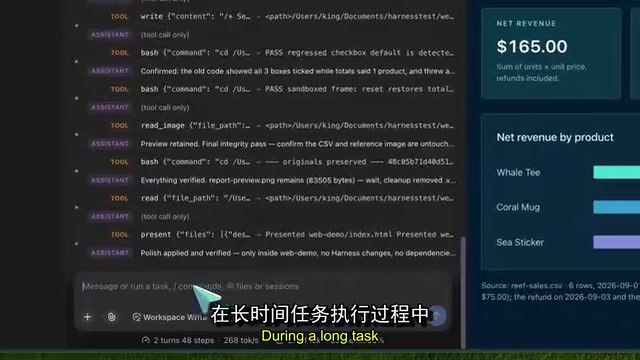
DeepSeek Harness 0.1.5 RC1集成V4.1 Flash,带来原生图像支持、缓存复用优化与更精细的智能体控制。
DeepSeek更新了其开源编程工具链Harness至0.1.5 RC1,核心变化围绕V4.1 Flash模型集成展开。Harness是运行于模型之外的软件层,决定工具调用、文件编辑与智能体协作方式,同一模型在不同harness下的基准成绩可相差数个百分点。本次更新引入原生图像输入(可将设计稿或报错截图直接送入模型)、长任务中指令变更后的缓存复用优化(显著降低输入成本)、新文件预览侧边栏,以及对子智能体的实时控制能力。两个实测案例验证了计算Bug修复(约1分20秒)和图文报告生成(约6分钟)的可用性,输入缓存命中率均在90%以上。该版本仍为开发者预览阶段,HTML应用内预览等细节问题尚待解决。
DeepSeek为其自研的编程工具链(harness)更新了V4.1 Flash集成,改动远不止在模型菜单里加一个新选项。截至发布时的最新版本为0.1.5 Release Candidate 1,仍属于开发者预览阶段。这次更新把过去一周陆续上线的多个功能与新的Flash集成整合到了一起,涵盖原生图像支持、更聪明的指令变更处理、更实用的文件预览系统,以及对执行任务的智能体(agent)更细的控制权。
什么是Harness,为什么它比模型更值得关注
所谓harness,是围绕模型运行的软件层。它决定模型能调用哪些工具、文件如何被编辑、对话如何延续,以及多个智能体之间如何通信。模型负责做决策,而harness把这些决策转化为在你电脑上真实发生的操作。
DeepSeek广告 Harness采用MIT许可证开源,设计上把各类能力拆成插件——模型连接、工具、存储甚至界面都能被单独替换,开发者无需重建整个应用就能改动某一部分。这种可插拔架构是它区别于封闭式编程助手的核心。
最关键的一点在于:surrounding software(周边软件)本身就会显著影响模型表现。据DeepSeek技术报告披露的对比数据,使用同一checkpoint、同为max effort设置时,其精简版harness在DeepStop UE上得分72.6,而OpenCode仅为65.5。换句话说,同一个模型套在不同的harness里,成绩可以相差数个百分点。这也是DeepSeek强调harness的原因——它的技术报告提到模型是在包括自家OpenCode、Py以及若干ClaudeCode变体在内的多个环境中通过强化学习训练的,而非只为单一应用服务。
需要说明的是,这些是DeepSeek发布的研究结果,并非UP主对本次RC版本的实测数据。
DeepStop UE(DeepSeek Open Source Benchmark for Unified Evaluation)是DeepSeek用于评估编程智能体能力的基准测试集,涵盖代码生成、调试、多步骤任务执行等场景。它区别于SWE-bench等通用基准的关键在于:DeepStop UE明确考察智能体与harness协同运作的整体表现,而非孤立测试模型的语言能力。这也是为何同一checkpoint在不同harness下会产生显著分差——基准本身就在测量"模型+工具链"这一整体系统。OpenCode是另一种常见的开源编程智能体框架,二者的对比数据来自DeepSeek官方技术报告,反映的是受控实验结果,并非第三方独立复现。
三项核心改进:模型ID、思考强度与缓存复用
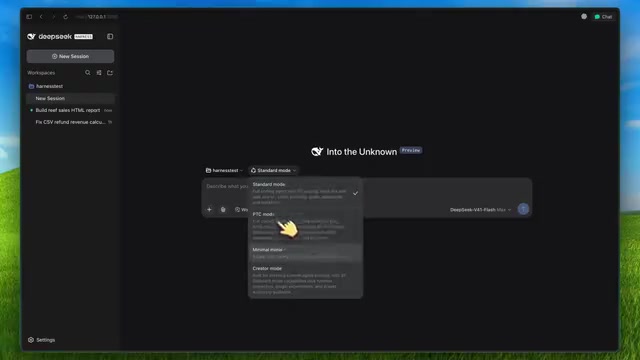
本次最直接的模型层变化是支持官方模型ID deepseek-flash。新建会话默认使用V4.1 Flash,但显式配置过的模型优先级更高——如果你此前保存过特定模型,更新应用不会自动替你切换。
思考(thinking)设置同样值得留意。thinking默认开启,且默认强度为high。Max档位需要手动选择,high与max是两个不同的设置,对应不同的成本和响应时间。UP主强调,在此前的模型测试中,thinking设置带来的差异非常大,因此评测前必须确认这一项。
最有意思的是缓存(cache)的处理。在长任务中,harness有时需要修改自己的指令。以往改动对话开头会导致后续的缓存历史无法复用。针对V4.1 Flash,harness可以把更新后的系统指令追加到已有历史之后——模型使用最新的系统消息,而早前的对话内容仍然符合缓存复用条件。
这对携带大量上下文的长任务尤其有用,能同时改善效率和成本。但这并不意味着每次请求都能命中缓存——改动工具或请求的其他部分仍会影响复用。
缓存复用(cache reuse / prompt caching)是大语言模型API中一项重要的成本与延迟优化机制。当请求中的前缀部分(通常是系统指令和早期对话历史)与此前某次请求完全一致时,服务端可直接复用已计算的KV缓存,无需重新处理这些token,从而降低输入token计费并减少首token延迟。问题在于,一旦前缀被修改(例如更新系统提示),其后所有内容的缓存都会失效。本次harness改进的核心思路是:把更新后的系统指令追加到历史末尾而非插入开头,使历史前缀保持不变,从而让已缓存的大段上下文继续命中缓存。这对动辄数万token的长编程任务来说,能带来可观的成本节省。
原生图像输入:把设计稿和报错框喂给模型
Flash通过官方适配器支持图像输入,使截图真正融入编程工作流。模型可以在你的指令之外,检视一张设计图、一个报错对话框或一张图表。这属于图像理解能力,输出仍以文本、代码和工具操作的形式呈现。
安装与配置:面向开发者的预览版
UP主在Mac上安装了官方NPM包,包名为 @deepseek-ai/dsh,实测版本正是0.1.5 RC1。可以通过NPX启动Web界面,也可用NPM全局安装。
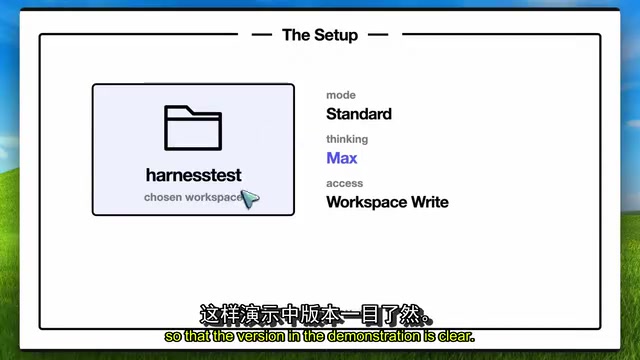
对Node版本有要求:需要node 22.19或22系列的更高版本,或node 24及以上。安装完成后运行 dsh-web,会在本地(默认3080端口)启动Web界面并在浏览器打开。--no-open 参数可以只启动服务而不再开新窗口。此外还有headless模式,可从终端直接跑单个任务,适合交给它做修复工作后用自己的测试验证结果。
两个实测案例:Bug修复与图文报告生成
第一个案例是一个含两个计算Bug的销售报表项目——取消订单和退款被错误统计。项目原有8个测试,5通过3失败,另有一份已知正确总额的样本CSV。DeepSeek定位到问题并修改了计算模块,8个测试全部通过,且未改动测试和数据本身。修复前报表显示净额108.06美元,修复后正确显示65.05美元。整个agent回合在max thinking下约耗时1分20秒——一次可验证的有效修复。
第二个案例中,UP主上传了一份销售CSV和一张展示目标报表布局的图片,要求生成HTML报告和独立的计算说明。模型产出了 index.html 和 calculations.md 两份文件,页面自包含且总额正确(净收入165美元、18个净单位、3款产品),布局也贴合参考图。完整Web任务耗时接近6分钟,其间首次浏览器验证一度卡住,随后自行恢复。
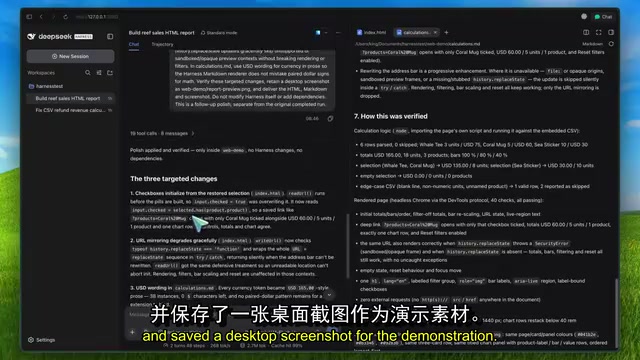
UP主给出一条重要提醒:复现时务必把两类输入分开。布局截图里的图表长度或数值可能只是占位示意,报告必须依据真实源数据来计算。
文件工作流与智能体控制的实用升级
文件工作流有明显改善。较早的更新增加了任意文件类型的上传,带进度条和取消功能,上传期间还能切换对话。不过上传电子表格或文档,不代表模型自动理解每种格式——agent是通过可用工具去读取和处理文件的。
新的侧边栏让输出审阅变得容易许多,可在应用内预览Markdown、代码、HTML、PDF和图像,支持标签页、分屏和全屏。不过UP主也如实指出:在其环境里,Markdown和图像预览正常,但HTML预览在应用内浏览器中显示空白,而同一份HTML在Chrome中能正常渲染。
对续跑子智能体的控制也是一大进步。你可以排队新指令、在下发前编辑、删除,或在agent工作时实时纠偏,甚至停止它。当任务中途改变方向时,能针对性地纠正某个agent的行为,比等一切跑完再动手实用得多。此外还有实验性的agent团队安装包,但需要显式启用配置——更新harness并不会把每个任务都变成多智能体协作,而更多agent意味着更多API请求。
可靠性改进与性能观测
底层还有若干可靠性修复。R-seq流式修复在后续响应块出现空字段时,会保留工具调用的名称和标识符,避免原本有效的请求变成失败的工具调用。
近期更新还改善了断连后的重连、降低了打开或续跑长对话时的延迟。界面现在把统计信息归纳为轮次和速度摘要,并提供详细的token用量和缓存命中率。
从UP主对两次原始演示的日志观测:修复任务的输出速度约242 tokens/秒,Web任务约269 tokens/秒,加权平均约262 tokens/秒(含推理token);若把每次请求开始的等待时间也算进去,综合速率约136 tokens/秒。输入缓存命中率分别约为92.5%(修复)和97.8%(Web)。这些均为客户端观测值,不构成对速度或成本的通用结论。
此外,会话格式升级到version 3,旧日志会被迁移且原文件保留,但旧版应用无法读取升级后的会话,插件作者也需适配API变更。
R-seq(Response Sequence)是流式输出协议中用于标识工具调用顺序与身份的字段机制。在流式响应中,模型的输出会被分割成多个数据块(chunk)逐步传输。若某个中间块出现空字段(如工具名称或调用ID缺失),客户端在拼接时可能无法将后续块归属到正确的工具调用上,导致整个请求被视为失败。R-seq流式修复的意义在于:即使中间块携带不完整信息,harness也能依据序列标识符正确恢复工具调用的上下文,避免因传输层的微小异常而丢弃原本有效的模型输出——这在网络波动较大的环境中尤为重要。
结语:开源可检视,但账单仍需自付
这次更新的真正价值,在于提供了一个能充分利用Flash特定能力、同时让产出更易检视的开源应用。你仍要为模型用量付费——max thinking、重复的工具调用和多智能体都会推高账单,而可复用的上下文则有助于降低输入成本。
在两个演示中,它修好了计算逻辑,也产出了数字正确的报告,对这个RC版本而言是不错的开局。拥有真实文件、既有测试和会话日志来评判工作质量,是这套工具值得肯定的地方——但在做更广泛的横向对比之前,仍需要在更大的项目上继续测试。
相关推荐
Qwen 27B 本地部署实测:开源大模型能否替代 GPT-4?
Qwen 27B 开源大模型本地部署实测:一条命令用 Ollama 安装,混合注意力支持 262K 长上下文,代码审计任务响应快于 GPT-4,三年成本对比显示本地方案更省钱。开发者本地 AI 部署完整指南。
177B大模型跑在廉价显卡上?Qwen3 Flash Next本地部署实测
B站UP主实测用两块廉价显卡加32GB内存本地运行177B参数的Qwen3 Flash Next模型,通过将51B Ngram表卸载到SSD,实现22 tokens/s推理速度。本文解析其架构拆分、llama.cpp部署参数与性能表现。
MiniMax H3登陆Draw Things:Mac/iPad本地跑开源最强音视频模型指南
开源最强音视频模型MiniMax H3已在苹果AI工具Draw Things正式支持。本文详解首尾帧与参考生成两种版本、加速LoRA选择、M系列芯片硬件门槛及LLM提示词技巧,帮Mac/iPad用户判断能否本地运行。