Qwen 27B 本地部署实测:开源大模型能否替代 GPT-4?
Qwen 27B开源模型借助Ollama可一键本地部署,混合注意力支撑262K长上下文,三年高频使用可比云端API节省约1300美元。
本文基于一则视频演示,系统梳理了将Qwen 27B开源大模型本地部署的可行性与经济账。在安装门槛上,Ollama已将流程简化为一条命令、5.6GB下载;进阶用户可通过llama.cpp源码编译获得完全控制权。硬件方面,量化技术(如Q4)让RTX 3090/4090级别的消费级显卡足以承载27B参数模型。技术上,混合注意力机制将约75%的注意力层复杂度从O(N²)降至线性,支撑262K token超长上下文。在单一代码安全审计任务中,本地模型以8.1秒响应快于GPT-4的12.3秒,并给出CVSS评分与OWASP映射,但单样本结论需谨慎。三年成本对比显示,高频使用场景下本地方案可节省约1300美元,但前提是具备约1616美元的一次性硬件投入。
为什么要考虑本地部署开源大模型
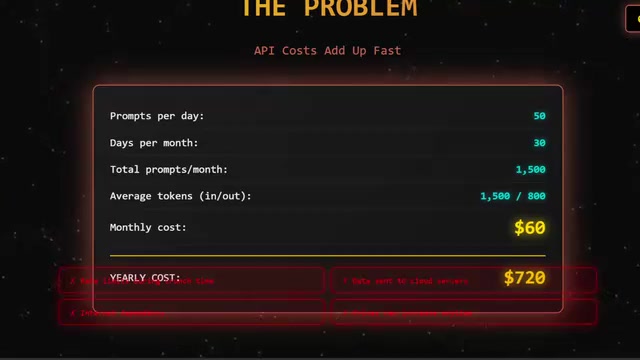
依赖云端 API 调用商业大模型,长期来看是一笔不小的开支。以视频中的使用场景为例:每天 50 个提示词,一个月 1500 次提问,订阅费用约为每月 60 美元。折算到三年,仅 API 支出就接近 720 美元(视频估算数据,实际因使用量而异)。
除了成本,云端调用还带来一系列隐性问题:请求限流、数据需要上传云端存在隐私顾虑、依赖网络稳定性、以及服务价格可能随时上调。对于高频调用的开发者而言,这些痛点叠加起来,本地部署的吸引力就凸显出来了。
这也是这款 270 亿参数(27B)、采用 Apache 2.0 许可协议的开源模型受到关注的原因——它允许在自己的硬件上完全自主运行,规避了上述大部分问题。
注:视频中反复提及的「Queens / Meet Queens」,从技术特征(27B 参数、Apache 2.0、混合注意力、Ollama 拉取)判断,应为阿里通义千问广告 Qwen 系列模型的口误或字幕转写误差,本文按 Qwen 理解。
安装到底有多简单
视频演示的核心卖点之一,是本地部署的门槛已经大幅降低。借助 Ollama,理论上一条命令即可完成模型拉取——本次演示中下载的模型体积约为 5.6GB,几分钟内就能让本地 AI「跑起来」。
对于追求更高控制权的进阶用户,还有另一条路径:从源码编译。具体做法是克隆 llama.cpp 代码库,配置 CUDA 支持后自行编译,再从 Hugging Face 下载对应模型权重。这种方式虽然步骤更多,但能获得对推理引擎和模型的完全掌控,便于后续做量化、微调等定制化操作。
硬件门槛:需要什么样的显卡
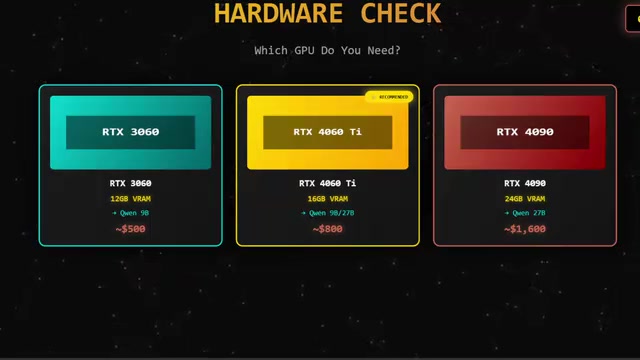
本地跑 27B 模型,显卡是绕不开的话题。视频给出了几档预算参考:
- 性价比之选:RTX 3000 系列,适合入门尝试
- 高端型号:RTX 4000 系列、4060 Ti 等,兼顾性能与价格
- 发烧级:RTX 4090 及 24GB 大显存卡型,可支撑 24 小时长时间稳定推理
显存大小直接决定了能否加载完整模型以及支持多大的上下文窗口。对于 27B 规模的模型,通过量化(如 Q4)可以显著降低显存占用,让消费级显卡也能负担。想要原生高精度运行,则需要更大的显存预算。
量化(Quantization)是让大模型跑在消费级显卡上的关键技术。模型权重默认以 FP16(16位浮点)或 BF16 格式存储,一个 27B 参数模型约需 54GB 显存,远超普通显卡。量化将权重精度压缩到更低的比特位——Q4 即4位量化,意味着每个参数只占4比特,27B 模型的显存占用可降至约 14-18GB,RTX 3090 或 RTX 4090 的 24GB 显存便能容纳。llama.cpp 原生支持 GGUF 格式的多档量化(Q2 至 Q8),精度越低显存越省但输出质量可能下降。实际使用中 Q4_K_M 是常见的平衡点,在可接受的质量损失范围内大幅降低硬件门槛。Ollama 在拉取模型时默认使用量化版本,因此 5.6GB 的下载体积正是量化压缩后的结果,而非原始全精度权重。
实测对比:Qwen 27B vs GPT-4
视频用一个实际的代码安全审计任务做了横向对比:一段存在缺陷的 JWT 验证函数(时间戳比较逻辑有问题)。
结果显示:
- GPT-4 响应耗时约 12.3 秒
- Qwen 27B(本地) 响应耗时约 8.1 秒
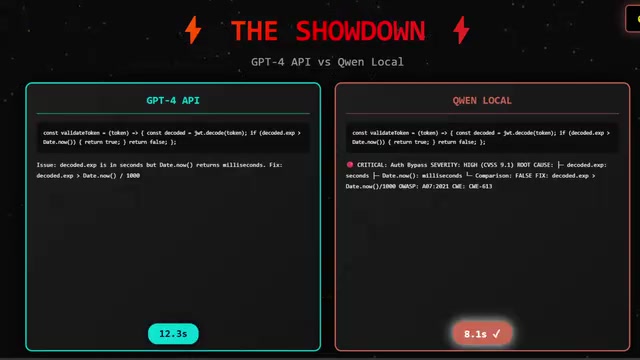
在分析质量上,本地模型不仅速度更快,还给出了较为完整的安全分析——标记出 CVSS 评分并映射到 OWASP 分类。视频给出的结论是本地模型在这一任务上「更快、更深、免费」。
需要客观看待的是,这只是单一任务、单一样本的对比,不能代表两个模型的整体能力差异。代码审计、推理、创意写作等不同任务上的表现可能大相径庭,真正的评估需要成体系的基准测试。
CVSS(通用漏洞评分系统)和 OWASP 是安全领域的两套标准体系。CVSS 由 FIRST 组织维护,对漏洞的攻击向量、复杂度、影响范围等维度打分,最终给出 0-10 的严重性分值,是业界评估漏洞危害程度的通用语言。OWASP(开放式 Web 应用程序安全项目)则维护着「Top 10」漏洞分类列表,将常见 Web 安全问题归纳为 A01 权限控制失效、A02 加密失败、A03 注入等类别。本地模型能在代码审计任务中主动引用这两套框架,说明其在安全领域的专业词汇和分类逻辑上具备一定训练深度。JWT 时间戳比较漏洞属于典型的逻辑缺陷,通常映射到 OWASP A07(认证和授权失败)类别,CVSS 评分因上下文不同一般在 5-8 分区间,视频中模型能给出此类结构化输出是其被认为「分析更深」的具体依据。
技术亮点:混合注意力如何撑起长上下文
27B 模型能在消费级硬件上支持超长上下文窗口,关键在于注意力机制的改进。
传统 Transformer 的自注意力计算复杂度是 O(N²),上下文越长,显存和算力开销呈平方级增长。当上下文拉到 262K token 时,这个成本几乎不可承受。
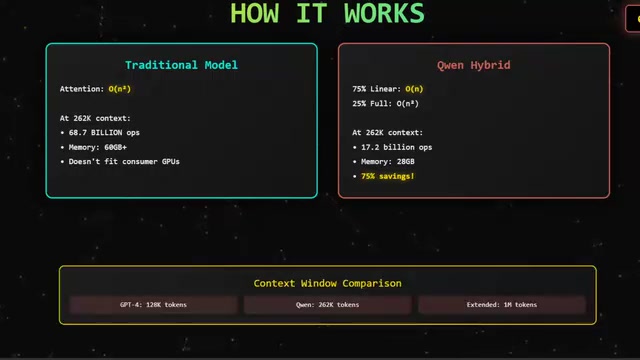
视频指出,该模型采用了混合注意力方案,其中约 75% 的注意力层使用线性复杂度,从而将长上下文场景下的计算开销大幅压缩(节省约 75%)。这正是它能在有限显存下处理超长文档、长对话的核心技术支撑。
混合注意力(Hybrid Attention)通常指将标准的全局自注意力(Softmax Attention)与线性注意力或局部注意力机制交替堆叠的架构设计。全局自注意力能精确捕捉任意位置之间的依赖关系,但复杂度为 O(N²);线性注意力通过核函数近似将复杂度降至 O(N),代价是可能损失部分精度。将两者以一定比例混合,可以在精度与效率之间取得平衡——大量不需要全局感知的层使用线性注意力节省开销,少数关键层保留全局注意力维持表达能力。Qwen 系列在长上下文版本中采用类似思路,配合 GQA(分组查询注意力)等显存优化技术,使得单张消费级显卡也能在合理延迟内处理数十万 token 的超长文档。理解这一机制有助于判断该模型适合哪类任务:超长代码库分析、长文档摘要等场景能充分发挥其优势,而对极高精度推理依赖全局上下文的任务,线性注意力层的近似误差可能产生一定影响。
三年成本账:省下多少钱
把时间拉长到三年来算这笔账,本地部署的经济性会更清晰:
| 方案 | 前期投入 | 年度费用 | 三年总计 |
|---|---|---|---|
| GPT-4 API | 0 | 约 240 美元 | 约 720 美元 |
| Qwen 本地 GPU | 约 1616 美元 | 约 16 美元(电费等) | 约 1648 美元 |
视频的核心论点是:虽然本地方案前期需要一次性硬件投入,但运行成本极低,长期使用后「基本免费」。按其估算,相比持续付费的云端方案能省下约 1300 美元,且一年之后硬件投入基本摊平。
这个账的前提是高频、长期使用。如果调用量小,云端 API 的按量付费反而更划算——硬件折旧、电费和维护成本都需要计入综合考量。
总结与展望
开源大模型 + 本地部署的组合,正在为开发者提供一条摆脱云端依赖的可行路径。Qwen 27B 凭借 Apache 2.0 的宽松许可、混合注意力带来的长上下文能力,以及在消费级显卡上的可运行性,成为值得关注的选项。
不过,本文引用的性能与成本数据均来自单一视频演示,样本有限,实际效果请以自己的场景实测为准。对于计算调用量大、注重数据隐私、且具备一定硬件条件的团队,本地部署确实是一个越来越现实的选择。
视频作者还预告了后续内容,包括模型微调、9B 与 27B 的基准测试对比、以及高级 RAG 管道搭建——这些正是本地大模型落地过程中最值得深入的方向。
相关推荐
DeepSeek Harness渗透测试模式实测:AI辅助漏洞挖掘的能力与边界
本文解析基于DeepSeek Harness渗透测试模式与专用SKILLS技能包的AI辅助漏洞挖掘工作流,涵盖信息收集、后门RCE、数据库凭证泄露等实测结果,并探讨其成本控制与安全双刃剑效应。
Yue2 音乐模型 LoRA 实测:400 步复刻名人音色
一个基于 Yue2 音乐模型、用 AI-Toolkit 仅 400 步训练出的名人音色 LoRA 在 Reddit 走红。本文解析其技术意义、效果局限与背后的音色克隆版权伦理问题。
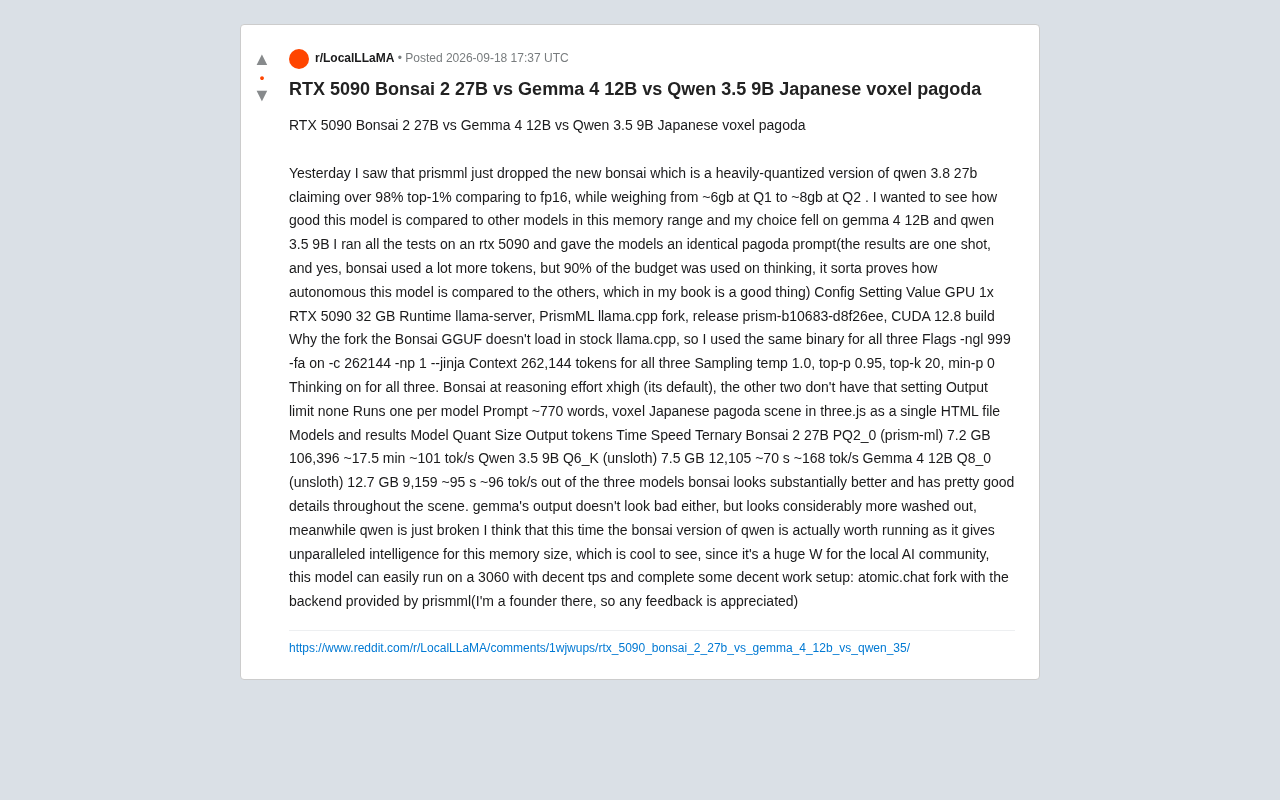
低显存本地大模型对决:Bonsai 2量化版为何胜出
Reddit 用户在 RTX 5090 上横评 Bonsai 2 27B、Gemma 4 12B 与 Qwen 3.5 9B。基于三元量化的 Bonsai 用 7.2GB 显存实现更优的日式体素宝塔渲染效果,展现低显存本地大模型的量化新趋势。