海外博主实测DeepSeek新Flash模型:KV缓存效率暴涨337倍
DeepSeek新Flash模型以337倍KV缓存效率提升为核心,在AutoML、视觉检测等能力上实现跃升,低价高效适合智能体子任务场景。
DeepSeek新Flash模型是对上一代的彻底架构重构,规模扩大近两倍的同时实现了337倍的KV缓存效率提升,大幅降低长时间智能体任务的实际运行成本。实测中最突出的亮点有三:一是成为首个真正擅长AutoML的开源权重模型,能自主完成特征选择、超参调优并无提示地发现数据泄露;二是原生具备目标检测与视觉推理能力,无需外部CV流水线即可完成物体计数和分类,但边界框精度存在偏移;三是在DeepSeek官方Harness的"规划-实现-视觉验证"闭环下,视觉生成质量显著提升。博主特别强调,harness的选择对模型最终表现影响巨大,选错框架将导致严重性能损失。综合来看,该模型绝对能力不及Opus 5等顶尖模型,但凭借极低定价,在视觉分析和编排任务子智能体两类场景下极具性价比。
海外AI博主近期发布了一段深度实测视频,对DeepSeek新推出的Flash模型进行了全方位测试。这次测试的核心结论令人瞩目:新模型在KV缓存效率上相比V1模型提升了惊人的337倍,同时在视觉生成、机器学习自动化、图像目标检测等能力上都有明显跃升。本文基于该实测内容,梳理这款模型的关键特性与实际表现。
架构重构与效率跃升
博主明确指出,这不是对上一代Flash模型的简单迭代,而是一次彻底的架构重新设计。新模型的规模比上一代大了近两倍,但反而更加高效——DeepSeek广告在这次升级中把优化重点放在了KV缓存上。
最直观的数字是:与V1模型相比,新模型的KV缓存效率提升了337倍。这个提升对于运行长时间智能体任务(long agentic tasks)的用户而言意义重大,因为缓存命中率越高,实际计费就越接近缓存价格而非完整输入价格。
在一个实际测试案例中,博主展示了高达99.7%的缓存命中率:总共生成约4000万tokens,其中近3900万tokens都命中了缓存。这意味着用户按缓存价格计费,成本大幅降低。此外,通过API调用时可获得约每秒300 tokens的输出速度。
KV缓存(Key-Value Cache)是大语言模型推理中的核心优化机制。模型在处理输入文本时,会为每个token计算"键值对"(Key-Value对),这些中间计算结果若能被复制并在后续请求中直接复用,就无需重复计算,从而大幅降低计算成本和延迟。对于智能体任务而言,单次会话往往包含大量重复的系统提示、上下文和工具定义——如果这些内容已经命中缓存,实际计费仅为完整输入价格的几分之一(通常低一个数量级)。337倍的效率提升意味着该模型能够识别并复用更大范围、更细粒度的缓存片段,使得长对话和复杂多步任务的实际运行成本接近理论最低值。这对于需要大规模并发调用的生产环境尤为关键。
Harness选择决定性能上限
视频反复强调的一个关键点是:运行模型所用的harness(执行框架)会极大影响最终性能。博主是在本地两台DGX设备上通过DeepSeek官方的"DeepSeek Harness"运行测试的。
他引用了一组对比实验数据:在Terminal Bench 2.1和DeepSuite V1.1等基准下,同一模型在不同harness下的表现差异巨大——DeepSuite V1.1的成绩从69.8%一路波动到74.2%。
"如果你选错了harness,就会从这个模型得到次优的结果。"博主提醒道。他认为DeepSeek Harness的一大亮点在于其工作循环模式:规划(planning)→实现(implementation)→验证(verification),并持续循环。由于模型现在能够使用视觉输入,它可以在实现过程中通过浏览器"看到"自己的输出并迭代修正。
Harness(执行框架)在AI评测和智能体部署中指的是包裹模型调用的"脚手架"代码,负责定义提示词结构、工具调用方式、输出解析逻辑、错误重试机制以及多步骤循环控制。同一个底层模型在不同harness下可能表现出截然不同的能力——这是因为harness决定了模型"如何被使用",而非模型本身的参数。DeepSeek官方Harness的"规划→实现→验证"循环属于ReAct(Reasoning + Acting)范式的一种变体,通过引入视觉验证步骤,使模型能够像人类工程师一样在浏览器中查看自己的输出并迭代修正,而非盲目输出一次性结果。Terminal Bench和DeepSuite等基准测试本身也内置了特定的harness假设,因此跨框架比较分数时需格外谨慎。
视觉生成能力显著提升
博主的第一个测试是让模型实时获取国际空间站(ISS)的位置,并将其渲染在3D地球仪上。结果不仅准确跟踪了ISS位置,还精确还原了昼夜分布——测试时北美处于夜晚、亚洲处于白天,渲染质量相当出色。
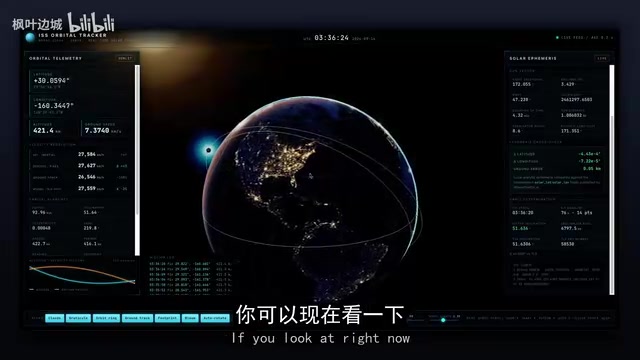
模型在DeepSeek Harness下的完整流程是:先实现,再进行视觉验证,形成"实现-视觉检查-迭代"的闭环。博主还展示了其他几个高质量输出案例,包括可切换一天中不同时段、带有动态云层元素的场景渲染,以及一只在水中游动的海龟——都很好地遵循了提示词要求,视觉设计上比前几代明显更有"品味"。
首个擅长训练机器学习模型的开源权重模型
博主认为最令人兴奋的能力,是这成为首个真正擅长训练机器学习模型的开源权重模型。他提供了一个数据集,只给出简要说明,让模型自行判断如何解决问题。
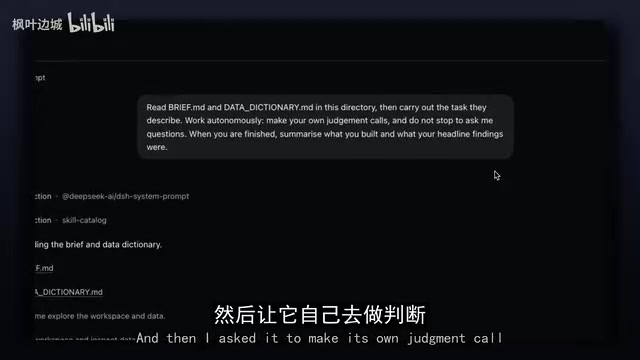
模型的表现堪比一名真正的机器学习工程师:它自主制定方案、进行特征选择、尝试多种不同超参数组合的实验,最终确定最优模型。更值得关注的是,博主故意设置了一个模糊问题,并埋下了一处"数据泄露"(detail leakage)而未加提示,模型竟然自己发现了这个问题并主动丢弃了对应特征。博主表示会专门制作一期关于"用LLM做AutoML"的详细视频。
AutoML(自动化机器学习)是指用算法自动完成传统上需要人类专家执行的机器学习流程,包括特征工程、模型选择、超参数搜索和结果评估。用LLM实现AutoML是一个新兴方向:相比传统AutoML工具(如Auto-sklearn、H2O AutoML),LLM能够理解非结构化的问题描述、生成可解释的决策理由,并在发现数据质量问题时主动干预——正如本次测试中模型自行发现并处理数据泄露(data leakage)的案例。数据泄露是指训练集中包含了在真实预测时本不应该获得的未来信息,会导致模型在测试集上表现虚高、实际部署时严重失准。模型能够无提示地自主识别并丢弃泄露特征,表明其对机器学习原理有相当深度的理解,而非仅仅执行代码生成。
原生视觉检测与推理:无需外部CV流水线
模型另一大亮点是原生具备目标检测能力——可以直接检测图像中的物体、对它们进行推理,并擅长物体计数,而无需任何外部计算机视觉流水线。
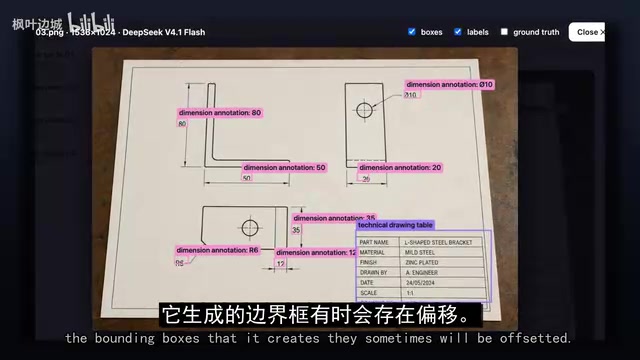
博主基于此构建了一个视觉分析基准测试:让模型直接从技术图纸中提取各部件尺寸,或对图像中的物体进行分类计数。测试显示,模型能准确检测汽车的不同部件,也能对不同类型的水上交通工具准确分类计数。在一个进阶案例中,博主提问"有多少艘船不是帆船,用一个整数回答",模型准确推理出"4艘"。
不过博主也如实指出一个缺陷:模型生成的边界框(bounding box)经常会有偏移。例如某个框并未精确框住数字"20",尽管实际提取的数值是准确的。他提醒,如果做自动化分析评估,需注意边界框可能不完全精确。这些测试是直接API调用的单次预测,并未在harness中运行。
传统的计算机视觉(CV)流水线通常需要将多个独立模块串联:目标检测模型(如YOLO、Detectron2)负责定位物体并输出边界框,分类模型负责识别类别,再由额外逻辑完成计数和推理。这套流水线工程复杂、维护成本高,且各环节误差会累积传导。而多模态大语言模型将上述能力统一到单一模型中,用户可以直接用自然语言描述需求,模型端到端输出结果。边界框偏移(bounding box offset)是当前多模态LLM的普遍局限:这类模型的视觉理解能力主要通过语言token的方式编码空间信息,在精确定位方面天然不如专用检测模型。因此在需要精确像素级定位的场景(如自动标注、工业质检)中需谨慎使用,而在仅需语义理解和计数的场景中则完全胜任。
定位与适用场景
博主坦言这段视频没有讨论传统基准分数,原因是他认为这款模型的绝对能力不如Opus 5等顶尖模型。但他强调:"并不是每个应用都需要最先进的能力。"
凭借极低的价格,这款模型在两类场景下极具竞争力:一是视觉分析任务,便宜且准确度高,可直接通过API使用;二是作为长时间运行智能体中的子智能体(sub-agent),在DeepSeek Harness这样合适的框架下表现出色。综合定价和能力来看,无论是本地部署还是作为编排任务中的子智能体,都是相当不错的选择。
相关推荐
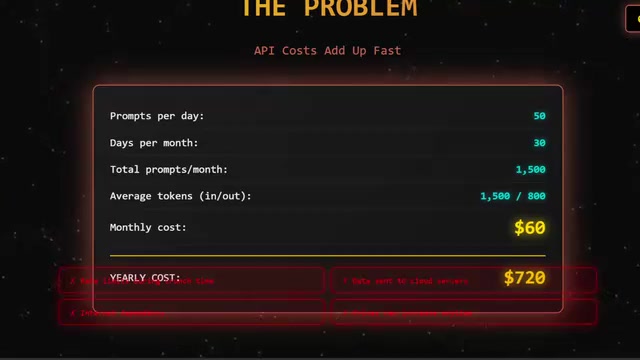
Qwen 27B 本地部署实测:开源大模型能否替代 GPT-4?
Qwen 27B 开源大模型本地部署实测:一条命令用 Ollama 安装,混合注意力支持 262K 长上下文,代码审计任务响应快于 GPT-4,三年成本对比显示本地方案更省钱。开发者本地 AI 部署完整指南。
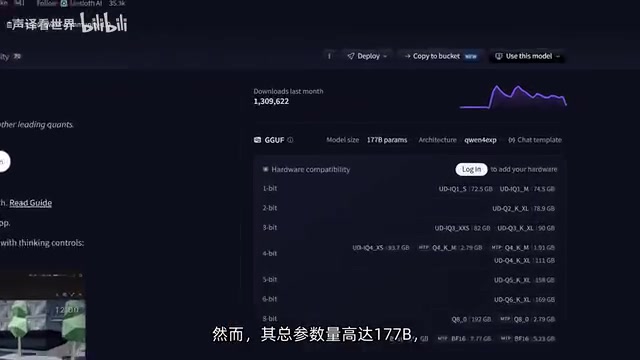
177B大模型跑在廉价显卡上?Qwen3 Flash Next本地部署实测
B站UP主实测用两块廉价显卡加32GB内存本地运行177B参数的Qwen3 Flash Next模型,通过将51B Ngram表卸载到SSD,实现22 tokens/s推理速度。本文解析其架构拆分、llama.cpp部署参数与性能表现。
MiniMax H3登陆Draw Things:Mac/iPad本地跑开源最强音视频模型指南
开源最强音视频模型MiniMax H3已在苹果AI工具Draw Things正式支持。本文详解首尾帧与参考生成两种版本、加速LoRA选择、M系列芯片硬件门槛及LLM提示词技巧,帮Mac/iPad用户判断能否本地运行。