DuckFightClub:AI机器鸭格斗竞技场
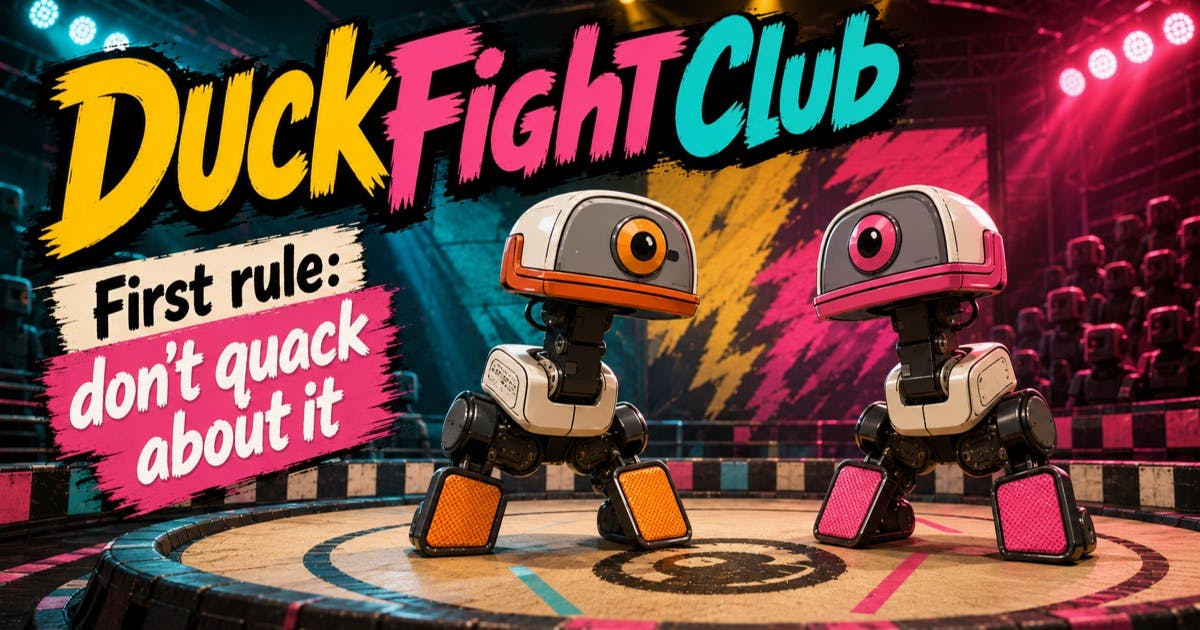
想象一下WWE摔跤比赛,但参赛选手换成了可爱的AI训练机器人——这就是DuckFightClub正在做的事。这个项目将强化学习、开源硬件和电竞娱乐结合在一起,为AI训练提供了一个既有趣又具有实战意义的竞技场景。
专注AI大脑训练而非硬件制造
DuckFightClub的独特之处在于参赛者的任务定位。与传统机器人比赛不同,参赛者不需要从零开始制造机器人硬件,而是专注于训练MicroDuck的"大脑"——即强化学习策略。
强化学习(Reinforcement Learning, RL)是机器学习的三大范式之一,与监督学习和无监督学习并列。其核心思想是让智能体(Agent)在与环境的交互中通过试错来学习最优策略:智能体执行动作、观察环境反馈的奖励信号,并据此调整行为策略以最大化长期累积奖励。这一框架最早由Richard Sutton和Andrew Barto在其1998年的经典教材《Reinforcement Learning: An Introduction》中系统化提出,奠定了现代RL理论的基础。近年来,强化学习因DeepMind的AlphaGo在2016年击败围棋世界冠军李世石、OpenAI Five在2019年击败Dota 2世界冠军OG等标志性成果而广为人知。在机器人控制领域,强化学习尤其适合处理连续动作空间和复杂动力学问题,例如让机器人学会行走、抓取或格斗等动作序列。
然而,在格斗机器人这样的对抗场景中,强化学习训练面临特殊的工程挑战。奖励函数设计(Reward Shaping)是首要难题:如何量化"优秀的格斗策略"?简单地以推倒对手为胜利条件可能导致策略过于保守(一直远离对手以避免被推倒)或过于激进(不顾自身平衡一味冲撞),通常需要设计多目标复合奖励——包括保持平衡、接近对手、有效击打、能量效率等子目标的加权组合。这些权重本身就是一个需要精心调校的超参数空间,微小的权重变化可能导致截然不同的策略行为。此外,对抗环境中策略梯度的方差极大,容易出现训练崩溃或策略循环(即策略A克策略B、B克C、C又克A的Rock-Paper-Scissors Cycling现象),因此PPO(Proximal Policy Optimization)和SAC(Soft Actor-Critic)等具备较好训练稳定性的算法在此类场景中被广泛采用。PPO由OpenAI的John Schulman于2017年提出,其核心思想是通过裁剪概率比率来限制每次策略更新的幅度,防止策略发生灾难性的大幅跳变,属于on-policy方法,实现简洁且调参友好,已成为当前RL领域的"默认基线算法"。SAC则由UC Berkeley的Tuomas Haarnoja等人提出,引入了最大熵强化学习框架——在最大化累积奖励的同时,还鼓励策略保持尽可能高的随机性(熵),这一设计使得智能体在训练过程中持续探索多样化的行为模式,避免过早收敛到局部最优。SAC属于off-policy方法,可以复用历史经验数据,样本效率更高。在格斗场景中,SAC的探索特性尤其有价值——它有助于发现那些非直觉的战术组合,例如先佯装后退再突然发动侧向攻击等出其不意的策略。
MicroDuck是法国机器人公司Pollen Robotics推出的开源机器人平台,该公司成立于2016年,总部位于法国波尔多,此前以Reachy人形机器人在业界闻名——Reachy是一款具有仿生手臂设计的上半身人形机器人,曾在零售、教育和研究等场景中得到广泛应用。MicroDuck定位为小型双足格斗机器人,采用开源硬件设计理念,公开CAD设计文件、电子电路原理图和固件代码。其硬件通常包含多个伺服舵机驱动的自由度关节(典型配置为每条腿3-5个自由度,总共10-12个主动关节),惯性测量单元(IMU)用于姿态感知,以及嵌入式计算单元用于策略推理。值得注意的是,舵机的控制频率(通常在50-500Hz之间)和IMU的数据融合延迟直接决定了策略推理的实时性约束——如果控制环路频率过低,快速的格斗动作将无法执行;如果传感器延迟过高,机器人将无法及时响应对手的攻击动作。这些硬件层面的时序约束,反过来会深刻影响强化学习策略的设计,例如控制频率较低时,策略需要更多地依赖预测性动作规划而非反应式控制。开源机器人平台的关键优势在于可复现性——全球任何团队都可以按照公开的规格制造出性能一致的硬件副本,从而实现算法性能的公平横向比较。
八支队伍将花费数天时间,使用强化学习算法训练各自的控制策略,然后在模拟器中进行对战,争夺"金喙腰带"(Golden Beak Belt)。整个比赛过程通过直播呈现,让观众见证AI策略的实时对抗。
这种设计降低了参赛门槛——你不需要采购零件、焊接电路或调试机械结构,只需要专注于算法和策略优化。同时,统一的硬件平台也确保了比赛的公平性,让竞争回归到AI训练质量本身。在机器人领域,标准平台比赛有着悠久的传统——RoboCup足球赛中的标准平台组(Standard Platform League)就要求所有参赛队使用相同的SoftBank NAO机器人(一款身高58厘米、具有25个自由度的小型人形机器人),从而将竞争焦点完全聚集在软件和算法层面。自1997年创办以来,RoboCup的标准平台组已成为验证多智能体协作算法、实时视觉感知和运动控制策略的重要学术舞台。DuckFightClub继承了这一理念,通过开放MicroDuck的设计规格,有效消除了硬件差异带来的变量干扰,使不同算法的比较更加科学和公平。
从模拟器到实体对战的进化路径
项目采用了"先虚拟后实体"的发展策略。当前阶段,所有对战都在模拟器中进行,这为快速迭代和测试提供了理想环境。强化学习训练通常需要数百万甚至数十亿步的试错交互,在物理世界中完成这一过程可能需要数年时间(以每步0.02秒的控制频率计算,10亿步需要约634年的连续运行时间),而现代物理模拟器可以利用GPU并行化将这一过程压缩到数小时以内,同时避免了实体机器人的磨损和维护成本。
当前机器人仿真领域已形成多层次的技术生态。MuJoCo(Multi-Joint dynamics with Contact)由华盛顿大学教授Emo Todorov开发,2022年被DeepMind收购后宣布开源,以高精度接触动力学模拟著称,特别擅长处理刚体碰撞和摩擦力等复杂物理现象——这些恰恰是格斗机器人场景中最频繁出现的交互类型。MuJoCo采用广义坐标系统和高效的接触求解器,能够在毫秒级时间内精确计算多点接触情况下的力传递和动量交换,这对于模拟两个格斗机器人之间的推撞、抓持和倒地过程至关重要。NVIDIA Isaac Gym(现已演进为Isaac Lab)则利用GPU大规模并行能力,可以同时运行数千个仿真环境实例,将训练吞吐量提升数个数量级——例如,在单块NVIDIA A100 GPU上同时运行4096个机器人仿真环境已成为常见配置,这意味着训练数据的采集速度比单一环境快了约4000倍。此外还有PyBullet(轻量级且易于集成,广泛用于教学和快速原型验证)、Gazebo(与ROS机器人操作系统深度集成,在工业机器人领域应用最广)、Drake(由MIT开发,以严格的数学优化框架著称)等各具特色的仿真平台,共同构成了从学术研究到工业应用的完整工具链。
更令人期待的是项目的长期愿景:当真实的MicroDuck硬件产品发货后,比赛将从虚拟世界转移到现实场地。届时,参赛者可以在自己的城市举办线下对抗赛,将训练好的策略部署到实体机器人上。
这种sim-to-real(从模拟到现实)的转换,本身就是机器人学和强化学习领域的重要研究课题。由于模拟器与真实世界之间存在不可避免的"现实差距"(Reality Gap)——模拟中的摩擦系数、关节间隙、传感器噪声、通信延迟、电机响应特性等参数与真实情况不完全一致——在模拟器中表现优异的策略直接迁移到真实硬件上时往往性能大幅下降,这一现象在学术文献中被称为"sim-to-real gap"。为解决这一问题,业界发展出了多种技术手段。域随机化(Domain Randomization)是最直观的方法之一:在训练阶段系统性地随机化物理参数(如摩擦系数在0.2-1.5之间随机采样、机器人质量上下浮动±15%、推力施加随机外部扰动等),迫使策略学会在广泛的物理条件下都能工作,从而在迁移到真实世界时具备足够的鲁棒性。OpenAI曾在2019年使用极致的域随机化训练出能用机械手解魔方的策略,充分验证了这一方法的有效性。系统辨识(System Identification)则走相反的路线:通过精确测量真实机器人的物理参数(如关节阻尼、电机力矩曲线等),尽可能缩小模拟器与真实世界之间的差距。渐进式迁移(Progressive Transfer)方法则先在粗糙模拟中预训练,再在精细模拟中微调,最后在真实硬件上做少量适应性调整。2023-2024年间,这些技术已在实际产品中得到验证——Agility Robotics的双足机器人Digit通过大规模仿真训练在仓库环境中实现了稳定的搬运作业,Tesla Optimus人形机器人也大量采用仿真训练来加速其工厂操作能力的开发。DuckFightClub的"先虚后实"路线图,恰好为参赛者提供了实践和检验这些前沿迁移技术的绝佳舞台。
开源生态与竞技文化的融合
DuckFightClub体现了开源硬件运动的新趋势。开源硬件运动起源于2000年代,受开源软件精神(特别是Linux和GNU运动的成功)启发,倡导公开硬件设计图纸、BOM清单(Bill of Materials,物料清单,列出制造一个产品所需的所有零部件、数量和规格)和制造工艺。Arduino(2005年诞生于意大利,提供标准化的微控制器开发板)和Raspberry Pi(2012年由英国基金会推出的单板计算机)等项目的全球化成功充分证明了这一模式的可行性和巨大影响力——Arduino已售出超过1000万块开发板,形成了庞大的创客生态系统。在机器人领域,开源硬件运动近年来加速发展:斯坦福大学的Pupper四足机器人、加州大学伯克利分校的Open Dynamic Robot Initiative等开源机器人项目,都在推动学术研究的可复现性和技术的民主化。通过开放MicroDuck的设计和接口,DuckFightClub项目构建了一个围绕标准平台的创新生态。参赛队伍可以专注于算法创新,而不必重复造轮子。
竞技形式的引入也为强化学习教育提供了有趣的切入点。相比枯燥的benchmark测试(如在OpenAI Gym的CartPole或HalfCheetah等标准环境上比较算法收敛曲线),格斗比赛更直观、更有观赏性,能吸引更多人关注和参与AI技术。历史上,竞技对抗一直是推动AI技术进步的重要催化剂——从1997年IBM深蓝击败国际象棋世界冠军卡斯帕罗夫(这场比赛直接推动了搜索算法和并行计算的发展),到2019年DeepMind的AlphaStar在《星际争霸II》中击败职业选手(展示了深度强化学习处理不完全信息博弈和长程策略规划的能力),对抗性赛事不仅推动了算法突破,更让公众直观理解了AI的能力边界。其背后的驱动机制可以从博弈论角度理解:在对抗环境中,任何固定策略都会被针对性策略所击败,因此竞争压力迫使参赛者不断寻求更强的算法创新。这种动态博弈过程会推动策略向纳什均衡方向演化——在均衡点上,没有任何一方可以通过单方面改变策略来获得更好的结果。这种持续的"军备竞赛"效应,是对抗性赛事比静态基准测试更能驱动技术突破的根本原因。DuckFightClub将这种模式引入了实体机器人控制领域。从Product Hunt上95个投票和排名第9的成绩来看,这种将技术与娱乐结合的尝试确实引起了社区关注。
对于想要参与的开发者,可以注册团队、训练自己的策略,或者在自己的城市组织分站赛。DuckFightClub的分站赛模式借鉴了开源社区的Meetup文化和电子竞技的地区联赛机制。在传统机器人比赛如FIRST Robotics(由发明家Dean Kamen于1989年创办的青少年机器人竞赛,每年吸引全球超过50万学生参与)、BattleBots(始于1999年的重量级格斗机器人电视节目)中,赛事组织高度中心化,对场地、裁判和安全设施有严格要求——BattleBots的比赛场地需要厚实的防弹玻璃围栏来保护观众,单场赛事的安全投入可达数十万美元。而DuckFightClub通过统一的模拟器环境和未来标准化的小型硬件平台(MicroDuck的小尺寸意味着即使发生碰撞也不会造成安全隐患),大幅降低了办赛门槛——理论上只需要一台笔记本电脑(模拟赛)或一张桌子大小的擂台(实体赛)即可举办比赛。这种模式类似于国际象棋俱乐部或格斗游戏社区(如街头霸王、铁拳等格斗游戏的FGC——Fighting Game Community)的线下聚会传统,有利于构建持续活跃的全球性社区。这种去中心化的组织方式,让DuckFightClub不仅是一场比赛,更是一个持续发展的社区活动。
多智能体对抗环境的技术价值
从技术角度看,DuckFightClub为强化学习提供了一个多智能体对抗环境。多智能体强化学习(Multi-Agent Reinforcement Learning, MARL)是RL领域的前沿方向,相比单智能体任务,对抗性环境中每个智能体面对的不再是静态环境,而是会根据对手策略动态变化的博弈局面——在博弈论术语中,这意味着环境变成了"非平稳"的(Non-Stationary),因为对手的策略在持续演化,使得传统RL中关于环境马尔可夫性质的假设被部分破坏,这使得问题的复杂度呈指数级增长。经典的自我博弈(Self-Play)方法——让智能体与自身的历史版本对战——已在围棋(AlphaZero)、星际争霸(AlphaStar)等领域取得重大突破。这一方法的优势在于不需要人类专家数据,智能体可以从零开始,通过与自身的博弈不断提升水平。然而,纯粹的自我博弈容易陷入策略遗忘(Catastrophic Forgetting),即新策略在击败最近的对手版本时丢失了对抗更早版本的能力。为此,DeepMind在AlphaStar的训练中引入了"联盟训练"(League Training)机制,维护一个包含不同训练阶段策略版本的对手池,确保策略具备对多样化对手的泛化能力——这一思路对DuckFightClub的参赛者同样具有重要参考价值。OpenAI曾通过自我博弈训练出能玩捉迷藏的智能体,在对抗过程中自发涌现出使用工具、建造掩体、利用物理漏洞等复杂行为,展示了对抗环境驱动策略演化的巨大潜力。在DuckFightClub的格斗场景中,类似的策略涌现同样值得期待——参赛队伍的机器人可能自主发展出闪避、佯攻、反击、利用擂台边缘地形等战术组合,甚至可能涌现出训练者事先未曾设想的创造性格斗风格。
这个项目也为机器人控制算法的快速验证提供了平台。研究者可以快速测试新算法在竞技场景下的表现,积累的数据和经验可以应用到更广泛的机器人应用中,包括工业自动化、救灾机器人和服务机器人等领域。强化学习在格斗机器人中锻炼出的核心能力——动态平衡维持、快速反应决策、接触力控制——与这些应用领域的需求高度重合。例如,救灾机器人需要在不稳定废墟上保持平衡,工业机器人需要精确控制与物体的接触力,服务机器人需要在动态人群中做出快速避障决策。
随着实体硬件的推出,DuckFightClub有潜力发展成为机器人领域的"标准测试集",就像ImageNet之于计算机视觉、GLUE之于自然语言处理一样。ImageNet数据集包含超过1400万张标注图像和2万多个类别,其年度ILSVRC(ImageNet Large Scale Visual Recognition Challenge)竞赛直接催生了AlexNet(2012年)等深度学习里程碑,被普遍认为是开启深度学习革命的关键推手——正是AlexNet在ILSVRC 2012上将top-5错误率从26%骤降至16%的惊人表现,让整个学术界和工业界开始认真对待深度神经网络。GLUE(General Language Understanding Evaluation)基准则为自然语言处理领域提供了涵盖文本蕴涵、情感分析、语义相似度等多任务的统一评测标准,推动了BERT、GPT等预训练模型的快速迭代竞争。然而在机器人控制领域,目前尚缺乏一个被广泛认可的标准化对抗评测平台。其根本原因在于机器人问题的特殊性:首先,硬件的可复现性远低于软件——即使按照相同图纸制造,不同批次的电机、齿轮和传感器也存在个体差异;其次,物理交互的多样性使得评测维度远比图像分类或文本理解复杂——需要同时评估平衡能力、动作流畅性、策略多样性、鲁棒性等多个难以量化的指标;再次,物理实验的不可完全重复性(即使在相同初始条件下,微小的环境扰动也可能导致截然不同的结果)使得统计显著性的验证成本极高。DuckFightClub的尝试恰好瞄准了这一空白——通过开源标准平台消除硬件差异、通过统一的模拟器环境保证可重复性、通过格斗对抗提供多维度的算法压力测试——一个统一的、开源的、具有对抗性的评测平台,有望加速整个机器人强化学习领域的进步。
核心要点
核心要点
相关推荐
开源AI的真相:你拿到的只是蛋糕,不是配方
海外博主深度揭秘开源AI真相:你下载的只是权重(蛋糕),而非训练数据与代码(配方)。文章拆解开放权重与真正开源的差异,剖析Meta、阿里、DeepSeek的商业策略,以及中美欧三国政府如何用营收门槛与算力上限重画开放边界。
DSH白嫖DeepSeek V4.1 Flash:积分批量领取与国际版WorkBuddy实测
DSH项目最新升级实测:WorkBuddy端可批量领取100积分,限流额度提升、重置时间缩短,国际版WorkBuddy现已支持免费调用混元4与DeepSeek V4.1 Flash,附使用建议与风险提示。
DSH-SUBAGENT-UI插件:DeepSeek Harness子代理管理神器
DSH-SUBAGENT-UI 是 DeepSeek Harness Web 客户端插件,提供子代理总览、搜索、本地分类与完成快照功能,数据存本地不侵入原会话,一条命令即可安装,助力多子代理工作流高效管理。