FADE:解耦能力与难度的在线RLVR调度新方法

FADE用双线性状态空间滤波分离模型能力与提示难度,提升在线RLVR调度效率。
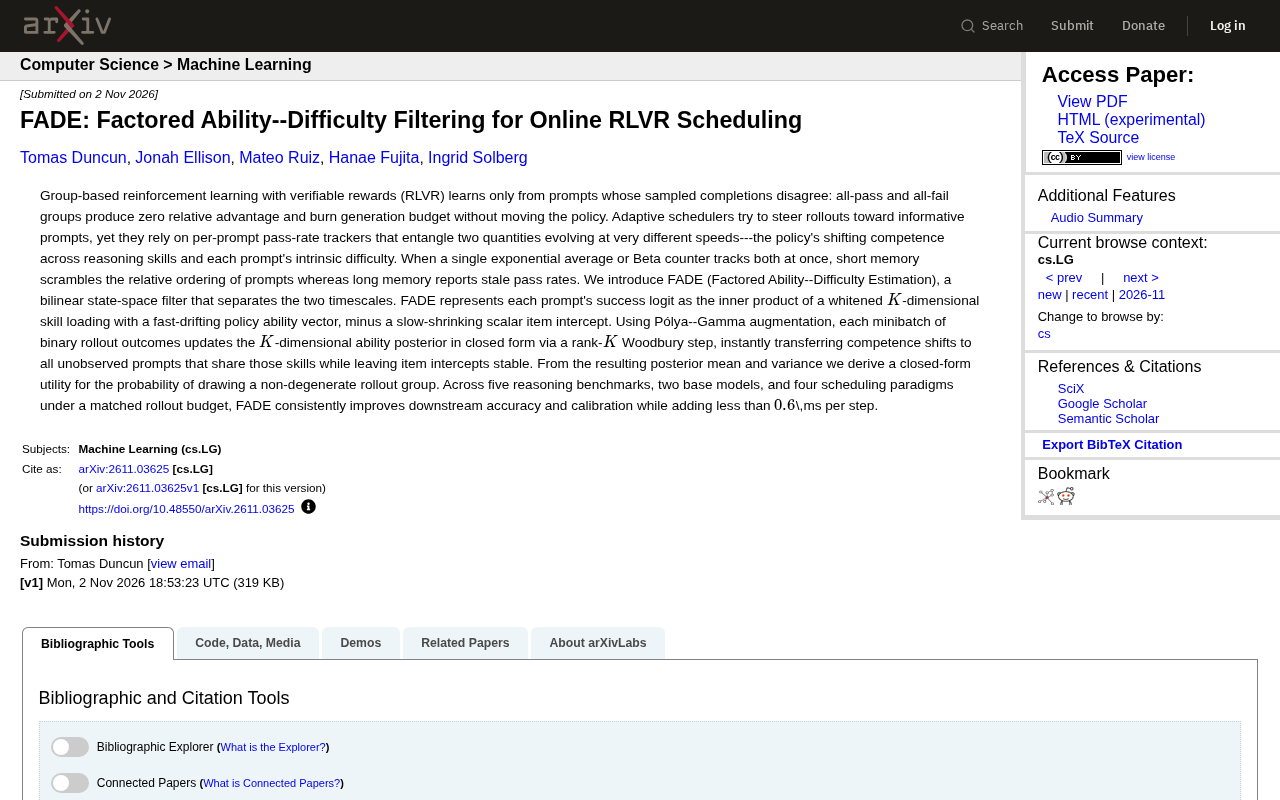
文章介绍了一篇来自rss的论文提出的FADE方法,旨在解决在线强化学习与可验证奖励(RLVR)训练中采样预算浪费的问题。传统自适应调度器为每个提示维护单一通过率跟踪器,但该跟踪器混淆了两个时间尺度不同的因素:模型推理能力的快速漂移与提示固有难度的相对稳定,导致调度决策次优。FADE将每个提示的成功对数几率建模为技能载荷与快速漂移能力向量的内积减去缓慢收缩的项目截距,借助Pólya–Gamma增广与Woodbury步骤实现能力后验的闭式小批量更新,并推导出估计非退化采样组概率的闭式效用函数。实验覆盖五个推理基准、两个基础模型和四种调度范式,在匹配生成预算下持续提升准确率与校准度,每步额外开销低于0.6毫秒,是一种轻量级即插即用方案。
在线强化学习与可验证奖励(RLVR)的训练效率,往往被大量“全对”或“全错”的采样组拖累——这些组无法提供相对优势信号,却消耗了宝贵的生成预算。传统自适应调度器试图将采样导向信息量更大的提示,但它们依赖的通过率跟踪器将两个变化速度截然不同的量混为一谈:模型在各项推理技能上的能力漂移,以及每个提示的固有难度。近期一篇来自rss的论文提出了FADE(Factored Ability–Difficulty Estimation),通过双线性状态空间滤波将二者分离,在多个基准上实现了更优的准确率与校准度。
问题背景:当通过率追踪器“失焦”
RLVR训练中,只有那些采样完成结果存在分歧的提示组才能产生非零的相对优势。全通过或全失败的组别对策略更新毫无贡献,却占用生成配额。自适应调度器因此尝试预测哪些提示更可能产生“非退化”的采样组,但现有方法通常为每个提示维护一个通过率跟踪器,例如指数移动平均或Beta计数器。
问题在于,一个提示的通过率同时受两个因素影响:一是模型在该提示所需技能上的能力变化(可能快速漂移),二是提示本身的固有难度(相对稳定)。单一跟踪器无法同时捕捉两种时间尺度——短记忆会导致提示间的相对排序剧烈波动,长记忆则报告过时的通过率。FADE的作者指出,这种纠缠使得调度决策次优,浪费了训练预算。
RLVR(Reinforcement Learning with Verifiable Rewards)是近年来大模型推理训练中广泛采用的一种范式:对每个提示采样多条推理轨迹,用可自动验证的规则(如数学题答案匹配、代码单元测试通过等)给出二值奖励,再以组内相对比较(例如 GRPO 的组内归一化优势)构造策略梯度。由于优势只能在同组采样结果存在差异时才有意义,一个提示若被采到的轨迹全部正确或全部错误,其贡献的梯度为零。这正是采样预算被浪费的根源:训练早期的简单提示常被“全对”占据,而超难提示长期“全错”,二者都无法提供有效学习信号。理解这一机制,有助于明白为何调度器需要预测“非退化组”的出现概率,以及为何通过率估计的准确性会直接决定训练效率。
FADE的核心:双线性状态空间滤波
FADE将每个提示的成功对数几率建模为两个部分的组合:一个白化的K维技能载荷与一个快速漂移的策略能力向量的内积,再减去一个缓慢收缩的标量项目截距。用公式表示,提示的成功logit = 技能载荷·能力向量 - 项目截距。其中,能力向量反映模型在不同推理技能上的当前水平,项目截距则捕捉提示的固有难度。
这种分解的关键在于,技能载荷是固定的(从提示内容中提取),而能力向量随时间快速更新,项目截距则缓慢变化。通过Pólya–Gamma增广,每个小批量的二元采样结果可以闭式更新K维能力后验,利用秩K的Woodbury步骤,将能力变化即时传播到所有共享相同技能的未观测提示上,同时保持项目截距稳定。
从更新后的后验均值和方差中,FADE推导出一个闭式效用函数,用于估计抽取非退化采样组的概率。调度器据此选择信息量更大的提示,提升训练效率。
Pólya–Gamma 增广是一种用于贝叶斯逻辑回归的采样技巧:它把 logistic 似然中的 log(1+e^x) 项表示为高斯变量与 Pólya–Gamma 随机变量的混合,从而使原本非共轭的二值观测模型获得条件共轭结构,进而可以用高斯后验的闭式更新代替 MCMC。FADE 正是借这一技巧,把每个提示的成功/失败采样转化为对 K 维能力向量的线性高斯观测,使小批量更新可在毫秒级完成。Woodbury 矩阵恒等式则用于高效计算低秩更新:(A + UCV)^{-1} 可通过 A^{-1} 与一个小规模矩阵的逆表示,把 O(K^3) 的重复求逆降为 O(K^2) 量级,这正是 FADE 能将额外开销压到 0.6 毫秒以下的关键。
实验效果:跨基准与调度范式的提升
论文在五个推理基准、两个基础模型和四种调度范式下进行了评估,所有实验均在匹配的生成预算下进行。结果显示,FADE持续提升了下游准确率和校准度,而每步额外开销低于0.6毫秒,几乎可忽略不计。
你可能没注意到,FADE的优势在不同调度范式下均成立,说明其解耦能力与难度的思路具有普适性。与依赖单一通过率跟踪器的基线相比,FADE能更准确地识别出那些模型能力正在变化、但尚未被充分探索的提示,从而生成更有信息量的采样组。
校准度(calibration)衡量模型输出的置信度与实际正确率之间的一致性:若模型对某批提示声称 80% 的把握,那么这批提示的实际通过率应接近 80%。在 RLVR 中,校准度差意味着通过率跟踪器给出的概率偏离真实成功率,调度器据此做出的“哪些提示更有信息量”的判断就会系统性偏错。常用的评估指标包括期望校准误差(ECE)与 Brier 分数。FADE 在提升准确率的同时改善校准度,说明其效用函数给出的非退化组概率估计不仅排序更准,绝对值也更可信,这对需要设定采样阈值的调度策略尤为重要。
启示与展望
FADE的价值在于将元学习中的能力估计思想引入RLVR调度,把“提示难度”和“模型能力”这两个混淆因素显式分离。这种分解不仅提升了调度效率,还为理解模型在训练过程中的技能演化提供了可解释的中间变量。未来,该方法或可扩展到更复杂的奖励结构或多模态任务中,进一步释放在线RLVR的训练潜力。
对于从事大模型推理训练的工程师而言,FADE提供了一种轻量级的即插即用方案——无需修改现有RLVR流程,仅通过改进调度器即可获得更稳定的训练信号。随着推理模型对数据效率的要求日益提高,这类细粒度的调度策略将变得越来越重要。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。