Gemini 3 Flash实测CAPTCHA视觉谜题:多模态Agent能力边界在哪
当VLM遇上趣味视觉谜题:一场接地气的AI实测
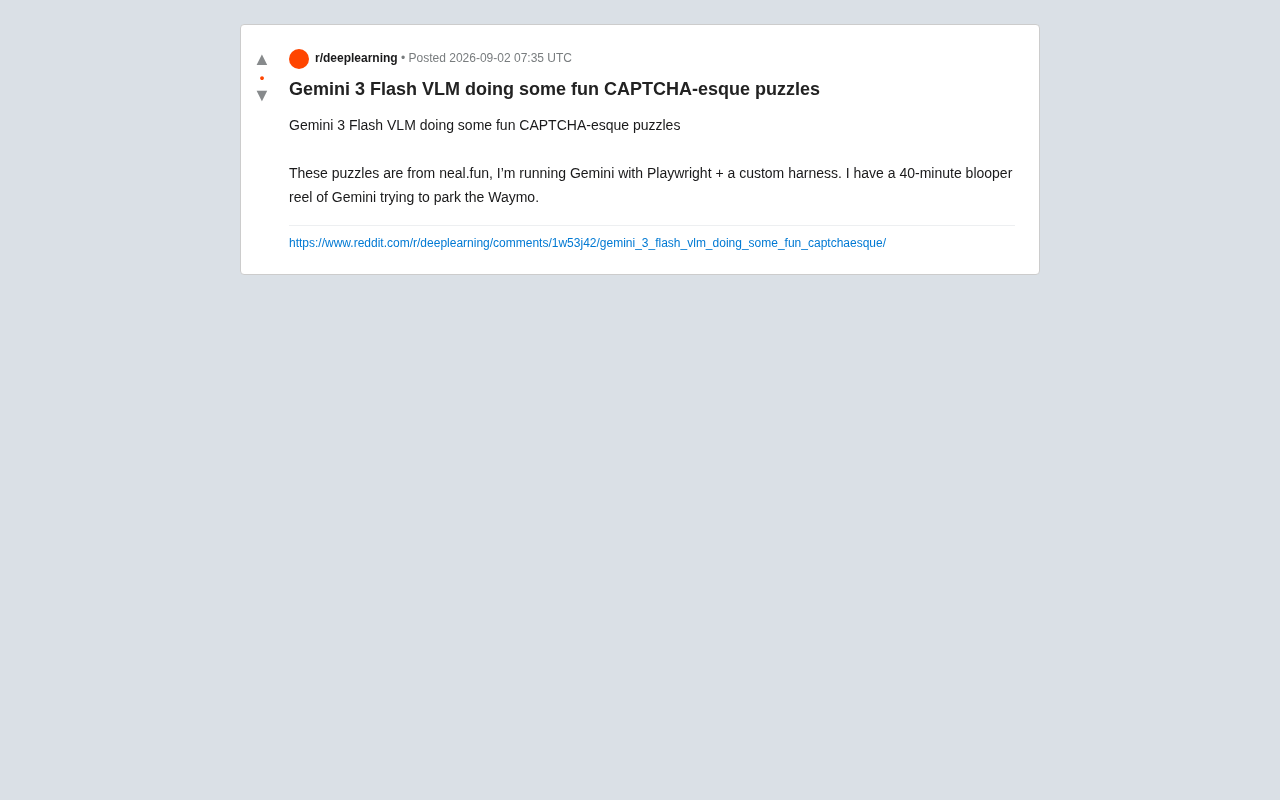
近日,一位开发者在Reddit上分享了一组颇有看头的实验:用Google最新的Gemini 3 Flash视觉语言模型(VLM)去挑战neal.fun上的各类CAPTCHA式互动谜题。
**视觉语言模型(Vision-Language Model, VLM)是近年来多模态AI领域的重要突破。**与传统的单模态模型不同,VLM能够同时处理图像和文本信息,建立两者之间的语义关联。其核心技术路径包括:将图像通过视觉编码器(如ViT,即Vision Transformer)转换为特征表示,再与文本token在统一的表示空间中进行融合,最终通过大型语言模型进行推理。ViT的核心思想是将图像分割为固定大小的patch(如16×16像素),将每个patch线性投影为一个embedding向量,然后与位置编码一起送入标准Transformer架构进行处理。这种方法使得图像特征能够与文本token在相同的注意力机制下进行交叉注意力计算,实现真正的跨模态语义对齐。代表性模型包括OpenAI的GPT-4V(采用独立视觉编码器+跨模态融合的架构)、Google的Gemini系列(从底层即采用原生多模态训练)、Anthropic的Claude 3等。值得注意的是,Google的Gemini系列与GPT-4V在技术路径上存在根本差异:Gemini从预训练阶段就将图像、文本、音频、视频等多种模态混合训练,而非先训练语言模型再"嫁接"视觉能力,这种原生多模态(Natively Multimodal)设计被认为能实现更深层的跨模态理解。这类模型的能力边界正在从简单的图像描述扩展到复杂的视觉推理、空间理解和多步骤任务规划。
**Gemini 3 Flash是Google在Gemini模型家族中面向高效推理场景的版本。**Google的Gemini系列按照能力和效率分为多个层级:Ultra(旗舰级,最强性能)、Pro(均衡型)和Flash(轻量高速)。Flash系列的设计哲学是在保持足够强的多模态理解能力的同时,大幅降低推理延迟和计算成本。这对于需要频繁截图-推理-执行循环的Agent场景至关重要——如果每次推理需要数秒,那么完成一个包含数十步操作的谜题将耗时过长,且中间状态可能已经发生变化。Gemini 3 Flash在这一代中进一步提升了视觉grounding(视觉定位)能力,即模型能够在图像中精确定位特定对象并输出其坐标,这正是驱动视觉Agent进行网页交互的关键能力。
这些谜题以刁钻、脑洞大开著称,向来是考验人类逻辑和视觉理解能力的经典素材。**CAPTCHA(Completely Automated Public Turing test to tell Computers and Humans Apart)最初设计用于区分人类和机器。**这一概念由卡内基梅隆大学的Luis von Ahn等人于2003年正式提出,最初形式是扭曲的文字识别。经历了从文字CAPTCHA到图像选择(如reCAPTCHA v2的"选出所有红绿灯")再到行为分析(reCAPTCHA v3的无感验证)的演进,CAPTCHA的设计一直在与AI的能力进行博弈。neal.fun网站上的互动谜题则将这一概念推向了趣味化和复杂化,包含空间推理、物理模拟、逻辑排序等多维度挑战。这类谜题对AI评测具有独特价值:它们非标准化,难以通过记忆训练数据解决;需要多种能力的组合——视觉感知、逻辑推理、常识理解;任务目标明确但实现路径开放,能真实反映模型的泛化能力。相比ImageNet分类(仅测试图像识别)或VQA(Visual Question Answering,测试图文问答但通常限于单张静态图片)等传统基准,这类开放式互动任务更接近真实世界的应用场景。传统基准的另一个局限是数据污染风险——主流基准数据集可能在训练数据中被"见过",导致评分虚高,而neal.fun这类小众互动网站的内容则很难被大规模爬取纳入训练集。而现在,它们成了检验多模态大模型真实能力的绝佳试金石。
该开发者的技术方案值得关注:通过Playwright(浏览器自动化工具)驱动网页交互,再配合一套自定义的执行框架(harness),让Gemini 3 Flash能够"看到"页面内容、理解谜题目标,并输出对应的操作指令。
Playwright是微软开发的新一代浏览器自动化框架,支持Chromium、Firefox和WebKit三大浏览器引擎。与老牌工具Selenium相比,Playwright提供了更现代的API设计、更可靠的等待机制和更强大的调试能力。Selenium诞生于2004年,基于WebDriver协议,需要额外安装浏览器驱动且经常遇到元素定位不稳定的问题;Playwright则使用Chrome DevTools Protocol(CDP)等现代浏览器调试协议,能直接与浏览器进程通信,稳定性和性能都显著提升。其核心优势包括自动等待元素可交互、内置的网络拦截和模拟、截图和视频录制、跨浏览器兼容性等。在AI Agent开发中,Playwright充当了"手和眼"的角色——通过page.screenshot()获取当前页面的像素级视觉输入,通过page.click(x, y)、page.fill()、page.mouse.move()等API模拟人类操作执行AI的决策。开发者提到的自定义harness(执行框架)则负责将VLM输出的结构化动作指令(如"点击坐标(340, 520)")解析并映射为Playwright的API调用,同时处理异常重试、状态监控等工程细节。
这种组合本质上构建了一个简易的视觉Agent(智能体)——它不仅要读懂图像,还要规划动作并与真实网页环境互动。
**视觉Agent是指能够感知视觉环境并自主执行任务的智能体系统。**其典型架构包含三个核心模块:感知模块(通过截图、OCR等获取环境状态)、决策模块(VLM理解任务目标并规划动作序列)、执行模块(将抽象动作转化为具体操作如坐标点击)。与传统的RPA(Robotic Process Automation,机器人流程自动化)脚本不同,视觉Agent不依赖预定义的DOM选择器或固定流程,而是通过视觉理解适应页面变化。RPA工具(如UiPath、Automation Anywhere)通常需要开发者手动录制或编写基于元素ID、CSS选择器的脚本,一旦页面布局调整就可能失效;视觉Agent则像人类一样"看着屏幕操作",具有天然的鲁棒性。当前的技术挑战包括:坐标映射的精度(VLM输出的坐标需要精确到像素级,但模型的空间定位能力仍有偏差)、多步推理的误差累积(每一步的小错误会在后续步骤中被放大,导致任务失败)、动态环境的状态跟踪(页面内容可能因动画、异步加载等发生变化,Agent需要实时更新状态认知)等。
整个系统的工作闭环可以概括为:截图→VLM推理→动作输出→执行→再截图的循环。在每一轮循环中,系统首先通过Playwright对当前页面进行截图,将截图连同任务描述以结构化prompt的形式发送给Gemini 3 Flash。模型返回的响应需要包含下一步操作的具体参数——通常是操作类型(点击/拖拽/输入)和目标坐标。这里的prompt工程(Prompt Engineering)至关重要:开发者需要精心设计系统提示词,告知模型当前的任务上下文、可用的操作集合、输出格式要求,甚至可能需要提供少量示例(few-shot)来引导模型理解特定谜题的规则。坐标精度问题也是一个核心工程挑战——截图分辨率、浏览器缩放比例、设备像素比(DPR)都会影响模型输出的坐标与实际页面元素位置之间的映射关系。一些更成熟的视觉Agent框架(如SeeAct、WebVoyager)还会引入Set-of-Mark(SoM)技术,即在截图上为可交互元素标注编号标记,将坐标定位问题转化为选择题,降低空间推理的难度。
相关推荐

DeepSeek Harness实战改造:打造低成本AI编程神器
国外技术UP主分享如何改造DeepSeek官方harness,用Claude Code驾驭开源框架,配合Bright Data数据抓取与视觉模型,打造成本仅半分钱的AI编程工作流,实测比Claude Code更便宜。
海外博主实测:DeepSeek已媲美Opus,开发者不必苦等新模型
海外开发者实测认为DeepSeek V4 Pro已媲美Opus 4.8,且开源、成本仅为Claude Code的几百分之一。本文解析其用DeepSeek加BrightData构建SaaS的实践与成本对比。
DeepSeek V4.1 Flash 实测:小尺寸新架构能否问鼎开源
DeepSeek V4.1 Flash 深度实测:全新 MoE 编解码架构、5520 亿总参数、极低活跃参数与大幅降低的 KV 缓存,权重已开源上传 Hugging Face。从 BrowserOS 到 3D 建模的 39 分钟实战表现与性价比全面解析。