GLM-OCR:0.9B参数轻量模型如何撼动文档识别格局

引言:小模型的大野心
基于视觉语言模型(VLM)的OCR技术,正逐渐从边缘走向主流,成为现代文档处理流程中的核心组件。视觉语言模型(Vision-Language Model,VLM)是一类融合了计算机视觉与自然语言处理能力的多模态深度学习模型,其核心架构通常由视觉编码器(如ViT,Vision Transformer)、语言模型骨干(如GPT或GLM系列)以及连接两者的跨模态对齐模块三部分构成。
在VLM的三大核心组件中,视觉编码器ViT的工作原理是将输入图像切分为固定大小的图块(patch),每个patch被线性映射为一个向量token,随后与位置编码一同送入标准Transformer编码器进行自注意力计算。这种机制使模型能够捕获图像中任意两个区域之间的空间关系,对文档版面中跨区域的表格线、分栏线等结构信息尤为有效。值得注意的是,patch size的选择对OCR性能有直接影响:常见的patch size为14×14或16×16像素,但在文档OCR场景中,更小的patch(如7×7)有助于捕获细粒度的笔画细节,代价是token序列长度成倍增加,导致自注意力计算的平方复杂度急剧上升。因此,patch size的选择本质上是细粒度识别能力与计算效率之间的权衡。
跨模态对齐模块的常见实现方式包括线性投影层(如LLaVA采用的方案)、Q-Former(如BLIP-2)以及交叉注意力机制,其目标是将视觉特征映射到语言模型的嵌入空间,使模型能够以自然语言形式"描述"所看到的视觉内容。其中,Q-Former的工作机制值得深入理解——它引入一组可学习的查询向量(learnable queries),通过交叉注意力从冻结的视觉编码器中提取固定数量的视觉特征,实现信息瓶颈式的压缩,避免将数百个视觉token全部灌入语言模型,从而在保留关键视觉信息的同时显著降低语言模型的输入长度和计算开销。
VLM通过在海量图文对数据上进行预训练,使模型学会将视觉信号与语言语义对应起来,在OCR场景中不仅能识别单个字符,还能感知整页文档的版面逻辑,例如标题层级、表格行列关系、页眉页脚的语义角色。
然而,长期以来困扰这一领域的最大瓶颈,并非精度,而是模型体积。
在大语言模型与多模态模型领域,参数量(Parameter Count)通常以"B"(Billion,十亿)为单位衡量,是衡量模型容量与计算开销的核心指标。主流的VLM-based OCR模型通常参数量都超过3B(30亿),这带来了高昂的部署成本与推理开销,使其在实际生产环境中的性价比难以令人满意。以业界常见模型为参照:InternVL2、Qwen-VL等专注文档理解的主流开源模型多在3B至72B区间,当一个OCR任务需要动用数十亿参数的重型模型时,很多企业和开发者不得不重新权衡投入产出比。
而 GLM-OCR 的出现,正在改写这一逻辑。它以仅仅 0.9B(9亿)参数的轻量身躯,实现了与远大于自身体量模型相媲美的识别性能,堪称在文档OCR领域投下的一颗"效率炸弹"。0.9B这一量级在当前VLM生态中属于"超轻量"范畴——约等于一个小型BERT模型的规模,可在单张消费级GPU(如RTX 3060/4060,12GB显存)乃至部分移动端NPU上运行推理。
GLM-OCR 的核心优势是什么?
参数量与性能的平衡艺术
GLM-OCR 最引人注目的地方,是它对"成本-性能比"这一核心难题的重新定义。传统认知中,OCR识别精度往往与模型规模正相关——想要更强的识别能力,就得付出更大的模型体积。
GLM-OCR能以0.9B参数实现超出体量的性能,背后涉及多种主流的模型压缩与效率优化技术。其中,知识蒸馏(Knowledge Distillation)是最为核心的技术之一。这一方法由Hinton等人于2015年正式提出,其核心思想是利用一个已训练好的大型教师模型(Teacher Model)的输出概率分布(即软标签,Soft Labels)来指导小型学生模型(Student Model)的训练。与硬标签(one-hot编码的正确答案)不同,软标签包含了类别间的相似度信息——例如教师模型可能以0.7的概率认为某字符是"己",以0.2的概率认为是"已",这种"暗知识"(Dark Knowledge)反映了字形相近字的关系,远比硬标签携带更丰富的监督信号。
在蒸馏过程中,一个关键的超参数是温度系数(Temperature,通常记为T,取值范围通常在3~20之间)。教师模型的输出logits会除以温度T后再经过softmax归一化,温度越高,概率分布越平滑,低概率类别的信息量被放大。在OCR蒸馏中,这意味着形近字(如"己/已/巳")之间的细微概率差异被显著放大后传递给学生模型,使其更好地学习这些易混淆字的区分边界。除了输出层蒸馏,特征蒸馏(Feature Distillation)是另一重要变体——它不仅对齐教师与学生模型的输出概率分布,还对齐中间隐藏层的特征表示,使学生模型在内部表征层面也模仿教师模型的"思维过程",进一步提升小模型的表示能力。
任务特化微调(Task-specific Fine-tuning)则是另一关键手段,通过在高质量OCR专项数据集上精调,让模型集中容量于目标任务,避免将宝贵的参数预算浪费在与OCR无关的通用知识上。
混合精度推理(FP16/BF16/INT8量化)则可在几乎不损失精度的情况下将显存占用减半乃至压缩至四分之一。标准模型训练使用FP32(32位浮点数),每个参数占4字节;FP16/BF16将精度降为16位,参数存储减半;INT8量化进一步将参数压缩为8位整数,存储空间仅为FP32的四分之一。其中,BF16(Brain Floating Point 16)是Google提出的一种特殊半精度格式,它保留了与FP32相同的8位指数位(因此动态范围一致),仅缩减了尾数位,在深度学习推理中的数值稳定性优于标准FP16。对于0.9B参数的GLM-OCR,FP32下约需3.6GB存储,FP16下约1.8GB,INT8量化后约0.9GB——这正是其能在消费级硬件上运行的数学基础。
这些技术的组合使用,使得"小而精"的垂直专用模型在特定任务上超越"大而全"的通用模型成为可能。
GLM-OCR 用不到1B的参数量证明了:在特定任务的垂直优化下,小模型同样可以打败大模型。据 DebuggerCafe 的介绍,这款模型能够与体量数倍于它的竞品直接对抗,这意味着开发者可以用更低的显存占用、更快的推理速度,获得接近顶级模型的文档识别效果。
轻量级模型为何如此重要
模型体积的缩减带来的不仅是成本节约,更是部署场景的极大扩展。0.9B参数级别的模型意味着:
- 可以在消费级GPU甚至部分边缘设备上流畅运行
- 大幅降低云端推理的算力成本
- 更适合集成到实时文档处理管线中
- 便于批量处理海量文档而不产生天价账单
边缘计算(Edge Computing)场景下,这一特性尤为关键——文档图像无需上传至云端,可在本地完成识别,带来数据隐私保护、网络延迟降低、离线可用等直接优势。目前主流的边缘NPU(Neural Processing Unit,神经网络处理单元)包括Apple的Neural Engine(集成于A系列和M系列芯片)、高通的Hexagon NPU、华为的昇腾(Ascend)310系列等。与通用GPU相比,NPU通过定制化的矩阵运算单元和内存层级设计,在低功耗条件下实现更高的AI推理吞吐,典型AI算力在10-30 TOPS(每秒万亿次整数运算)范围。0.9B量级的模型经INT8量化后,理论推理内存占用可降至约1GB以下,配合这些边缘NPU,理论上可实现亚秒级的单页文档推理,已进入主流工业边缘设备的可行区间。
在边缘部署的工程实践中,除INT8量化外,ONNX Runtime和TensorRT等推理优化框架通过算子融合(Operator Fusion)、内存规划优化(Memory Planning)、动态批处理(Dynamic Batching)等技术可进一步提升推理效率。模型的实际部署还需考虑预处理(图像解码、缩放、归一化)和后处理(token解码、结构化输出生成)的耗时——这些CPU密集型操作在边缘设备上可能成为隐性瓶颈。此外,模型的热启动时间(首次推理的模型加载与编译时间)在边缘设备上可能长达数秒,需要通过模型预加载和AOT(Ahead-of-Time,提前编译)等策略来优化,以确保生产环境中的用户体验。
对于银行票据核验、海关单据识别、医院病历数字化等对数据安全敏感的场景,边缘化OCR方案的合规价值往往超过其性能本身。例如,欧盟《通用数据保护条例》(GDPR)和中国《个人信息保护法》均对个人数据的跨境传输施加了严格限制,将OCR推理保留在本地边缘设备上可以从架构层面规避数据出境的合规风险。对于需要处理发票、合同、票据、扫描件等大规模文档的企业而言,这种轻量化特性直接决定了技术方案能否真正落地。
VLM-based OCR 的技术演进路径
从传统OCR到视觉语言模型
传统OCR(光学字符识别)技术的主流路径自上世纪90年代起逐步成熟,其典型流水线包括:图像预处理(去噪、二值化、倾斜校正)→版面分析(文本区域检测)→字符分割→特征提取→字符分类→语言模型后处理。这套流程在扫描质量良好的印刷体文档上表现尚可,但存在明显短板:复杂版面(多栏、嵌套表格、图文混排)导致文本行提取错误;低质量扫描件使二值化失效;手写体与艺术字体的字符切分困难。
业界标杆引擎的发展历程清晰地反映了这些局限。Tesseract OCR引擎最初由HP实验室在1985-1994年间开发,后于2005年由Google开源并持续维护至今,其4.x版本引入了基于LSTM(长短时记忆网络)的识别引擎,在字符序列建模上取得了显著进步,但整体架构仍依赖于传统的流水线式处理。ABBYY FineReader则是商业OCR领域的标杆产品,以其强大的版面分析能力著称。然而,这两类引擎的共同局限在于其"流水线"架构——每个阶段的错误会不可逆地传递到下游:一旦版面分析阶段将表格误判为段落文本,后续的字符识别再准确也无法恢复正确的结构信息。更关键的是,这些引擎本质上仍是基于局部特征的统计分类器,无法理解跨行、跨格的语义关联(如表格中的合并单元格),缺乏全局语义建模能力。
而基于VLM的OCR方案,将文档理解视为一个视觉与语言联合建模的问题,采用端到端(End-to-End)架构从根本上避免了传统流水线中的级联错误问题。模型同时感知图像全局信息与文本内容,能够在识别文字的同时理解文档的语义结构与布局关系,实现联合优化。这种范式的优势在于,模型不仅能"读出字",还能理解字与字、段落与表格之间的关系,从而输出结构化的、更符合原文档逻辑的结果。这也是VLM-based OCR正逐步成为文档处理管线主流选择的根本原因。
GLM-OCR 的技术定位
GLM(General Language Model)系列模型由清华大学与智谱AI联合研发,其预训练目标采用自回归空白填充(Autoregressive Blank Infilling)。这一预训练目标的设计颇具巧思:在输入文本中随机遮盖若干连续片段(span),将这些片段打乱顺序后拼接到输入序列末尾,模型需要以自回归方式逐token预测每个被遮盖片段的内容。
将GLM的预训练范式置于更广阔的技术图谱中,其设计优势更为清晰:BERT采用的掩码语言模型(MLM)独立预测每个被遮盖token,忽略了被遮盖token之间的依赖关系,且天然不具备生成能力;GPT的自回归预训练只能从左到右单向生成,缺乏双向上下文理解。GLM的span-level自回归填充通过二维位置编码同时编码span在原文中的绝对位置和span内部token的相对顺序,巧妙地兼具了双向编码器的理解深度和自回归解码器的生成灵活性。对于OCR任务而言,这一设计的实际影响是:理解能力帮助模型在解码输出时参考文档的全局上下文,准确解析文档结构(如判断某行文字是标题还是正文);生成能力则确保输出文本的流畅性和完整性,避免输出断裂或语义不连贯。
GLM系列从早期的GLM-130B演进至ChatGLM、GLM-4,覆盖了从对话到多模态的多条技术路线。GLM-OCR正是基于这一模型家族的视觉语言分支,继承了GLM在中文语境下深厚的预训练积累,同时针对文档识别任务进行了垂直方向的精细化优化。
值得注意的是,中文文档OCR本身比英文更具挑战性——汉字字符集超过2万个常用字(GB18030标准收录超过27,000个汉字),字形相近字多(如"己/已/巳"、"戊/戌/戍/戎"等),且中文排版常见横竖混排、印章叠压、繁简混用等复杂情形。除此之外,中文缺乏词间空格,需要在OCR后额外进行分词处理;竖排文本(古籍、部分报纸)要求模型具备多方向文本检测能力;中文文档中常见的公章(圆形弧线排列的文字)和骑缝章对传统文本行检测算法构成严重干扰。中文简繁体混用(如港台文献引用大陆期刊)、日文汉字与中文汉字的微妙字形差异(如"直"字在CJK统一表意文字中的不同变体)也增加了字符分类的难度。这些挑战使得具有深厚中文预训练基础的GLM系列在中文OCR场景中具有天然的语义先验优势,GLM-OCR在中文文档上的优化积累因此尤为关键。
GLM-OCR 正是站在这一技术浪潮之上,但选择了一条与众不同的路径——不追求更大,而追求更精。它将VLM的理解能力与极致的参数效率结合,试图在保证识别质量的前提下,把模型压缩到一个可以大规模部署的"甜蜜点"。
实战指南:在真实文档上运行GLM-OCR推理
根据原文的指引,GLM-OCR 的上手体验相当友好。文章通过在真实世界的文档上进行推理演示,展示了这款模型的实际能力。这种"真实文档"而非"理想测试集"的评估方式,更能反映模型在生产环境中的可用性——真实文档往往存在扫描噪声、版面不规则、字体混用等挑战,是衡量模型泛化能力的真正试金石。
值得一提的是,在OCR模型评估领域,常见的量化指标体系值得深入了解。字符错误率(CER)的计算公式为 CER = (S + D + I) / N,其中S为替换字符数、D为删除字符数、I为插入字符数、N为参考文本的总字符数。需要注意的是,CER可能超过100%(当插入字符极多时)。词错误率(WER)的计算逻辑类似但以词为单位,对中文需先进行分词后再计算。对于结构化文档(尤其是表格),还需引入TEDS(Tree-Edit-Distance-based Similarity)指标——它将表格的HTML表示建模为树结构,通过树编辑距离衡量预测结构与真实结构的差异,是当前表格OCR评测的事实标准。此外,F1-score用于版面检测的精确率-召回率调和均值评估,BLEU/METEOR等指标则用于评估长文本输出质量。在评估GLM-OCR时,建议综合使用CER和结构化输出的F1-score(以及在涉及表格时加入TEDS),以全面衡量其字符级精度与版面理解能力。
对于希望快速上手的开发者,建议关注以下几个实操要点:
- 环境准备:轻量模型对硬件要求较低,普通开发环境即可运行。推荐使用Python 3.10+、PyTorch 2.x以及Hugging Face Transformers库,在配备12GB以上显存的GPU环境下即可流畅推理
- 文档类型测试:优先在自己实际业务的文档类型上做验证,而非仅看官方示例。重点关注业务中最常见的难点文档(如低分辨率扫描件、盖章合同、手写批注文档等)
- 性能基准对比:将 GLM-OCR 与现有方案在相同文档上做横向对比,量化性价比优势。建议从推理速度(tokens/秒或页/分钟)、CER/WER、GPU显存峰值占用三个维度进行对比
- 管线集成:评估其作为文档处理流水线中一环的稳定性与吞吐能力。在生产环境中,OCR往往只是整条管线的一环,后续还需对接NER(命名实体识别)、信息抽取、数据校验等模块,接口兼容性和输出格式的结构化程度直接影响集成效率
结语:轻量化是OCR技术的未来方向
GLM-OCR 的意义,不仅在于它本身的性能表现,更在于它为整个行业提供了一个新的思路:在AI落地的过程中,参数效率与部署成本,往往比单纯的精度指标更具决定性。
这一趋势与更广泛的AI工程化浪潮一脉相承。从学术界的"Scaling Law"(缩放定律,即模型性能随参数量、数据量、计算量的幂律增长关系)到工业界的"Right-sizing"(合适尺寸化),行业正在从"越大越好"的粗放思维向"恰到好处"的精益理念转变。Microsoft的Phi系列、Google的Gemma系列、Meta的Llama 3.2轻量版本等,都在不同程度上验证了小模型在特定任务上的竞争力。GLM-OCR正是这一全球性技术趋势在文档OCR这一垂直领域的具体实践。
当越来越多的团队意识到"不是所有任务都需要大模型"时,像 GLM-OCR 这样精心优化的轻量级专用模型,将在文档智能、自动化流程、边缘计算等场景中占据越来越重要的位置。知识蒸馏、任务特化微调、量化压缩等技术的持续成熟,正在不断降低"高质量小模型"的研发门槛,这或许正是VLM-based OCR真正走向大规模商用的关键一步。
注:本文基于 Reddit 分享的 DebuggerCafe 教程内容整理,具体性能数据与实操细节建议参考原文完整教程。
相关推荐
ComfyUI双语提示词节点实测:不懂英文也能玩转标签
一位B站UP主借助GPT打造的ComfyUI双语标签提示词拓展节点实测:中英标签双向联动、30万词库支持、未知标签一键翻译沉淀,让不懂英文的小白也能玩转提示词,目前适配anima本地部署模型。
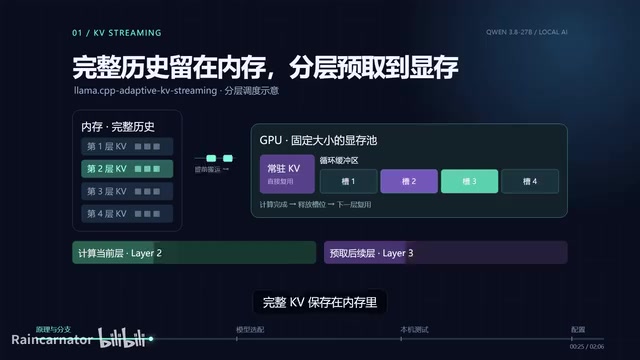
16G显存跑Qwen3 27B:192K上下文+视觉实测
在16G显存显卡上部署Qwen3 27B模型,通过llama.cpp Adaptive KV Streaming实现192K超长上下文与视觉能力。本文详解KV缓存瓶颈原理、量化版本选择及RTX 5080实测速度与任务能力。
MiniMax H3本地部署实测:开源视频模型效果与完整教程
MiniMax H3 开源视频模型本地部署实测:涵盖硬件要求、ComfyUI 完整部署教程,以及文生视频、图生视频的真实生成效果与耗时,适合想入门本地 AI 视频生成的用户参考。