GPT-6 Astra破解2005年悬而未决的恩尼格玛密码?
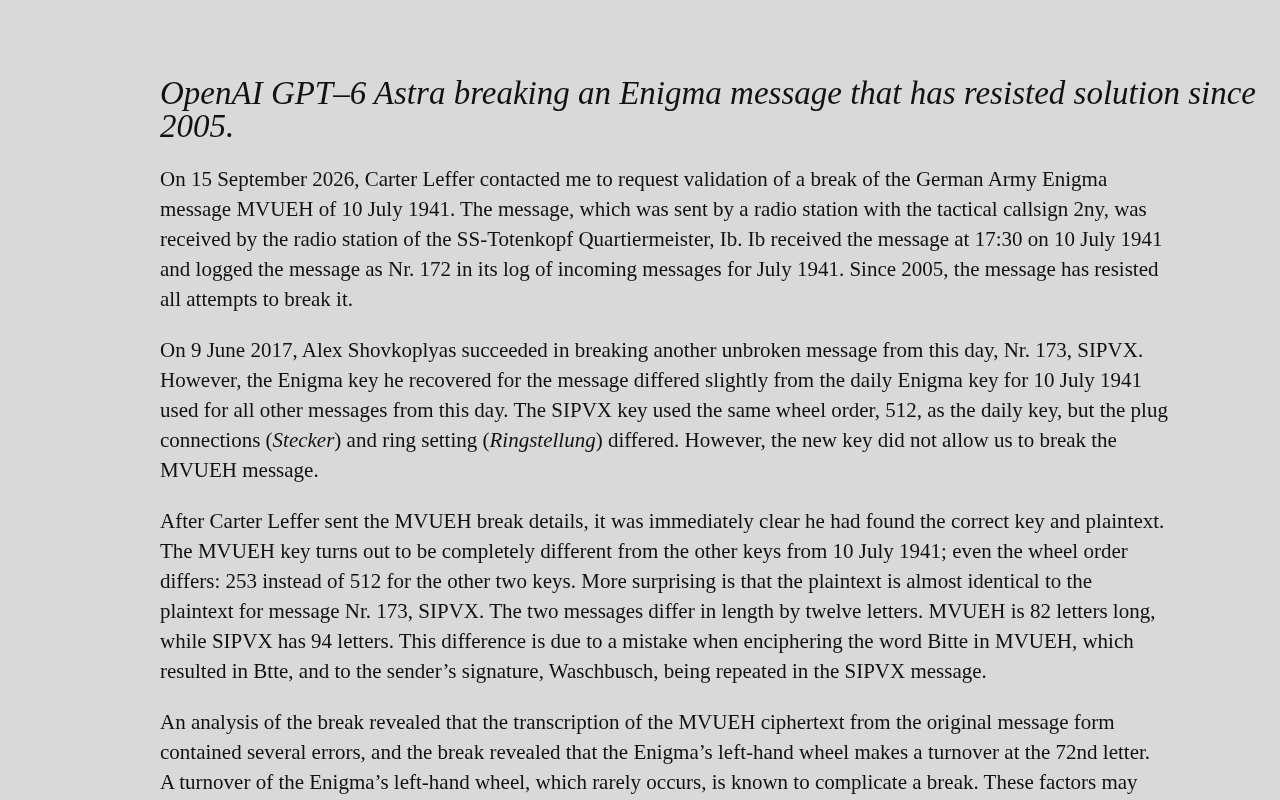
一条未经证实的消息称GPT-6 Astra破解了二战恩尼格玛残缺密文,文章借此探讨大语言模型在密码分析中的技术可能性与合理边界。
近日Hacker News上流传一条消息,称OpenAI尚未正式发布的"GPT-6 Astra"模型破解了一条自2005年起悬而未决的恩尼格玛历史密文。文章指出,恩尼格玛的加密机制早已被完全理解,真正的破译难点在于短消息或残缺密文——可供统计分析的样本极少,搜索空间中充斥大量"伪解"。大语言模型的潜在价值在于充当"语义评分器":由传统算法负责穷举候选解,由语言模型判断哪段结果最符合真实语言的语法与语义,形成互补的混合架构。然而,该消息缺乏可复现的技术细节和独立验证,作者提醒读者对此类重大成果声明保持理性审慎,同时肯定AI辅助历史密码破译作为研究方向本身的想象空间。
一则引发关注的消息
近日,一条关于OpenAI下一代模型的消息在Hacker News上引发讨论:据称名为"GPT-6 Astra"的模型成功破解了一条自2005年以来一直无人能解的恩尼格玛(Enigma)密码消息。这条消息目前的讨论热度有限(仅8个赞、暂无评论),信息本身也相当简略,但话题本身触及了几个值得深入探讨的技术方向:大语言模型在密码分析中的潜力,以及历史加密文本的破译难题。
需要说明的是,截至目前,OpenAI并未正式发布名为"GPT-6"或"Astra"的模型,相关信息尚缺乏权威来源佐证。因此本文更多是从技术可能性的角度,探讨这类声明背后的意义与合理边界。
恩尼格玛密码为何至今仍有未解之谜
恩尼格玛(Enigma)是二战期间德军使用的著名机电加密设备,其破译史与图灵及布莱切利园(Bletchley Park)的工作紧密相连,被视为现代密码学与计算机科学的起点之一。
尽管恩尼格玛的加密机制早已被完全理解,但仍有部分历史拦截的密文因缺乏足够上下文、密钥信息缺失或原始信号损坏而无法完整还原。所谓"自2005年以来无人能解"的消息,很可能指的正是这类残缺或低信息量的历史密文——这类问题的难点不在于算法本身,而在于可用信息的稀缺。
破译难在哪里
对完整的恩尼格玛密文而言,现代计算能力配合已知的密码分析方法(如基于统计特征的攻击、爬山算法搜索转子设置)通常足以在合理时间内还原。真正棘手的是短消息或部分残缺的密文——因为可供统计分析的样本太少,搜索空间中会出现大量看似合理的"伪解",难以判断哪个才是原始明文。
爬山算法(Hill Climbing)在恩尼格玛破译中的具体应用值得简单说明:该算法从一个随机的转子/接线板配置出发,对解密结果的"语言适配度"打分(常用指标有字母频率分布、二元组/三元组频率等),然后逐步微调配置,保留使分数提升的改变,重复迭代直到收敛。这种方法对长密文效果极佳,但面对几十个字符的短消息时,分数曲面变得极为嘈杂——错误配置也可能偶然产生"看起来不错"的字母组合,导致算法频繁陷入局部最优解。这正是人类专家在过去二十年间对某些残缺历史密文束手无策的根本原因,也是引入语言模型进行更精细语义评估的核心动机所在。
大语言模型能在密码破译中扮演什么角色
如果这类声明属实,那么其价值可能并不在于"暴力破解",而在于语言模型对自然语言先验知识的运用。传统密码分析在筛选候选解时,需要人工或统计模型判断哪段解密结果"更像真实语言"。而大语言模型天然擅长评估文本的语言合理性。
设想这样一种流程:搜索算法生成大量候选解密结果,语言模型充当"评分器",快速识别出最符合德语(或特定军事术语)语法与语义的候选,从而在庞大的搜索空间中锁定真正的明文。这种"传统算法负责搜索、大模型负责语义评估"的混合思路,正是当前AI辅助科研的一个典型范式。
值得保持的审慎
另一方面,这类消息也需要谨慎看待。历史上不乏"AI破解某某难题"的夸张标题,实际成果往往被过度渲染。在缺乏可复现的技术细节、原始密文来源和独立验证的情况下,单凭一条简短消息很难判断其真实性与含金量。对于任何声称破解了长期未解密码的成果,密码学界通常会要求公开方法论和可验证的结果。
这类话题的更大意义
抛开具体真伪,AI与历史密码破译的结合本身是一个富有想象力的方向。类似地,此前已有研究团队尝试用机器学习方法处理伏尼契手稿(Voynich Manuscript)等未解文本,虽然尚无定论,但展示了AI在处理稀疏、噪声大的历史文本时的潜在价值。
对普通读者而言,这类消息提醒我们:随着模型能力增强,AI的应用边界正在从常规任务向更专业、更"硬核"的领域延伸。同时,也应对未经验证的重大成果声明保持理性——技术进步值得期待,但严谨的验证同样不可或缺。
伏尼契手稿(Voynich Manuscript)是一份约成书于15世纪初的神秘插图手稿,以某种迄今未知的文字或符号系统写成,内容涵盖植物、天文、生物等图示,数百年来令语言学家和密码学家困惑不解。2019年前后,多个研究团队尝试用统计语言模型和神经网络分析其符号分布规律,部分研究认为其底层语言可能具有某种自然语言的统计特性(而非纯粹的无意义字符),但至今没有任何破译成果获得学界广泛认可。它与恩尼格玛残缺密文的处境不同——后者已知算法只缺密钥,而伏尼契手稿连编码系统本身都是谜,代表了AI辅助密码学所面临的两类截然不同的挑战。
结语
"GPT-6 Astra破解恩尼格玛密码"目前仍是一条信息量有限、缺乏权威佐证的消息。它更像是一个引子,让我们思考大语言模型在密码分析等专业领域的可能性,以及在信息爆炸时代如何辨别技术声明的可信度。在OpenAI或相关方给出正式说明之前,理性的态度是:既不盲目相信,也不轻易否定,等待更多可验证的细节。
相关推荐
Swift1.5-Qwen3.8-Flash-Next实测:推理提速60%,质量几乎无损
Swift-1.5-Qwen3.8-Flash-Next实测对比基础版Qwen3.8-Flash:Aider编程基准显示其推理token和耗时降至40%,质量几乎无损,C++场景需留意。本地大模型效率优化实录。
中学生涌入NPR评论区:一场Z世代的网络迁徙
NPR工作人员一度把Spotify播客评论区的古怪留言当成机器人,直到一位Z世代同事识破真相——原来是中学生把这里当成了新的线上聚集地。本文解读青少年网络迁徙背后的代际认知差异与平台治理挑战。
《Factorio》登陆触屏平台:一场工厂建造游戏的交互重构
自动化工厂建造游戏《Factorio》正尝试移植到触屏平台。本文解析开发日志 FFF-447 中揭示的触屏交互重构挑战,以及复杂桌面软件迁移触摸范式的通用启示。