GPT-6 Sol 与 Luna 发布:性能更强,价格再降50%

GPT-6系列Sol与Luna发布,Luna两月内输出价格从6美元骤降至0.50美元,降幅超90%。
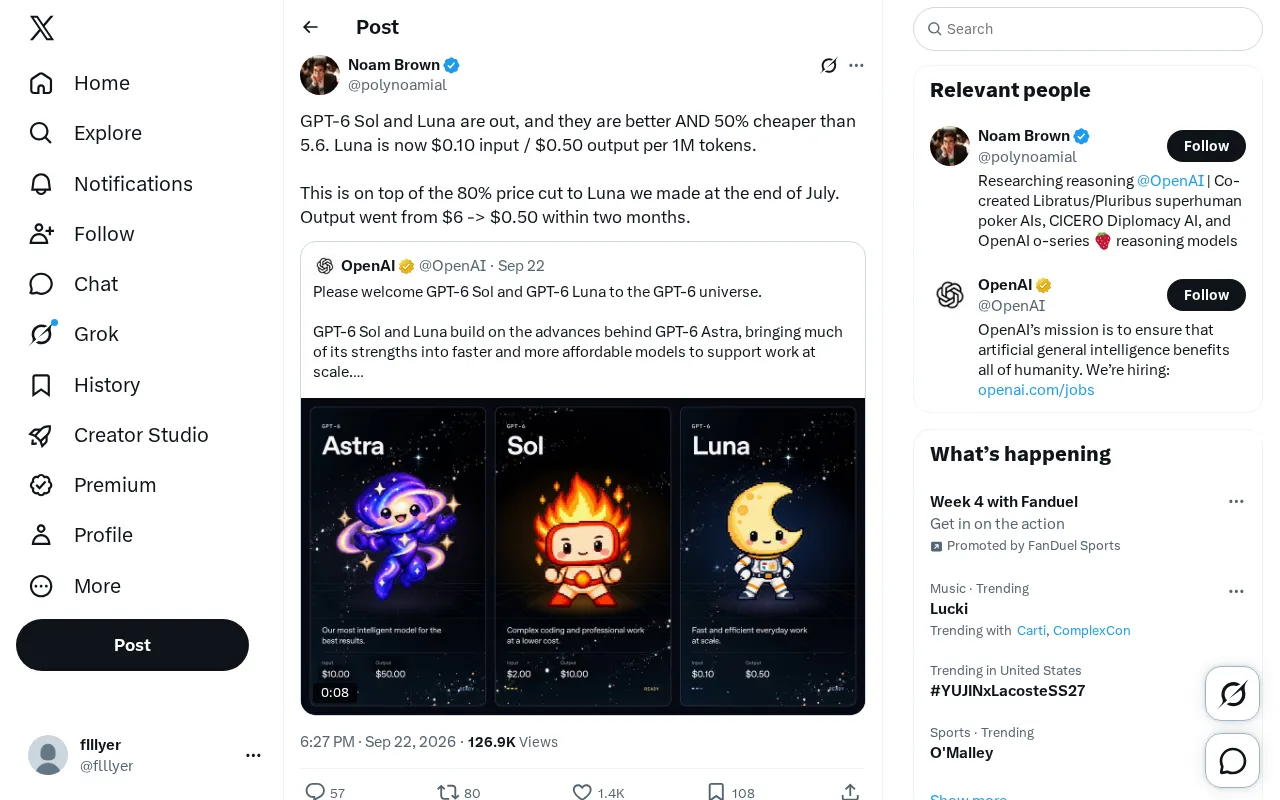
据Twitter爆料,OpenAI GPT-6系列推出Sol和Luna两款模型,性能优于上一代5.6版本,价格同步下降约50%。轻量级模型Luna的定价为每百万token输入0.10美元、输出0.50美元,而其输出价格在过去两个月内已从6美元经历两轮降价累计缩水超90%。这一趋势折射出推理架构优化与市场竞争共同驱动的行业降本逻辑,对成本敏感的高频AI应用(如批量内容处理、对话机器人等)具有直接的商业价值。不过,上述信息来自单一爆料来源,Sol完整定价与性能基准等关键细节尚待官方确认。
GPT-6 系列登场:更强性能叠加更低价格
一条来自 Twitter 的消息显示,GPT-6 系列的两款模型 Sol 和 Luna 已经发布。据原文描述,这两款模型相比上一代 5.6 版本不仅性能有所提升,价格还下降了约 50%。
其中最受关注的是轻量级模型 Luna,其定价调整为每百万 token 输入 0.10 美元、输出 0.50 美元。对于高频调用、成本敏感的应用场景来说,这一价格水平具有相当大的吸引力。
Luna 价格的急剧下探
原文特别强调,这次降价是建立在此前一次大幅调整之上的。据爆料者描述,Luna 在七月底曾进行过一次高达 80% 的价格削减,而本次 GPT-6 发布又在此基础上再降 50%。
从数字上看,Luna 的输出价格在两个月内由每百万 token 6 美元降至 0.50 美元,降幅超过 90%。这意味着同样一次调用,开发者的输出成本几乎只剩下原来的十二分之一。
这种断崖式的价格下降,反映出轻量级模型在推理成本上的持续优化空间,也体现出厂商在抢占开发者生态方面的激进姿态。
价格战背后的逻辑
模型价格的快速下探,通常由几个因素共同驱动:推理架构的优化、更高效的硬件利用率,以及日益激烈的市场竞争。当头部厂商不断压低单位 token 成本时,整个行业的使用门槛随之降低,更多应用得以在可控成本内落地。
对于以调用量取胜的产品形态——例如批量内容处理、对话机器人、数据标注与清洗等——每百万 token 几毛钱的差距,放大到规模化调用后将直接决定产品的毛利率。
值得关注的是,推理成本下降还与模型架构本身的演进密切相关。近年来,混合专家模型(MoE,Mixture of Experts)被广泛应用于轻量级模型的设计中——该架构在每次推理时只激活部分参数,而非让全量参数参与计算,从而在保持较高能力上限的同时大幅降低单次推理的计算量。与此同时,量化技术(Quantization)的成熟也使模型在精度损失可控的前提下以更低比特数运行,进一步压缩了显存占用与计算开销。这些技术层面的进步,是厂商得以在不牺牲模型质量的前提下持续压低 API 定价的底层支撑。
对开发者意味着什么
如果性能提升与价格下降的说法属实,GPT-6 Sol 和 Luna 的组合为开发者提供了更灵活的选型空间:Sol 可承担更复杂的推理任务,而 Luna 则适合作为高频、低延迟场景下的默认选择。
在实际落地中,许多团队会采用"分级调度"策略:简单请求交给低价模型处理,复杂请求再路由到高性能模型。Luna 价格的大幅下降,使得这种分级策略的成本优势更加明显。
需要说明的是,上述信息来自单一的 Twitter 爆料来源,关于具体的性能基准测试、上下文窗口、以及 Sol 的完整定价等关键细节尚未在原文中披露。开发者在做技术选型前,仍需等待官方文档与第三方评测的进一步确认。
"分级调度"(Routing / Model Cascading)策略在工程实践中已有成熟的实现方式。常见做法是在请求入口处设置一个轻量分类器或规则引擎,依据请求的复杂度、所需上下文长度或置信度阈值,将流量动态分发给不同等级的模型。部分团队还会引入"回退机制":先用低成本模型生成候选答案,当置信度低于阈值时再将同一请求升级至高性能模型二次处理。随着 Luna 这类低价模型性能的提升,越来越多的请求可以在第一级就得到满意的结果,整体推理成本因此呈非线性下降。
小结
从这条爆料来看,大模型市场正在以极快的速度经历"性能上升、价格下降"的双重趋势。Luna 两个月内输出价格缩水九成以上,是这一趋势最直观的注脚。对成本敏感的 AI 应用而言,这类调整将持续重塑产品的经济模型。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。