谷歌Gemini Omni 1.2 Flash实测:六维鹈鹕骑车翻车

Gemini Omni 1.2 Flash实测:光影运镜稳定,但空间推理、镜面反射与指令跟随仍有明显短板。
B站UP主用自创的“六维鹈鹕骑车”提示词对Gemini Omni 1.2 Flash进行压力测试,从主体完整性、肢体推理、镜面反射、中文文本与时钟、液体浮力、运镜构图六个维度逐项评估。结果显示,模型在运镜和光影上表现稳定,液体浮力维度也未发现明显问题;但在主体完整性上出现车把后视镜缺失与镜面穿模,肢体指令跟随不精确(翅膀未搭车把、嘴未保持张开),镜面反射对称错乱,中文“傲”字写错、时钟指向不准,构图也未遵循步道方向要求。总体而言,该模型在精确空间关系与复杂提示词遵循上仍有明显短板,适合氛围类而非严格约束的创作场景。
谷歌新推出的视频生成模型Gemini Omni 1.2 Flash在AI Studio上线后,迅速引来创作者实测。B站UP主用一套自创的"六维鹈鹕骑车"测试提示对其进行了压力测试,结果暴露出不少细节问题。本文基于该实测素材,拆解其表现与短板。
测试方法:六维提示词设计
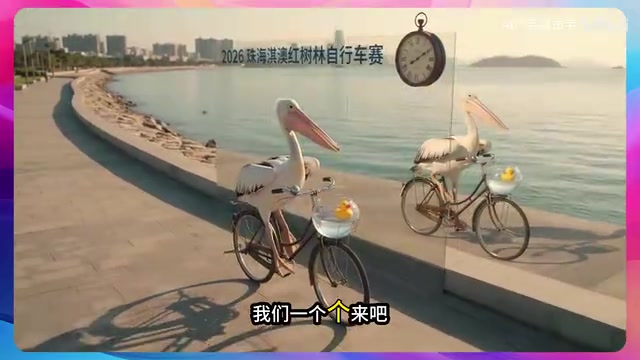
UP主设计了一个包含多个约束条件的提示词:一只鹈鹕骑着自行车,左翅膀搭在车把上、另一只收拢,嘴巴保持张开;场景中有镜面护墙、步道从右上到左下延伸、挂钟指向三点钟、中文文本"齐傲"等元素。测试从主体完整性、肢体与机械推理、镜面反射与空间推理、中文文本与时钟、液体与浮力运动、运镜构图与光影六个维度逐项打分。
提示词工程(Prompt Engineering) 在此类测试中扮演关键角色。视频生成模型对提示词的遵循能力,通常被称为“指令跟随”(Instruction Following)。当提示词包含多个并列约束(如同时指定肢体姿态、物体部件、空间布局、文本内容)时,模型需要在生成过程中平衡各条件,容易出现约束冲突或遗漏。业界常用“组合性提示”(Compositional Prompt)来评估模型对复杂、多对象、多关系场景的解析能力。本测试中的六维提示词正是典型的组合性压力测试,旨在暴露模型在多重约束下的优先级分配与细节保持能力。
维度一:主体完整性与跨层一致性
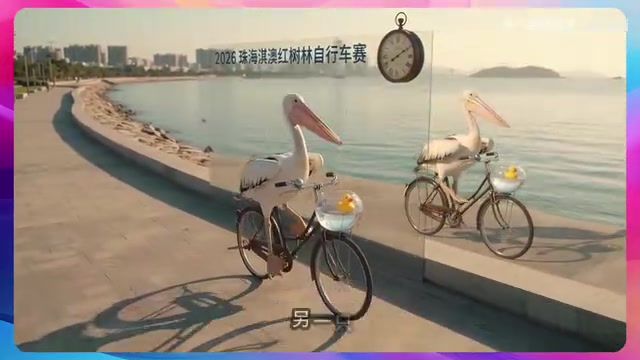
模型生成的画面中,自行车缺少了车把后视镜这一指定部件。更明显的问题是镜面护墙并非一整面不间断的落地镜面,而是出现了穿帮:除了镜面墙,画面里还多出一只"镜子里的鹈鹕",明显是穿模。这说明模型对"连续镜面"这种空间结构理解不足,倾向于用生成相似物体的方式填补区域。
跨层一致性(Cross-layer Consistency) 指生成视频中不同空间层次(如前景、背景、反射面)之间物体属性与位置关系的连贯性。在镜面场景中,模型需要理解反射层与实物层之间的几何映射关系,确保反射内容随实物运动而同步变化。当前视频生成模型多基于扩散模型(Diffusion Model)或自回归Transformer架构,其训练数据中镜面反射样本相对稀缺,且模型倾向于将反射区域视为独立生成区域,而非物理上严格的镜像变换,因此容易产生“复制相似物体”的近似行为,导致穿模与对称错乱。
维度二:肢体与机械推理
提示词要求鹈鹕左翅膀搭在车把上、另一只收拢,但画面里两只翅膀都是收拢状态,没有执行"搭车把"的动作。同时,鹈鹕嘴后来是闭合的,没有保持张大的要求。模型在肢体与物体的交互关系上缺乏精确控制,动作指令被简化为静态姿态。
维度三:镜面反射与空间推理
镜面里的自行车链条、布盖、铃铛没有跟着实物做正确的左右翻转,对称关系错乱。模型不是生成对称镜像,更像是复制了一只相似的鹈鹕放进去。这说明其镜面反射并非基于物理空间推理,而是基于图像模式的近似生成,导致反射内容与实物脱节。
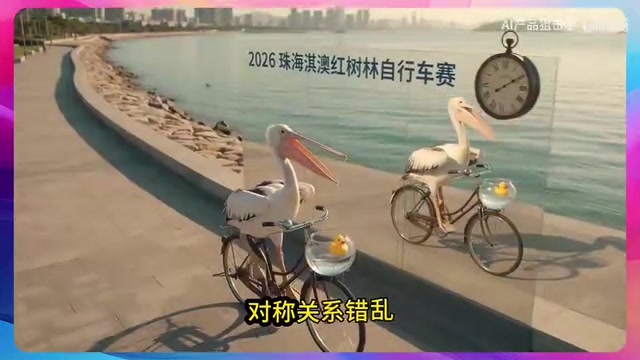
空间推理(Spatial Reasoning) 是视频生成模型的一项核心挑战。人类可以轻松推断物体在三维空间中的位置、朝向及相互遮挡关系,并据此预测镜面反射的左右翻转。然而,多数视频生成模型缺乏显式的三维场景表示,而是通过二维图像序列的统计规律进行生成。当提示词要求精确的镜面反射时,模型往往依赖训练数据中的“镜面模式”进行模式匹配,而非执行真正的几何变换。这解释了为何反射内容与实物脱节——模型并未建立“物体-镜面-观察者”的空间坐标系,而是将反射区域作为独立画面元素进行生成。
维度四:中文文本与时钟
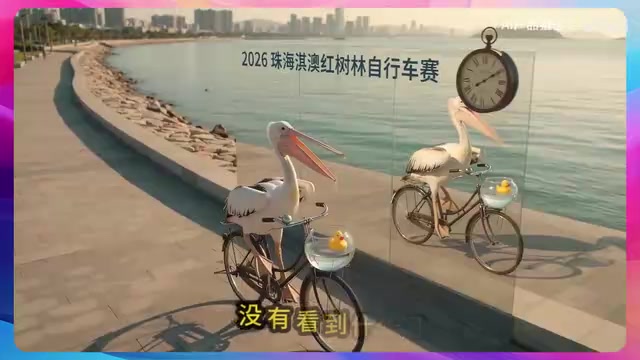
提示词中的"齐傲",模型把"傲"字写错了;挂钟的时间也不是精确的三点钟,与实际指向相距较远。中文文本生成和精确时间指示仍是视频模型的薄弱环节,文字容易形变,钟表指针难以精确对齐。
中文文本生成在视频模型中面临独特困难。与英文不同,中文字符结构复杂、笔画精细,且模型训练数据中中文文本视频样本相对较少。视频生成模型通常将文本渲染视为像素级生成任务,缺乏对字形结构的显式建模,因此容易出现笔画缺失、结构错位或形近字混淆。时钟精确指示则涉及对指针角度与表盘刻度的精细空间对齐,要求模型具备细粒度几何控制能力。当前模型在生成钟表时,往往只能生成“类似钟表”的图案,难以精确控制指针指向特定时刻,这反映了模型在精细数值与几何约束上的普遍短板。
维度五:液体与浮力运动
这一维度没有看到什么问题,说明模型在流体和浮力这类连续物理运动上表现相对稳定,至少在本测试场景中没有出现明显错误。
维度六:运镜、构图与光影
构图出现严重问题:提示词要求步道从右上到左下延伸,镜面墙在步道上侧,但生成画面明显不符合这一要求。运镜和光影则没有看到问题,有开始的45度角俯拍,然后水平跟拍,光影表现正常。
总结:能力与短板并存
Gemini Omni 1.2 Flash在光影和基础运镜上表现稳定,但在精确空间关系、镜面反射、肢体指令跟随、中文文本和精细构图方面仍有明显短板。对于需要严格遵循复杂提示词的创作场景,目前仍需谨慎使用;若用于氛围类、非精确约束的视频生成,则可能发挥其优势。
UP主在视频结尾邀请观众打分,从实测看,这个模型距离"非常能打"还有一段路要走。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。