HF热榜盘点:DeepSeek-V4.1-Flash登顶,端侧与本地部署全面爆发
Hugging Face热榜揭示三大趋势:旗舰MoE降成本、端侧小模型扛Agent、本地视频生成成刚需。
本文基于Hugging Face真实API热榜数据,梳理当前最受开发者关注的开源模型。榜首DeepSeek-V4.1-Flash以552B MoE架构实现仅8B激活参数,叠加MIT协议和百万Token上下文,重新定义开源旗舰标准;面壁智能MiniCPM5 2B和阿里Qwen3.8 27B分别从「小模型能力上限」与「本地部署性价比」两个维度占据端侧市场,后者的GGUF量化版更以千万级日下载量成为本地部署首选;NextN 2.5代表计算机操控Agent新赛道,LTX 2.5则标志开源视频生成从尝鲜走向刚需。国产模型在热榜前十占据大半,整体呈现旗舰MoE回归、端侧爆发、视频生成普及三条清晰走向。
开源模型的竞争节奏正在加速。Hugging Face 模型总数已突破 301 万,8 月初刚跨过 300 万大关,短时间内又新增百万级模型托管,这个数字本身就说明了社区活跃度。而这份基于真实 API trending 返回的热榜,比人工挑选的榜单更能反映一线开发者的选择——前十里国产模型占了大半,从旗舰 MoE 到端侧小模型再到本地量化版,几乎覆盖了所有算力档位。
本文根据 B 站 UP 主「硬核AI实战派」的热榜盘点,梳理当前 Hugging Face 上最受关注的几个开源模型,并分析背后的三条明显趋势。
旗舰回归:DeepSeek-V4.1-Flash 登顶
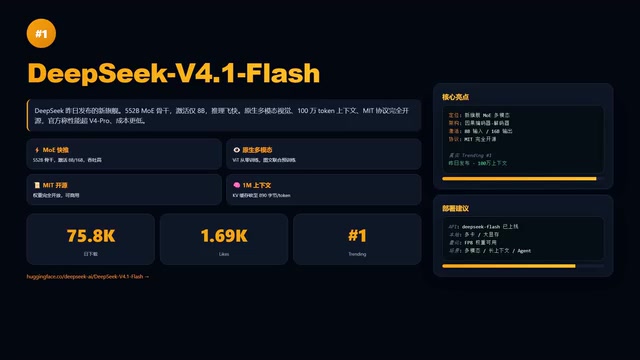
榜首是刚刚发布的 DeepSeek-V4.1-Flash,凭 75.8K 日下载、1.69K 赞直接登顶。它的技术画像很清晰:552B 参数的 MoE 骨干,但激活参数只有 8B、输出时 16B,这意味着推理速度飞快而部署成本可控。
更关键的是它采用 MIT 协议完全开源,并原生支持多模态视觉,上下文长度做到 100 万 Token。官方口径称其性能超过 V4 Pro,但输出价格只有对方的七成。成本优化的核心在于 KV 缓存被压到每 Token 890 字节,仅为 V4 Flash 的四分之一——对本地部署和长上下文场景来说,这直接决定了显存能否撑得住。
把性能、成本、速度三者同时拉满,再叠加宽松的开源协议,是它能快速登顶的根本原因。对本地部署党而言,一个 8B 激活、MIT 授权的多模态旗舰,几乎是理想配置。
MoE(Mixture of Experts,混合专家架构)是理解这类模型参数数字的关键。传统密集模型每次前向推理都会激活全部参数,而 MoE 模型将参数分成若干「专家」子网络,每次推理由路由层动态选择其中少数几个专家处理输入。DeepSeek-V4.1-Flash 总参数 552B,但每次推理仅激活约 8B(生成时为 16B),这意味着其算力消耗与一个 8B 密集模型相当,却能调用 552B 参数所储存的知识容量。KV 缓存(Key-Value Cache)则是 Transformer 推理加速的核心机制:在生成长文本时,模型会缓存每一层的注意力键值对以避免重复计算,缓存大小与上下文长度和层数成正比。将 KV 缓存压缩至 890 字节/Token,意味着 100 万 Token 的超长上下文在显存中的占用从数十 GB 降至可接受范围,这对本地多卡部署或云端长上下文应用具有决定性意义。
端侧爆发:MiniCPM5 与 Qwen3.8 抢占落地场景
榜单第二是面壁智能的 MiniCPM5 2B,67.6K 日下载、1.17K 赞。作为 MiniCPM5 系列第二代密集模型,它主打端侧和边缘部署,128K 上下文,支持 Think/No-Think 双推理模式和原生工具调用,采用 Llama 标准架构,可被 vLLM 原生加载,单卡 TP=1 即可运行。
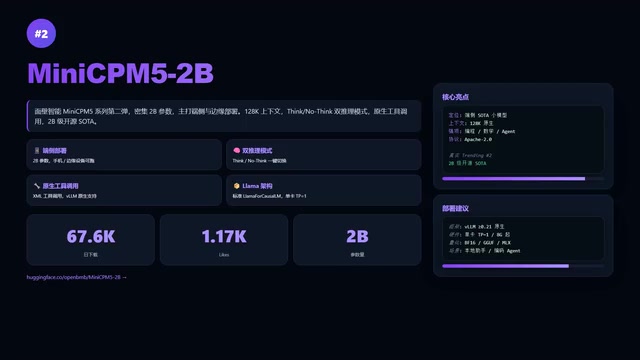
2B 这个体量能在编程、数学、长上下文和 Agent 任务上做到 SOTA,本身就是一个信号:端侧小模型不再只是玩具,2B 也能扛 Agent 任务,本地部署门槛正在快速下降。
占据下载量榜首的是 Qwen3.8 27B,756 万日下载、14.7K 赞,是全场下载量最高的模型。它支持 Image-Text-to-Text 多模态、中英双语,工具调用与结构化输出都很稳定。27B 这个档位在 16G 显卡量化后正好能跑,被称为本地部署的「性价比甜点」。Qwen3.8 从 Flash 到 27B 采用同一架构覆盖所有算力档,是它能形成规模化下载的关键。
本地部署真命天子:Qwen3.8 27B GGUF 量化版
如果说 Qwen3.8 原版是甜点,那么 Unsloth 提供的 Qwen3.8 27B GGUF 量化版就是本地部署党的真命天子——1133 万日下载、3.88K 赞,是量化版里下载量最高的。
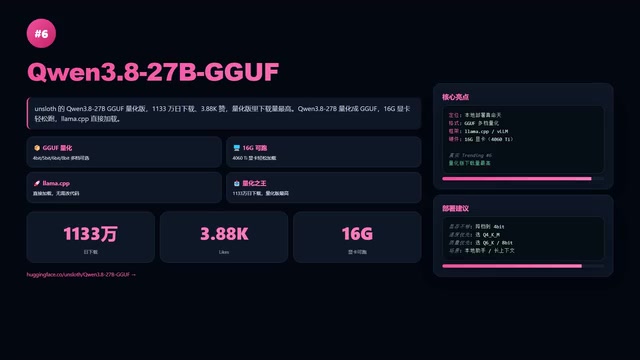
量化成 GGUF 后,16G 显卡就能轻松跑起来,llama.cpp 可直接加载,从 4bit 到 8bit 多档可选,显存不够就往低档降。这种「拿来即用」的可运行版本,比理论性能更能打动实际动手部署的用户。热榜上原版和量化版同时高居前列,说明社区对 Qwen3.8 的需求横跨云端与本地两端。
GGUF(GPT-Generated Unified Format)是由 llama.cpp 项目引入的模型文件格式,专为本地 CPU/GPU 混合推理设计。它的前身是 GGML 格式,GGUF 在元数据管理、量化方案描述和跨平台兼容性上做了系统性改进。量化(Quantization)指将模型权重从 FP16/BF16 等浮点格式压缩为 INT8、INT4 甚至 INT2 等低精度整数表示,以牺牲少量精度换取显存占用和计算量的大幅下降。4bit 量化通常能将模型体积压缩至原始的约四分之一,27B 模型经过 4bit 量化后体积约 14-16GB,正好卡在消费级 16GB 显卡的承载上限。llama.cpp 支持显存不足时自动将部分层卸载至内存甚至硬盘(称为 offloading),进一步降低了硬件门槛,这是 GGUF 量化版在本地部署社区获得压倒性下载量的根本原因。
Agent 与视频生成:两条新兴赛道
榜单第四是上海创新研究院 NextAGI 的 NextN 2.5,一款 397B MoE、激活 17B 的 Agent 模型,专为计算机操作打造:读屏幕、点浏览器、看结果、自我纠正,262K 上下文,采用 Apache 2.0 协议,OS World 成绩达到 56.4(官方口径)。
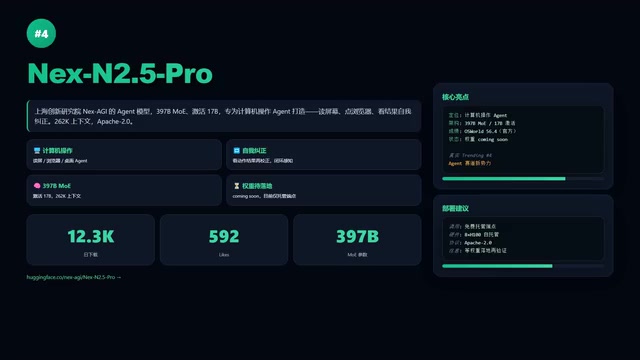
需要提醒的是,它的权重目前还标着 Coming soon,只有免费托管端点可调用,等权重实际落地后还需在更广泛场景验证——这是单一来源信息,实际表现有待观察。
视频生成方面,Lightricks 的 LTX 2.5 以 167 万日下载、3.44K 赞上榜,是开源图生视频里最稳的选择之一,可直接接入 ComfyUI 工作流,适合做产品演示、知识分享等视频素材。它与 MiniMax H3 一同出现在热榜,说明开源视频生成赛道已经彻底起势,本地视频生成正在成为刚需。
OS World 是评估 Agent 模型操控真实操作系统能力的权威基准测试,任务包括在 Windows/Linux 环境中完成文件管理、网页操作、软件使用等复合型指令,模型需通过截图感知当前状态并输出鼠标键盘操作序列。该基准的难点在于任务链路长、环境状态随操作动态变化,且错误会累积——这与传统问答或代码生成任务有本质差异。56.4 的 OS World 成绩处于当前公开模型的较高水平,但由于 NextN 2.5 的权重尚未公开、仅提供托管端点调用,外部研究者无法独立复现测试结果,该数据目前仍属官方单方面披露。ComfyUI 则是面向本地部署的可视化工作流编排工具,用户可将图像/视频生成模型的各处理节点以有向图形式连接,LTX 2.5 支持直接接入 ComfyUI 意味着它能无缝嵌入现有的本地创作管线。
三条趋势总结
综合这份热榜,可以提炼出三条清晰的走向:
- 旗舰 MoE 多模态回归:DeepSeek-V4.1-Flash 用 MIT 协议加 8B 激活参数,把性能、成本、速度全面拉满,重新定义了开源旗舰的标准。
- 端侧小模型爆发:MiniCPM5 2B 证明了小体量也能承担 Agent 任务,本地部署门槛持续走低。
- 开源视频生成成为标配:LTX 2.5 等模型的高下载量,标志着本地视频生成已从尝鲜走向刚需。
从旗舰到端侧再到本地量化,这份榜单几乎覆盖了当下开源模型生态的全貌,也让「本地部署」这件事变得比以往任何时候都更触手可及。
相关推荐
Cursor 3.0 完整入门指南:从零上手 AI 编程 IDE
Cursor 3.0 完整入门教程:从下载安装、创建项目到并行子代理、云端开发、技能与自动化等高级功能。零基础也能上手这款 AI 编程 IDE,掌握模型选择、设计模式与 Git 版本控制的实用技巧。
Codex+Playwright封装测试Skill:UI自动化不再手敲命令
把 Playwright 封装成 Codex Skill,让 AI Agent 通过自然语言完成 UI 自动化测试。本文详解安装加载、Sauce Demo 实战、PO 分层模板,以及 MCP 与 CLI+Skill 的选型对照。
用Obsidian+AI智能体复刻2999元「得到大脑」全功能
用免费的Obsidian笔记软件搭配AI智能体,如何复刻年费2999元的得到大脑专家版?本文拆解发芽、点评、拷问、风格打磨、审稿、排版等核心功能的skills实现逻辑,助你搭建数据本地化、自由扩展的个人AI知识管理系统。