阶跃星辰Step 5预览版实测:小模型如何逼近Kimi与GLM
阶跃星辰Step 5预览版以小体量在权威榜单超越Kimi K3,本地实测多模态与推理表现喜忧参半。
国产大模型阶跃星辰Step 5预览版在Artificial Analysis榜单上以44分智能评分超越约2.8万亿参数的Kimi K3,引发关注。博主对其进行了本地Q4量化部署(约需315 GiB内存),测试覆盖多模态识别、代码生成和逻辑推理。亮点在于多档思考模式灵活可控、生产力应用网页原型生成质量较高,逻辑陷阱题表现扎实;短板则集中在复杂3D场景(如GTA城市、卡丁车)和部分游戏代码生成上频繁翻车。由于模型发布仅一小时即下架、推理代码非官方适配,博主对测试结果持审慎态度,但仍认为正式版若能维持此表现将"非常令人兴奋",值得持续跟踪。
国外AI博主近期对一款国产大模型展开了本地化实测,主角是阶跃星辰(Step Fun AI)推出的 Step 5 预览版。这款模型的特殊之处在于——它体量远小于同类旗舰,却在权威评测平台 Artificial Analysis 的排名中冲到了 Kimi K3 之前,与 Grok、GLM 仅一步之遥。这篇实测视频记录了它在本地推理、多模态理解、代码生成以及逻辑推理上的真实表现,也暴露了预览版仍有的诸多短板。
排名亮眼:小体量挑战万亿参数模型
据博主展示,在 Artificial Analysis 的榜单中,Step 5 的预览版智能分数达到 44 分,超过了拥有约 2.8 万亿参数的 Kimi K3,也压过了 GLM,仅次于 Astra 与 Opus 5 这类顶级闭源模型。博主特别强调,这只是 preview(预览)版本,而非完整发布版,且模型体量比竞品小得多。
阶跃星辰背后有阿里巴巴的重磅投资,被称为「中国最大规模的 AI 融资轮」之一,与通义千问广告(Qwen)团队同属阿里生态。博主用「先前发布采用 Apache 2 许可」来暗示其开源友好的传统,但也坦言这次的 Step 5 预览版授权情况尚不明确。
你可能没注意到,模型仅在发布当天开放了约一小时便被下架,官方计划在下月正式推出。这也意味着博主拿到的版本可能存在 bug,且官方并未同步释放完整的推理代码,测试结果需谨慎看待。
Artificial Analysis是一个专注于大模型综合性能评测的第三方平台,其「智能分数」(Intelligence Score)综合了模型在推理、编码、数学、知识问答等多个基准测试上的表现,试图给出一个横向可比的单一指标。该平台同时也会测量推理速度、上下文窗口和价格等维度,是开发者选型时常用的参考来源。需要注意的是,任何单一评测平台的排名都存在选题偏差,Artificial Analysis的分数与实际业务场景表现之间可能存在落差,博主对Step 5的实测结果也印证了评测分数与具体任务能力并不总是一一对应。
本地部署:Q4量化下的内存与速度
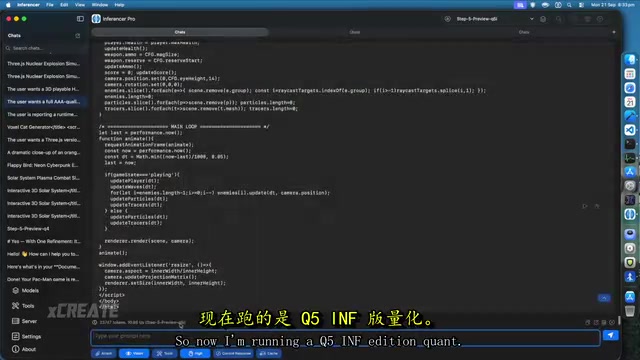
博主主要运行 Q4 量化版本,此时内存占用约为 315 GiB,生成速度大约每秒 20 tokens。为了对比不同精度的效果,他还尝试了 Q5、Q6 等更高量化版本,部分复杂任务在 Q4 下会频繁触发运行时错误,需要提高量化精度才能稳定输出。
模型支持多档思考模式——官方提供 low、medium、high 三级,博主还自行加入了「禁用思考」模式并验证其可用。他特别提到,Step 5 并非「暴力思考型」模型,不像某些版本会耗费 15 万 tokens、长时间推理才收敛。为此他甚至做了一个「立即回答」按钮,能在思考过程中强制中断并直接出结果。
由于官方随后放出了旧版推理代码,博主对其做了适配,这也是他反复强调「结果仅供参考」的原因。
量化(Quantization)是将模型权重从高精度浮点数(如FP16/BF16)压缩为低比特整数的技术。Q4表示每个权重用4位整数表示,相比原始FP16可将内存占用压缩约4倍,代价是精度略有损失。Q5、Q6则依次保留更多精度位数,内存占用随之增加但输出质量更稳定——这也是博主在FPS射击游戏等复杂任务中需要从Q4升至Q5才能稳定输出的原因。315 GiB的内存需求意味着即便是Q4版本,也需要配备多张高显存GPU或专业推理服务器才能本地运行,远超普通消费级硬件上限。
多模态与代码生成:亮点与翻车并存
Step 5 的一大卖点是多模态能力。博主给它一张猫的图片,它能准确识别出「橘色虎斑猫」,并据此生成 Three.js 版本的 3D 模型——尽管效果一般,但据称比 DeepSeek广告 V4 的同类生成要好。它还能把猫图转成体素(voxel)风格,带有会动的尾巴。
在代码生成上,测试项目相当丰富:
- 3D 太阳系:基础但可用,行星光照正常;
- FPS 射击游戏:Q4 下报错频繁,升到 Q5 后可一次成型输出 2.3 万 tokens,含红色关卡顶盖与走廊,可向敌人射击;
- 修改现有代码:给通义千问写的太阳系代码加入飞船和激光,效果被博主评价为「相当史诗」,成功炸毁太阳和行星,但碰撞检测不完美;
- 写实人脸渲染:即便在 Q1/Q4 极限量化下也能生成可随机化五官的人脸,被称为「对量化版本来说非常聪明」。
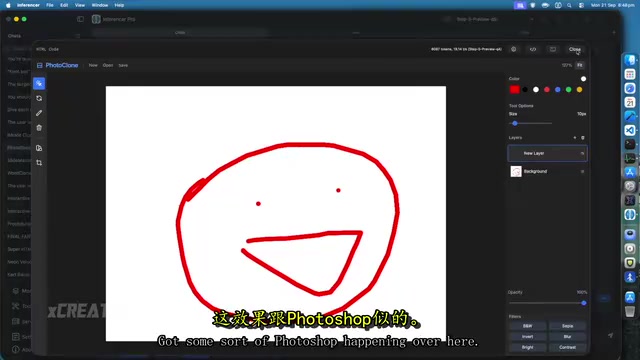
生产力应用是另一个惊喜。博主让它生成了 Blender、iMovie、Photoshop、MS Word 等应用的网页版原型:Blender 版本可旋转和添加立方体、导入建筑模型;iMovie 版本带时间轴,可添加标题、调整透明度并播放闪烁效果;Word 版本支持字号调整、加粗和分层。博主认为,这类基于 canvas 的网页应用与网站控件正是该模型的强项。
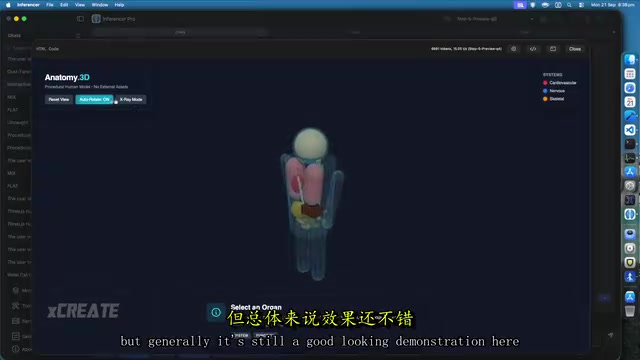
不过短板同样明显:GTA 风格城市生成中道路会直接开进建筑,城市结构过于单一;卡丁车赛车在 Q4 高思考模式下生成质量「很糟糕」;Final Fantasy、超级马里奥等项目基本失败;3D 人体解剖生成把心脏放错了位置,博主直接提醒「医疗信息别信」。
Three.js是一个基于WebGL的JavaScript 3D图形库,允许开发者在浏览器中创建和渲染交互式3D场景,无需额外插件。体素(Voxel)则是三维空间中类似像素的最小单元,常见于《我的世界》等游戏风格,由大量立方体堆砌构成。博主选择这两类任务作为测试项,是因为它们能直观展示模型对三维空间关系的理解能力,以及将自然语言描述转化为可运行代码的能力——这对大模型而言兼具创意理解和代码生成两个层面的挑战,是衡量多模态与编程能力融合程度的有效指标。
逻辑推理:表现意外扎实
在逻辑与陷阱题测试中,Step 5 的表现反而稳定。它正确解答了「8 个橙子 4 个孩子」的平均分配问题,没有被「刀」这个干扰项带偏;面对经典的「外科医生是男孩的父亲」陷阱题,它没有落入「外科医生一定是母亲」的训练偏见;数学题在 high 思考模式下也给出了「必须是偶数」的正确答案。
博主推测,这类推理题或许正是它在 Artificial Analysis 上拿高分的原因所在。编程细节题上则各有胜负:C++ 标准 vector、Swift 基础字符串函数处理得当,但 WinRT 相关题目即使高思考模式也答错。安全机制方面,模型会拒绝生成核武器相关代码,输入直接被判定为无效。
结语:值得期待的下一步
博主的整体评价是审慎乐观的。他坦言不太理解 Step 5 preview 是如何在榜单上「击败 Kimi K3」的,认为 Kimi 在某些生成任务上或许更强,也怀疑是否与自己适配的推理代码有关。但他强调一个关键事实:如果一款仅需约 300 GiB 内存的 Q4 量化模型,真能在正式版中做到接近 Grok 4.6 和 Kimi K3 的水平,那将「非常非常令人兴奋」。
截至测试时,Step 5 尚未上架 Hugging Face,无法公开下载,官方预计下月正式发布。对于关注国产开源大模型、尤其是想在本地部署高性价比模型的开发者来说,这是一款值得持续跟踪的产品。
相关推荐
本地运行Pixel 3D多视图:8GB显存免费生成高精度3D模型
Pixel 3D多视图功能已原生集成ComfyUI,8GB显存即可本地免费生成高精度3D模型。本文详解安装、模型下载、Flux免费视图生成、显存需求及单视图/多视图实测对比。
Qwen Image 2.1 本地实测:开源图像编辑能否叫板闭源?
阿里 Qwen Image 2.1 图像编辑模型开源,B站UP主梨花本地实测七组案例并分享工作流与提示词模板。本文详解模型构成、8GB显存部署门槛、ComfyUI关键设置,以及与GPT等闭源产品的横向对比结论。
8G显存本地跑通MiniMax H3:ComfyUI整合包实测
MiniMax H3 海螺开源视频模型 8G 显存本地部署实测,基于秋叶 ComfyUI 整合包和 4步 Lora 提速,附四类模型下载、关键参数设置与效果分析,一键解压即用,免费无排队。