KLD指标被误解:量化模型评测的真相

KLD只是诊断量化模型偏移的工具,绝非可横向比较的排行榜,且极易被校准数据泄漏刷分。
文章指出,KLD(KL散度)在量化社区被误当作衡量模型质量的“圣杯”,但它实际只衡量量化模型在特定数据集上偏离原始模型的程度,并不直接对应下游任务表现。用维基百科或随机文本计算KLD缺乏代表性,更合理的做法是使用模型自生成数据并忽略prompt token。KLD最危险之处在于极易被操纵:校准数据与评测数据重合、或直接在同一数据上微调量化参数,都能以近乎零成本大幅美化数字。相比之下,benchmark刷分门槛更高。因此KLD应定位为诊断工具,用于观察分布偏移趋势和对比量化配置,而非通用排名依据;社区需要更透明的报告规范,明确数据来源并区分校准与评测数据。
在模型量化社区,KLD(KL散度)经常被当作衡量量化模型质量的"圣杯"——似乎只要这个数字够低,模型就够好。但最近Reddit上的一篇讨论指出,这种认知存在严重偏差。KLD只是一个诊断工具,远非量化模型的通用排行榜。
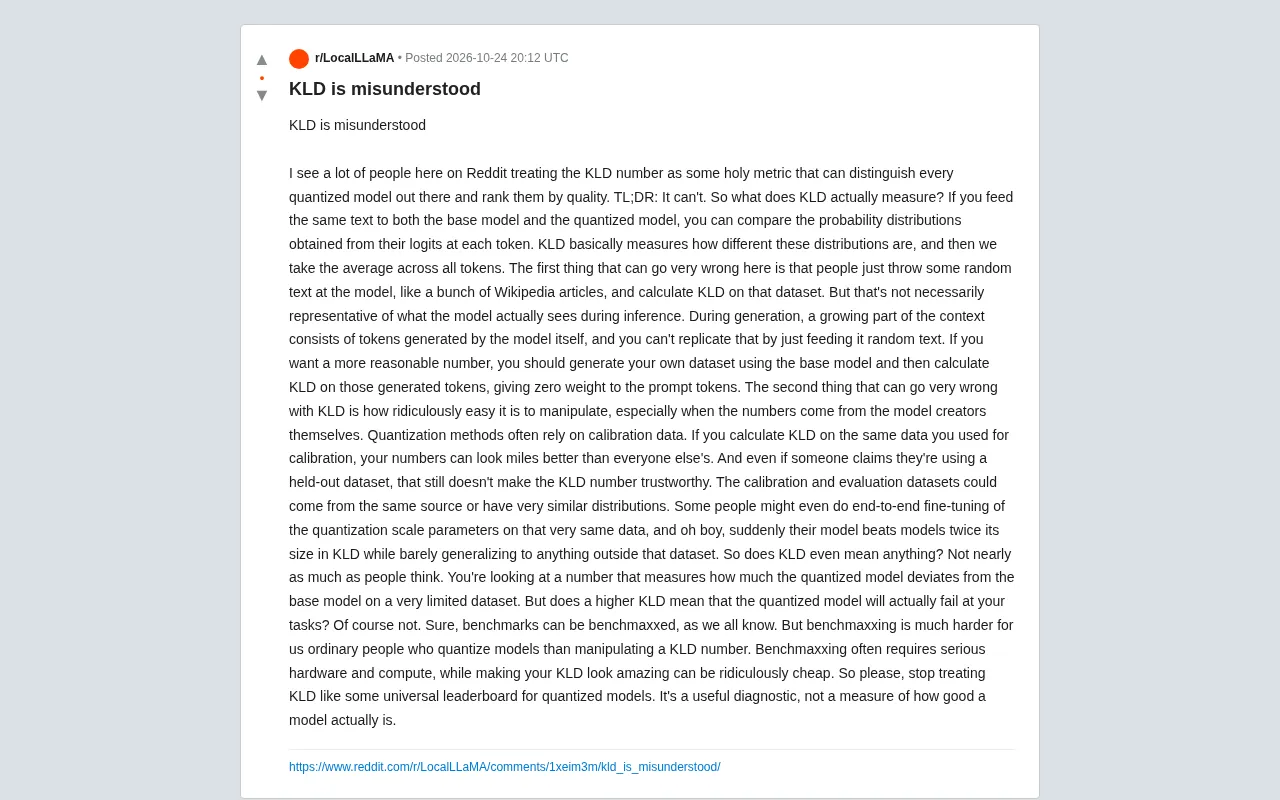
KLD到底在测量什么
KLD的核心逻辑并不复杂:把同一段文本分别喂给原始模型和量化模型,比较两者在每个token位置输出的概率分布差异,再对所有token取平均。数字越小,说明量化模型越接近原始模型的行为。
问题在于,这个定义本身就埋下了隐患。它衡量的是"在特定数据上"的偏离程度,而不是模型在实际使用中的表现。很多人直接拿维基百科文章或随机文本跑一遍KLD就下结论,但模型推理时面对的是自己生成的上下文,这种分布和静态文本截然不同。
更合理的做法是让原始模型自己生成数据集,然后在这些生成token上计算KLD,并且对prompt token赋予零权重。这样才能更贴近真实推理场景。
KL散度(Kullback-Leibler Divergence)衡量两个概率分布之间的差异,公式为 (D_{KL}(P|Q)=\sum_x P(x)\log\frac{P(x)}{Q(x)})。它是不对称的:用原始模型分布P去衡量量化模型分布Q,与反过来计算,结果并不相同。在量化评测中通常固定以原始模型为参考分布P。KLD的一个关键性质是它衡量的是“相对熵”,即用量化模型分布去编码原始模型输出时额外需要的比特数,因此单位是比特/Token。数值本身没有绝对的好坏阈值,只有当两个模型在同一数据、同一计算方式下比较时才有意义。此外,KLD对分布尾部敏感——量化模型只要在低概率token上给出极低概率,就会显著拉高KLD,即使这些token对生成质量影响甚微。理解这些数学特性,有助于明白为什么KLD容易被个别样本主导,也解释了为何不同论文报告的KLD数值往往不可直接横向比较。
为什么KLD极易被操纵
KLD最危险的地方在于它的可操纵性。量化方法通常依赖校准数据,如果有人在计算KLD时使用了和校准相同的数据,数字会好看得离谱。即使声称用了held-out数据集,也不能完全信任——校准集和评测集可能来自同一来源,分布高度相似。
更极端的情况是,有人直接在同一份数据上对量化scale参数做端到端微调。结果就是模型在KLD上碾压参数量两倍的对手,但在数据集之外几乎不泛化。这种"KLD刷分"的成本极低,和传统benchmark刷分需要大量算力完全不同。
校准数据(calibration data)是训练后量化中的关键环节。以GPTQ、AWQ等主流方法为例,它们需要一小批文本(通常128到1024条)来统计激活值的分布范围,从而确定每层权重的最优量化scale和零点。校准集的质量和代表性直接影响量化误差。问题在于,许多量化工具默认使用维基百科或C4语料作为校准集,而评测者计算KLD时也常从同一语料采样,这就造成了“训练集即测试集”的泄漏。严格来说,校准数据应视为量化模型的“训练数据”,任何在其上或同分布数据上计算的KLD都应被看作训练误差而非泛化误差。透明的报告规范应明确区分校准语料与评测语料,最好使用模型自生成文本或与校准集来源完全不同的语料来计算KLD,否则数字再低也无法说明模型在真实场景中的表现。
KLD高就意味着模型差吗
答案是否定的。KLD只反映量化模型在有限数据集上偏离原始模型的程度,并不直接对应下游任务表现。一个KLD稍高的模型,完全可能在你的具体任务上表现良好。
当然,benchmark本身也可以被刷,但对普通量化者来说,刷benchmark需要真金白银的硬件和算力,而美化KLD几乎零成本。这就导致KLD数字的可信度天然低于benchmark——至少后者还有一定的门槛。
下游任务表现通常通过标准benchmark衡量,如MMLU、HellaSwag、ARC、GSM8K等,它们分别考察知识问答、常识推理、科学推理和数学能力。这些benchmark的题目和答案公开,因此也存在被针对性训练的风险,但其刷分成本远高于KLD:需要微调模型、消耗大量GPU算力,且容易在held-out测试集上暴露过拟合。相比之下,KLD刷分只需在评测数据上调整量化scale,几乎不改变模型权重,成本极低。值得注意的是,KLD与benchmark表现之间并非线性关系——有研究发现,当KLD低于某一量级时,下游指标几乎不受影响;只有KLD显著升高时,任务性能才开始明显下降。因此,把KLD当作“一票否决”的排行榜,既不公平也不科学。
正确看待KLD的方式
KLD有用,但它的定位应该是诊断工具而非排名依据。合理的用法包括:观察量化前后的分布偏移趋势、对比不同量化配置在同一数据上的相对差异、辅助排查异常。但如果要判断一个量化模型是否适合你的任务,最终还是得跑真实场景的评测。
社区需要建立更透明的KLD报告规范:明确数据集来源、区分校准与评测数据、优先使用模型自生成数据。否则,这个指标只会继续被误用和滥用。
相关推荐

Codex零基础教程:接国内大模型+四大实战案例
Codex零基础新手教程:三步完成下载安装并接入DeepSeek国内大模型,配合CC Switch切换,详解必装插件与技能,附PPT制作、动态图表、深度调研、工作台搭建四大实战案例的完整操作流程。

Claude 识别败血症前兆,Reddit 用户称 AI 救了自己一命
Reddit 用户分享深夜突发排尿困难、意识模糊等症状,Claude 判断为败血症前兆并建议立即就医,医生证实若拖延可能致命。探讨 AI 在健康预警中的潜力与局限。

三星断网我的洗衣机,Claude帮我恢复了智能控制
三星停止支持十年旧洗衣机的Smart Control功能,用户借助Claude逆向工程通信协议,两小时恢复联网控制并与烘干机联动。探讨厂商支持策略、AI赋能的数字修复权及智能家居安全隐患。