扩散模型入门:从DDPM原理到UNet实战代码

从DDPM前向加噪、反向去噪到UNet代码实现,梳理扩散模型完整脉络并与GAN对比。
本文基于一篇视频教程,系统梳理扩散模型从DDPM理论到UNet代码实现的完整脉络。文章先对比GAN的对抗训练不稳定性,说明扩散模型以加噪与去噪两阶段提供更可控的生成路径;随后推导前向过程的闭式公式,使任意时刻x_t可直接由x₀计算;再解释反向过程如何用贝叶斯公式转化为训练UNet预测噪声,并给出均值表达式与均方误差损失;最后介绍UNet结构、时间步位置编码、采样流程及常见疑问,指出扩散模型训练稳定但采样较慢,是理解现代图像生成系统的必经之路。
扩散模型(Diffusion Model)已成为图像生成领域的主流范式,但原始论文中密集的数学推导常让入门者望而却步。本文基于一篇保姆级视频教程,梳理从DDPM(Denoising Diffusion Probabilistic Models)前向加噪、反向去噪到UNet代码实现的完整脉络,并穿插对GAN痛点的对比分析,帮助读者建立直观理解。
从GAN到扩散模型:为什么需要新范式
生成对抗网络(GAN)通过生成器与判别器的博弈来提升生成质量,但训练过程极不稳定。教程用“游戏托”的比喻解释这种动态:生成器不断升级试图骗过判别器,判别器也随之调整,双方陷入无休止的对抗。这种博弈导致损失曲线剧烈波动,模型容易学到偏见或走捷径,多样性也受限。
扩散模型则提供了一条更可控的路径。它不依赖对抗训练,而是将生成过程拆解为“加噪”与“去噪”两个阶段,每一步都有明确的数学形式。据B站UP主在教程中回忆,扩散模型的概念早在2015年就有论文提出,但直到DALL·E系列展示出惊艳效果后才真正进入大众视野。
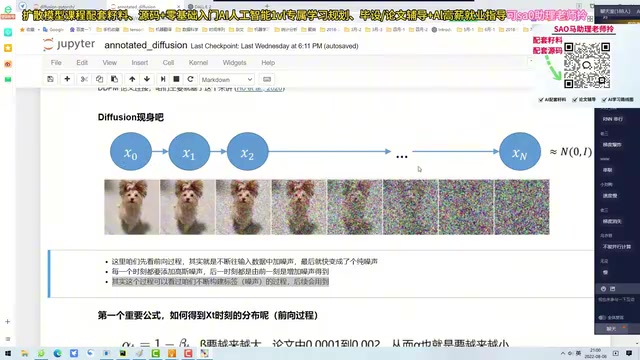
马尔可夫链(Markov Chain)是扩散模型数学框架的基石。它描述一个状态序列,其中每个状态只依赖于前一个状态,与更早的历史无关,这一性质称为马尔可夫性。在扩散模型中,前向过程的每一步加噪都被建模为一个马尔可夫转移:给定x_{t-1},x_t的分布仅由转移核q(x_t | x_{t-1})决定,与x_{t-2}及更早的状态条件独立。正是这一性质使得整条加噪链的联合分布可以分解为逐步转移概率的乘积,从而为后续推导闭式边缘分布q(x_t | x₀)和变分下界提供了数学便利。反向过程同样被建模为马尔可夫链,学习从x_t到x_{t-1}的转移。理解马尔可夫性是读懂DDPM损失函数推导的前提。
前向过程:把图像逐步变成噪声
前向过程(Forward Process)是一个固定的马尔可夫链:从原始图像x₀开始,每一步加入少量高斯噪声,经过T步后得到纯噪声x_T。教程强调,噪声的方差由预设的β_t调度控制,β_t随时间递增,意味着越往后加入的噪声越多。
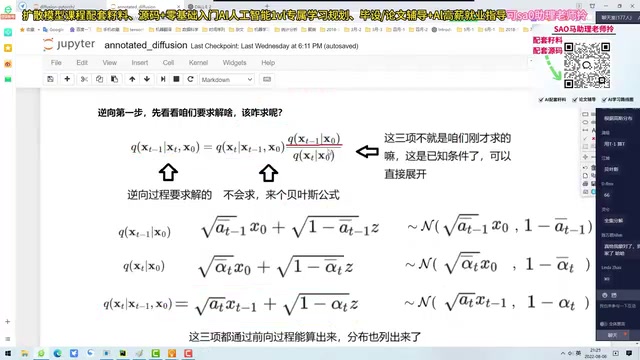
关键推导在于:任意时刻x_t的分布可以直接由x₀和t计算出来,无需逐步迭代。公式为:
x_t = √(ᾱ_t) · x₀ + √(1 - ᾱ_t) · ε
其中ᾱ_t是α_t = 1 - β_t的累乘,ε是标准高斯噪声。这一性质极大简化了训练:模型可以随机采样一个t,直接构造x_t,而不必模拟完整链条。教程用“三亚游客”的比喻说明加噪的递进性:一开始加少量噪声就能显著改变图像,越往后需要加更多噪声才能掩盖信号。
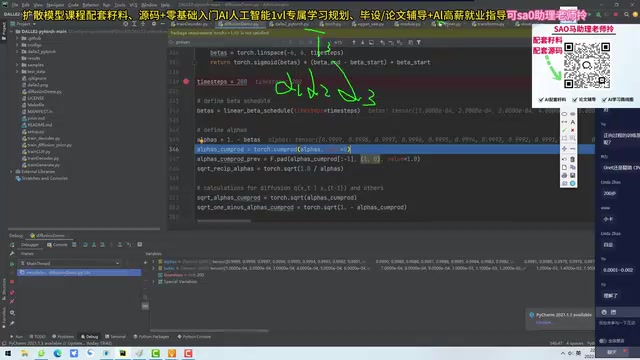
β_t调度(Noise Schedule)是前向过程中控制加噪节奏的关键超参数。β_t是一个预先设定、不参与训练的小正数序列,通常从β_1≈1e-4线性或余弦增长到β_T≈0.02。它决定了每一步加入高斯噪声的方差,进而通过α_t = 1 - β_t和累乘ᾱ_t影响信号保留比例。若β_t过小,加噪过慢,T需要很大才能到达纯噪声;若β_t过大,早期就破坏图像结构,模型难以学习细粒度去噪。原始DDPM采用线性调度,后续工作(如Nichol & Dhariwal)提出余弦调度,使ᾱ_t的衰减更平滑,在低分辨率和高分辨率图像上都表现更稳定。调度选择直接影响生成质量与训练收敛速度。
反向过程:从噪声中重建图像
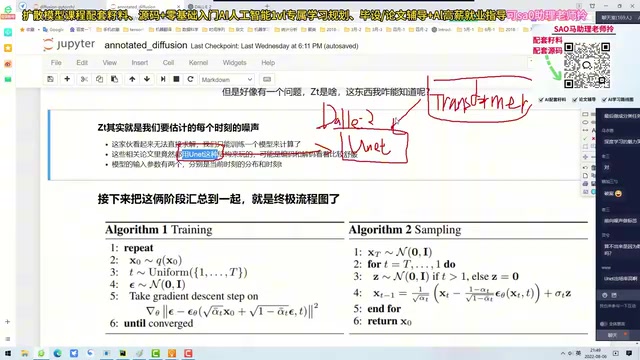
反向过程(Reverse Process)的目标是学习p(x_{t-1} | x_t),即给定噪声图像预测前一步的分布。理论上,这个条件分布可以用贝叶斯公式转化为前向过程的形式,但其中包含一个无法直接计算的项——噪声ε。
教程推导出均值μ_θ的表达式:
μ_θ(x_t, t) = (1/√α_t) · (x_t - (β_t / √(1 - ᾱ_t)) · ε_θ(x_t, t))
其中ε_θ就是需要训练的神经网络,它输入x_t和t,输出对噪声的预测。方差在原始DDPM中设为固定值,但教程指出后续改进版本允许方差也可学习。
训练与采样:UNet如何学习预测噪声
训练阶段的核心是让UNet预测噪声。具体流程为:从数据集采样x₀,随机选一个时间步t,采样噪声ε,构造x_t,然后让UNet输出ε_θ,损失函数为均方误差||ε - ε_θ(x_t, t)||²。教程代码使用Fashion-MNIST数据集,UNet输入包含x_t和t的位置编码,输出与输入同尺寸的噪声预测。
采样阶段则从纯噪声x_T出发,迭代调用训练好的UNet预测噪声,按公式计算x_{t-1},逐步去噪直至x₀。教程在代码中设置T=200(原始论文为2000),并在CPU上演示了生成过程。生成结果虽不完美,但已能看出服装轮廓。
位置编码(Positional Encoding)在扩散模型中用于让网络感知时间步t。由于UNet的卷积操作本身对时间步没有概念,必须将标量t转换为高维向量再注入网络。DDPM沿用Transformer中的正弦位置编码:对每个时间步t,用不同频率的正弦和余弦函数生成一组固定维度的嵌入向量,再经过两层全连接映射到与特征图通道数匹配的维度,最后通过逐元素相加或FiLM方式调制各层特征。这种编码使网络能够区分不同噪声水平,从而对早期(信号强)和后期(噪声强)阶段采取不同的去噪策略。时间步嵌入的质量对生成效果有显著影响,后续工作也探索了可学习嵌入等变体。
代码实现要点与常见疑问
UNet结构包含下采样、中间块和上采样,时间步t通过正弦位置编码嵌入,再与特征图相加。教程特别提到,UNet中额外加入的注意力机制令人费解,作者猜测可能仅为了增加创新点。对于“为什么T不能反向传播”的疑问,教程解释采样操作本身不可导,但训练时损失函数是对噪声预测的回归,梯度可以正常回传。
数据集的选择直接影响生成内容:输入纯噪声时,模型会还原出训练集中最常见的类别。教程建议初学者从小数据集(如Fashion-MNIST)入手,逐步理解原理后再尝试更大规模任务。
扩散模型的价值在于其清晰的数学框架和稳定的训练特性,尽管采样速度较慢,但后续的改进(如DDIM、潜在扩散)不断推动其走向实用。对于想要深入生成模型的研究者,从DDPM入手是理解现代图像生成系统的必经之路。
相关推荐
达芬奇如何证明太阳是热的?一段被忽视的科学史
达芬奇如何用凹面镜实验推翻亚里士多德的冷太阳理论?本文梳理这段被忽视的科学史,揭示科学思维在十五世纪的萌芽,以及达芬奇对太阳发热和生命本质的冷峻观察。
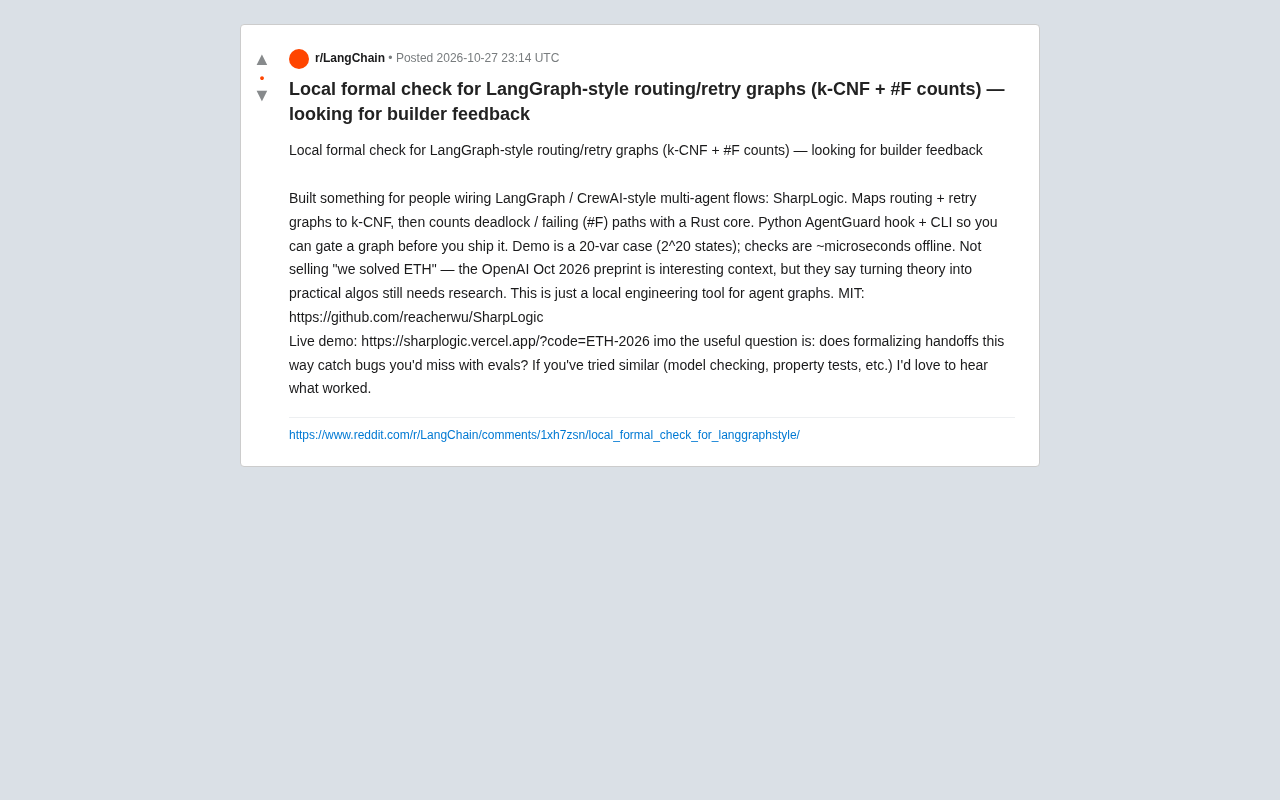
SharpLogic:用k-CNF为LangGraph路由图做形式化查错
SharpLogic开源项目将LangGraph风格的多智能体路由与重试图映射为k-CNF,用Rust内核统计死锁与失败路径(#F计数),提供Python AgentGuard钩子与CLI,在发布前做形式化门禁检查。本文分析其原理、与评测的互补关系及社区关注的建模成本问题。
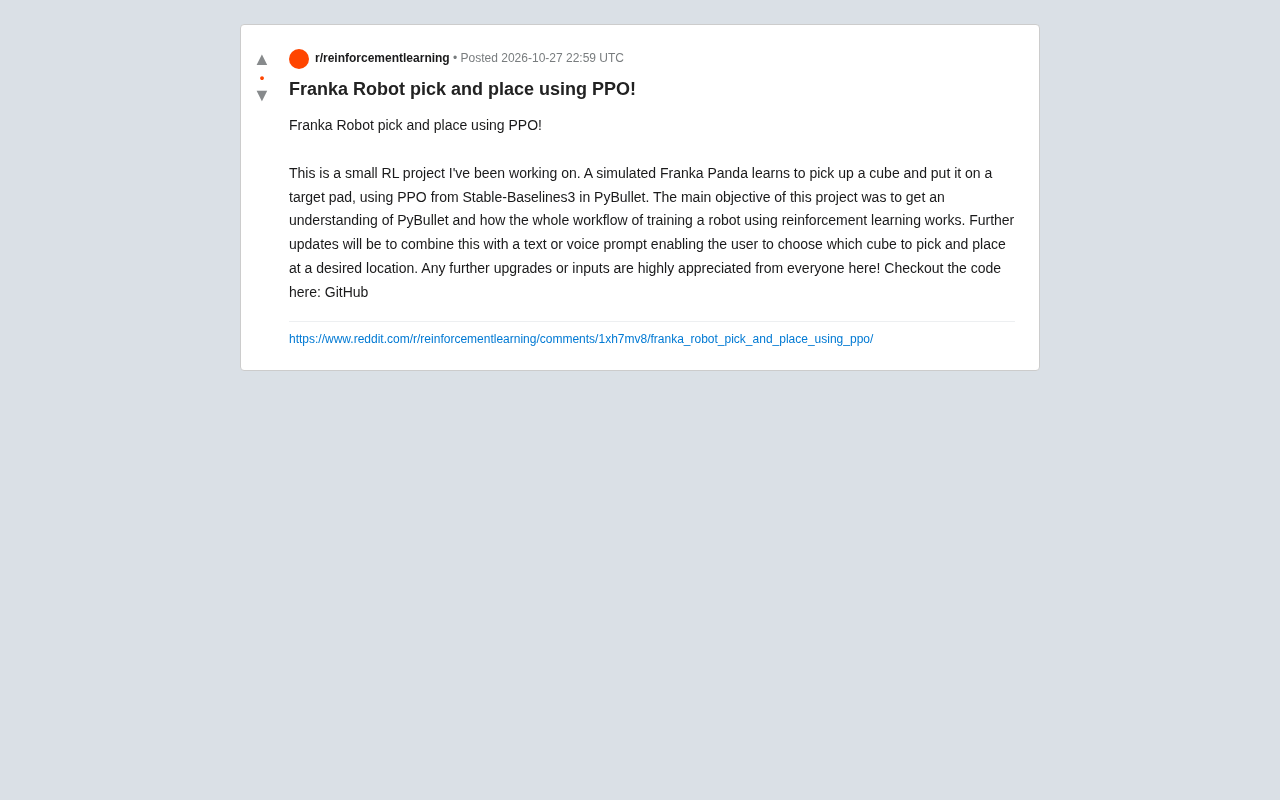
PPO训练Franka机械臂抓取放置:一个强化学习入门项目
一个用PPO算法在PyBullet中训练Franka Panda机械臂完成抓取放置任务的强化学习项目,涵盖技术栈选型、任务设计难点与未来文本/语音指令交互计划,适合入门者参考。