#扩散模型
共 14 篇相关文章
条件扩散模型学习跳跃-扩散过程转移核:理论与实证新进展
一篇arXiv新研究提出用条件扩散模型学习跳跃-扩散过程的转移核,建立了得分估计误差与KL散度的非渐近理论界,并在合成与真实数据上验证了其概率预测性能,为随机过程建模提供全新范式。
流匹配模型为何能摆脱维度灾难:低维数据的泛化理论解析
最新 arXiv 论文从理论上证明流匹配与扩散模型能自适应数据的内在低维结构,缓解维度灾难。本文解析其 Wasserstein-p 误差界、内在维度收敛率及对生成模型泛化理论的意义。
ENCORE:首个精确并行推理控制方法,让扩散模型生成更可控
arXiv 论文 ENCORE 提出首个精确的并行推理控制方法,通过存储生成轨迹绕开难以处理的时间反演,实现扩散模型的无偏可控生成,在分子采样与图像生成等任务上验证了其精度、多样性与鲁棒性。
RASS:排名感知推测采样如何为扩散模型提速20%
arXiv 新论文提出 Rank-Aware Speculative Sampling(RASS),通过排名感知的列表耦合优化扩散模型推测采样草稿树,在 CIFAR-10、FFHQ 及 Stable Diffusion 3.5 等任务上实现最高约20%的加速,且保持精确采样。
SatisDive:文生图扩散中平衡满意度与多样性的新方法
arXiv 最新论文提出 SatisDive,一种无需训练、推理阶段即可使用的文生图方法,通过奖励下限与多样性截断重构生成为满足式任务,在 Pick-a-Pic 上全面 Pareto 支配 FK steering,有效平衡图像满意度与多样性。
离散扩散模型的置信度困境:为何并行生成会偏离真实分布
《Limits of Confidence in Diffusion》研究揭示离散扩散模型并行生成的根本限制:只有条件独立的token位置才能同步写入,而像素、音素、词语等真实数据普遍存在依赖关系,导致乘积分布无法匹配真实训练分布。
生成式Gibbs采样:用物理上下文组合扩散模型
芝加哥大学Wei Zhou提出广义Gibbs采样框架,通过在推理时组合预训练扩散模型与显式物理上下文,解决联合系统采样的数据稀缺与模块化难题。本文解析其在二次相互作用下的无偏采样原理及量子统计、格点模型、多肽体系中的应用。
Spectral Feedback:让蛋白质扩散模型学会自我纠错
Spectral Feedback 是一种面向蛋白质扩散模型测试时对齐的新算法,通过重新掩码和重新采样实现自我纠错。它利用稀疏傅里叶结构高效选择编辑位置,在蛋白质反向折叠任务中使预训练模型稳定蛋白质提升32.3%。
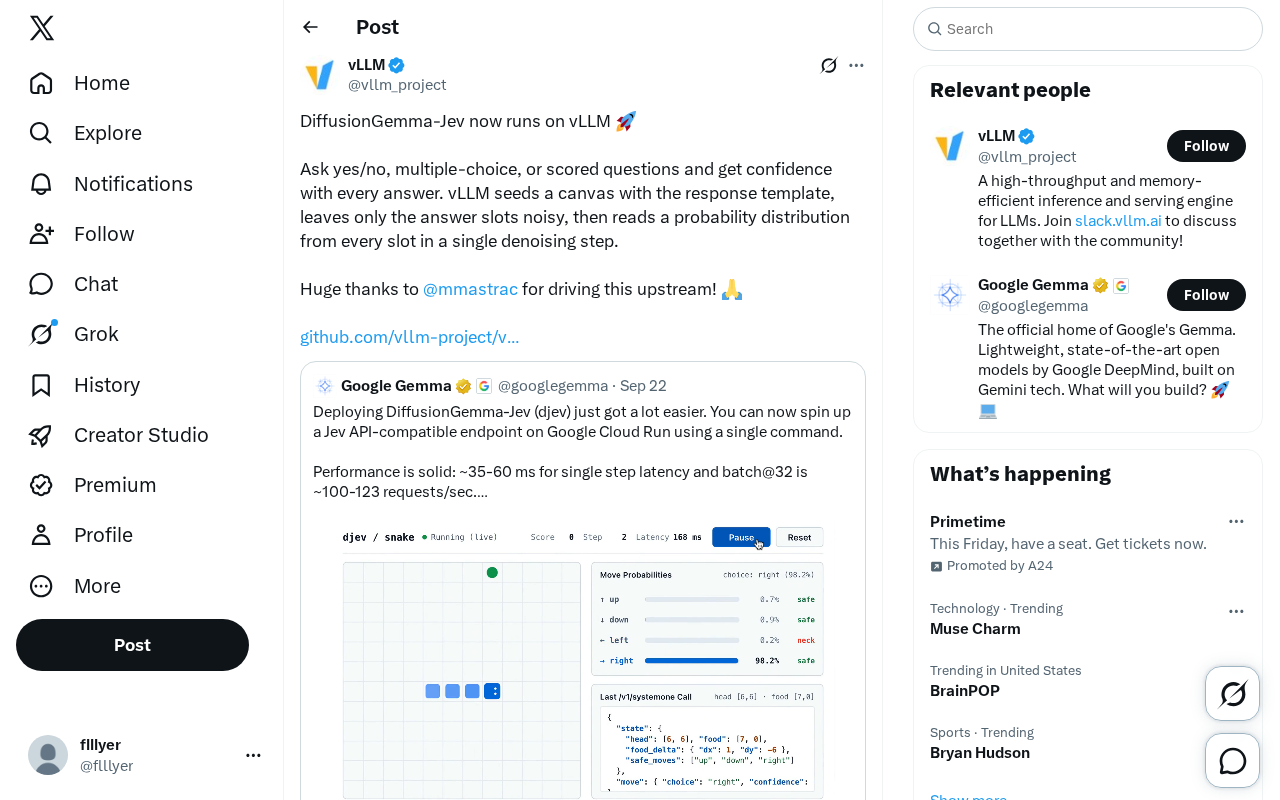
DiffusionGemma-Jev接入vLLM:让每个回答都带置信度
DiffusionGemma-Jev 现已支持 vLLM 运行,可对是非题、选择题和打分题输出带置信度的答案。通过单步去噪读取每个答案槽位的概率分布,扩散语言模型迈向生产化部署。
Probe Guidance:无需额外推理开销的流匹配引导新方法
Probe guidance 是一种引导流匹配模型的新方法,利用扩散模型冻结的内部状态构造引导信号,无需推理时额外前向传播,并在连续扩散语言模型的无条件生成任务上刷新最优性能。
DACA-GRPO:为扩散语言模型强化学习引入去噪感知信用分配
DACA-GRPO 是一种为扩散语言模型强化学习设计的去噪感知信用分配方法,解决时序信用分配缺失与似然估计偏差两大问题,可即插即用地增强任何GRPO训练器。
 科技前沿
Mercury 2:扩散架构如何实现每秒1000 Token的推理速度
 科技前沿
Mercury 2 实测:扩散模型驱动的最快推理大模型,18秒生成完整游戏
深度实测 Inception Labs 发布的 Mercury 2 扩散模型,对比 Claude Haiku、Gemini Flash 等主流模型,覆盖代码生成、结构化推理、长程规划等场景,解析其每秒1000+ Token的速度优势与实际表现。
 前沿研究
SVDQuant:4-bit量化让扩散模型在消费级GPU上高效运行
SVDQuant是ICLR 2025 Spotlight论文,通过低秩分解吸收异常值实现扩散模型4-bit量化,显存降低75%。开源项目Nunchaku获3800+ Stars,让FLUX等大型图像生成模型在RTX 4060等中端显卡上流畅推理。