流匹配模型为何能摆脱维度灾难:低维数据的泛化理论解析
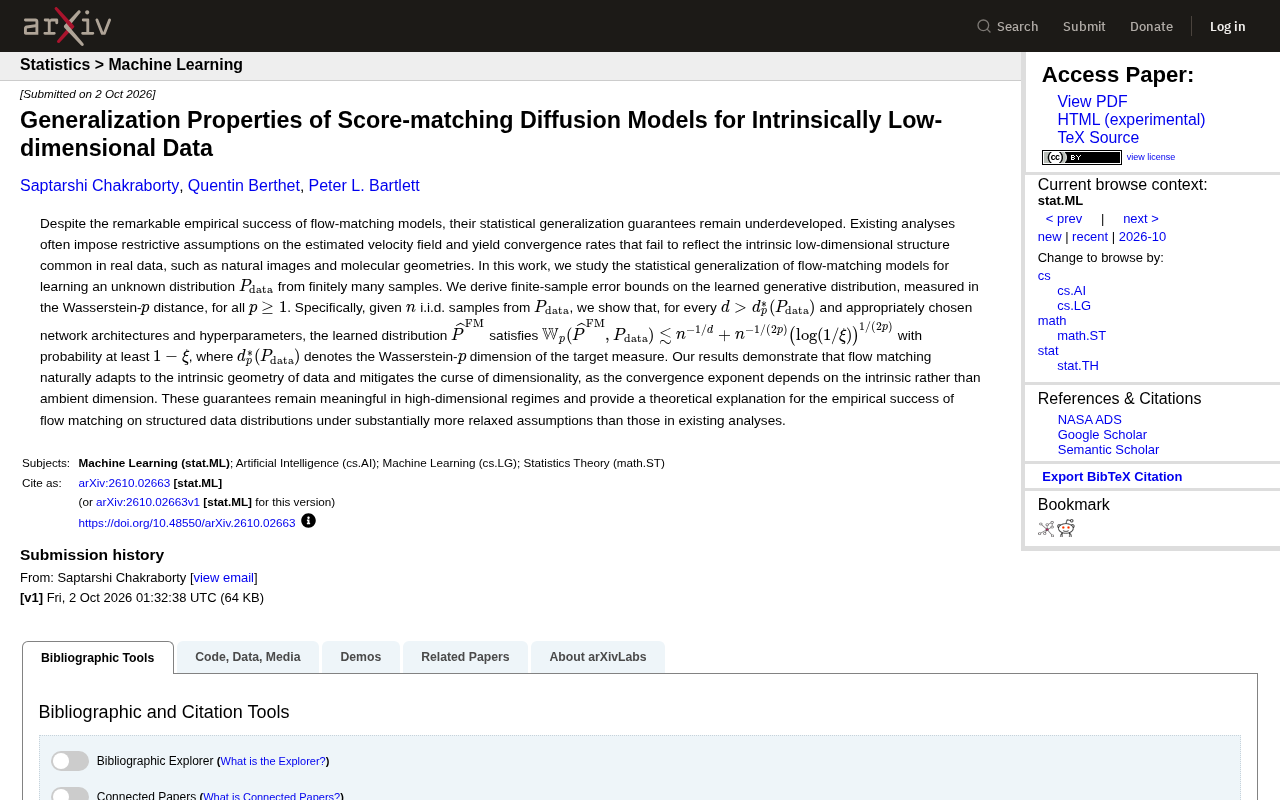
新论文证明流匹配的泛化误差由数据内在维度而非环境维度决定,从理论上解释了其对抗维度灾难的能力。
这篇 arXiv 论文(arXiv:2610.02663)针对流匹配与扩散模型长期缺乏严谨泛化理论的空白,在本质低维数据假设下推导出有限样本的 Wasserstein-$p$ 误差界。核心结论是:学习所得生成分布与真实数据分布之间的 Wasserstein-$p$ 距离,其收敛速度的指数由数据的 Wasserstein-$p$ 内在维度 $d_p^*$ 决定,而非像素空间或分子构型空间等高维环境维度。这意味着当数据真实分布集中于低维结构时,模型的样本效率由该低维结构主导,从而缓解维度灾难。相比以往工作,该结论在对速度场假设显著放宽的前提下成立,且覆盖所有 $p \geq 1$ 的 Wasserstein 距离。这为流匹配在自然图像、分子几何等结构化数据上的实证成功提供了可量化的理论支撑。
一个长期悬而未决的理论问题
流匹配(Flow Matching)与扩散模型(Diffusion Models)在图像生成、分子结构建模等任务上取得了令人瞩目的实证成绩,但它们背后的统计泛化保证却长期处于欠发达状态。换句话说,我们知道这类模型"用起来很好",却缺乏严谨的数学解释来说明它们为何能从有限样本中学到真实的数据分布。
一篇最新的 arXiv 论文(arXiv:2610.02663)正是瞄准了这一空白,系统地研究了基于分数匹配的扩散模型/流匹配模型在本质低维数据上的泛化性质。研究的核心贡献,是给出了学习分布的有限样本误差界,并以此解释了为何流匹配能在高维场景中依然保持有效。

现有分析的两大局限
要理解这项工作的价值,先要看清楚过往理论的短板。
假设过于苛刻
以往对流匹配/扩散模型的泛化分析,往往需要对估计出的速度场(velocity field)施加较强的限制性假设。这些假设在数学推导上方便,但与真实训练中神经网络学到的速度场相去甚远,使得理论结论的实际指导意义大打折扣。
速度场(velocity field)是流匹配框架的核心对象。流匹配的思路是学习一个时间依赖的向量场 $v_t(x)$,使得由该向量场驱动的常微分方程(ODE)能把一个简单的参考分布(如标准高斯)"传输"到目标数据分布。训练目标是让神经网络预测的速度场与某个参考速度场之间的均方误差最小——这即"分数匹配"(score matching)思想在流匹配中的体现。以往理论分析为了在数学上可处理,往往假设估计出的速度场具有全局 Lipschitz 连续性、有界范数或特定的正则性,但深度网络在实际训练中并不保证满足这些性质,导致理论与实践之间存在根本性的鸿沟。
收敛率无法反映数据的内在结构
真实世界的数据——比如自然图像、分子几何构型——虽然名义上处于极高维的空间中,但实际上集中分布在一个远低于环境维度(ambient dimension)的低维流形附近。然而现有的收敛率分析通常依赖于环境维度,导致理论预测的收敛速度在高维下几乎失效,这就是所谓的"维度灾难"(curse of dimensionality)。理论说模型学不好,实践中模型却表现优异,两者严重脱节。
低维流形假设(Manifold Hypothesis)是这一问题的核心背景:它认为高维观测数据(如图像、语音、分子构型)实际上近似分布在一个嵌入高维空间的低维黎曼流形上。例如,一张 256×256 的彩色图像名义上有约 20 万个像素维度,但"看起来自然"的图像在这个空间中只占极微小的子集,其内在自由度可能只有数百甚至更少。维度灾难(Curse of Dimensionality)在经典统计学中有精确含义:在非参数密度估计中,达到 $\varepsilon$ 精度所需的样本量随环境维度 $D$ 呈 $\varepsilon^{-D}$ 级别增长,使得在 $D$ 很大时样本需求变得不可实现。正因如此,若理论界依赖环境维度来刻画收敛速度,结论在实践中便毫无指导意义——它预测的所需样本量远超任何现实数据集的规模。
核心结果:误差界与内在维度
论文的主要成果是,从 $P_{\mathrm{data}}$ 中独立同分布地抽取 $n$ 个样本后,学习得到的生成分布 $\widehat{P}^{\mathrm{FM}}$ 在 Wasserstein-$p$ 距离下满足有限样本误差界。
具体而言,对于所有 $p \geq 1$,以及任意满足 $d > d_p^\ast(P_{\mathrm{data}})$ 的 $d$,在恰当选择网络架构与超参数的前提下,以至少 $1-\xi$ 的概率有:
$$\mathbb{W}p(\widehat{P}^{\mathrm{FM}}, P{\mathrm{data}}) \lesssim n^{-1/d} + n^{-1/(2p)}\bigl(\log(1/\xi)\bigr)^{1/(2p)}$$
其中 $d_p^\ast(P_{\mathrm{data}})$ 表示目标测度的 Wasserstein-$p$ 维度。
这个式子看起来复杂,但关键信息很清晰:收敛速度的指数由数据的内在维度决定,而非环境维度。这意味着,哪怕图像被表示在数百万维的像素空间中,只要其真实分布集中在一个低维结构上,模型的样本效率就由那个低维结构主导。
Wasserstein-$p$ 维度(记作 $d_p^(P)$)是理解该误差界的关键概念,它刻画了概率测度 $P$ 的"有效内在复杂度"。直观上,它捕捉了在 Wasserstein-$p$ 意义下逼近 $P$ 所实际需要的维度,比拓扑意义上的流形维度更具统计操作性。当数据分布 $P_{\mathrm{data}}$ 支撑在一个 $d_0$ 维光滑子流形上时,$d_p^$ 通常与 $d_0$ 同阶,远小于环境维度 $D$。误差界中的 $n^{-1/d}$ 项正是经典非参数估计中"$d$ 维分布需要 $n^d$ 个样本"规律的体现;而 $n^{-1/(2p)}$ 项则来自随机误差,反映了有限样本波动的贡献。两项中取主导的那一个决定了整体收敛速度,而两者的指数都与数据内在结构挂钩,与环境维度无关。
为什么这能缓解维度灾难
维度灾难的本质,是误差随维度升高而指数级恶化,使得在高维空间中需要天文数字般的样本才能学好分布。而这项研究表明,流匹配天然地适应数据的内在几何结构:收敛指数挂钩的是 $d_p^\ast$ 而非环境维度 $D$。
当内在维度远小于环境维度时,$n^{-1/d}$ 这一项的衰减速度显著快于基于环境维度的界。于是即便在高维场景下,误差界依然保持有意义(meaningful in high-dimensional regimes),而不会退化为空洞的结论。这为流匹配模型在结构化数据分布上的实证成功,提供了一个坚实的理论解释。
意义与影响
从理论研究的角度看,这篇论文的价值体现在三个层面。
其一,它在显著放宽假设的前提下给出了泛化保证——相比以往需要对速度场施加强约束的分析,门槛更低、更贴近实际。
其二,它覆盖了所有 $p \geq 1$ 的 Wasserstein-$p$ 距离,而不是仅限于某个特定度量,结论的普适性更强。
其三,它把"实践有效"与"理论可证"之间的鸿沟缩小了一步。长期以来,生成模型社区更多依赖经验直觉来解释低维结构带来的好处,而这项工作把这种直觉形式化为可量化的收敛率。
对于从事生成模型、扩散/流匹配方法研究的学者,以及关心模型样本复杂度的工程师来说,这一结果提醒我们:数据的内在几何,而非表面维度,才是决定学习难度的真正变量。这也侧面支持了一个经验共识——在结构化数据上,流匹配类方法往往比理论最坏情况乐观得多。
小结
这篇论文围绕一个核心命题展开:流匹配模型的泛化能力自适应于数据的内在低维结构,从而缓解维度灾难。它通过有限样本的 Wasserstein-$p$ 误差界,把这一命题落到了可证明的数学结论上,并在更宽松的假设下成立。对于希望理解生成模型"为何有效"的研究者而言,这是一块值得关注的理论拼图。
相关推荐
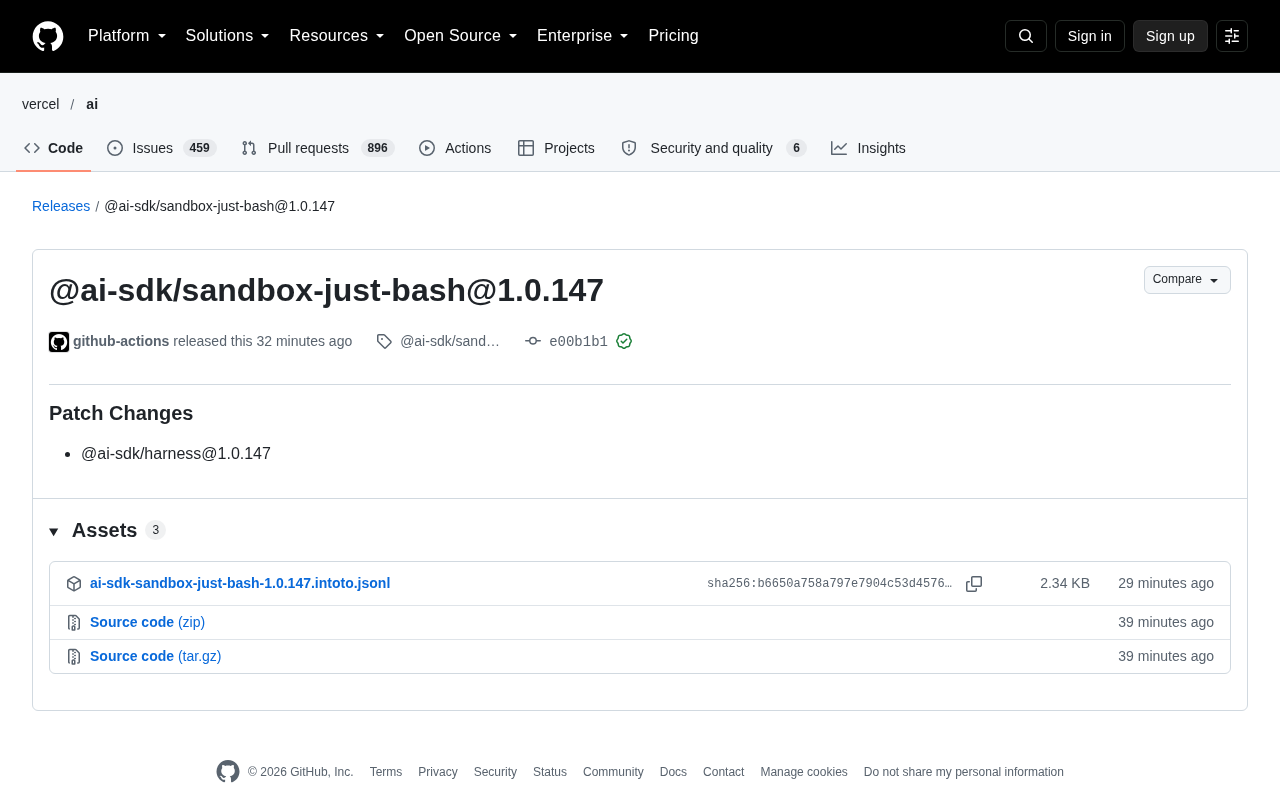
AI SDK 发布版本更新:sandbox-just-bash 组件信息速览
AI SDK 生态组件 @ai-sdk/sandbox-just-bash 发布 1.0.147 补丁更新,同步 @ai-sdk/harness 依赖。本文梳理该发布记录的版本信息与升级建议。
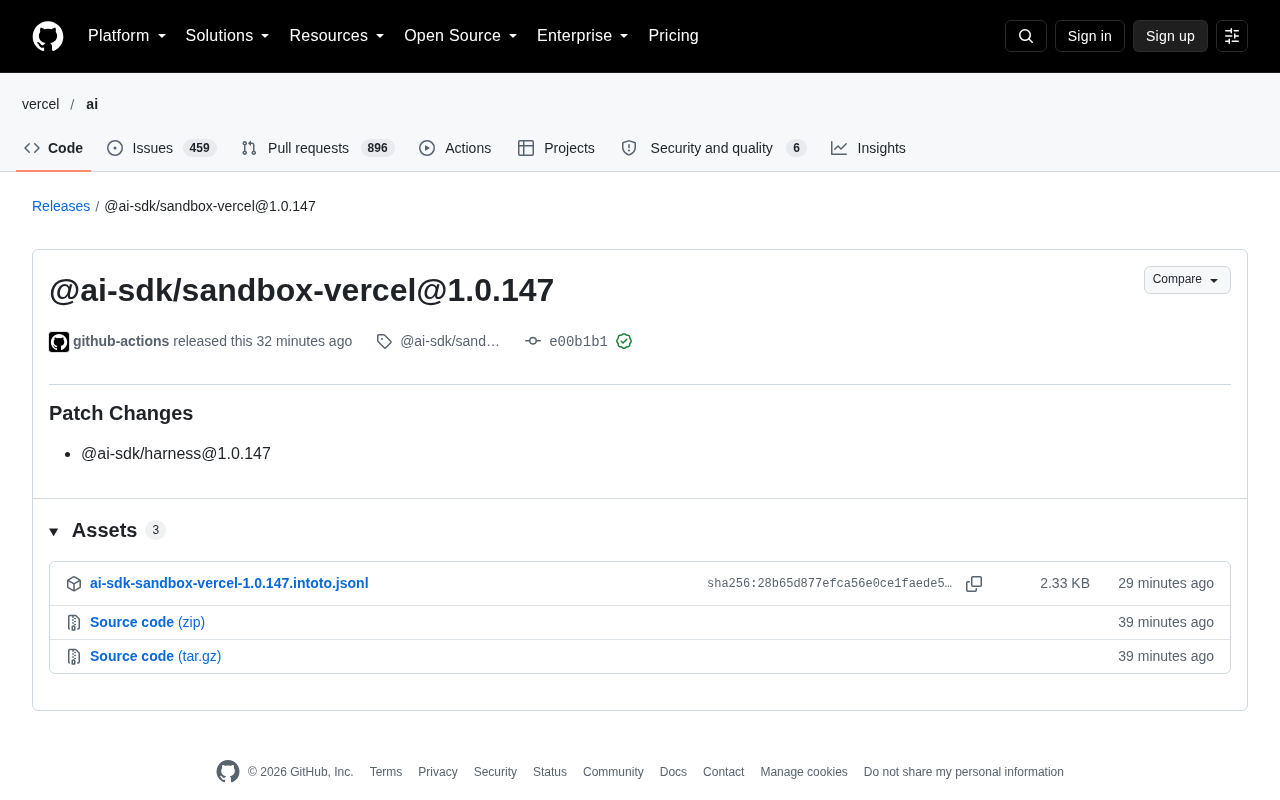
@ai-sdk/sandbox-vercel 1.0.147 发布说明
@ai-sdk/sandbox-vercel 1.0.147 版本发布,这是一次补丁级更新,主要同步升级内部依赖 @ai-sdk/harness 至相同版本,通过 GitHub 可信签名验证。
ChatGPT洗碗记:一支叉子引发的AI过度推理反思
一支洗碗机没洗净的叉子,引发AI启动"深度研究"、消耗海量算力甚至挑战纳维-斯托克斯千禧难题的荒诞实验。这则ChatGPT洗碗讽刺视频,折射出AI过度推理、算力成本与场景错配的真实困境。