#生成模型
共 21 篇相关文章

FlowBatt:流匹配模型实现跨化学体系电池退化概率预测
FlowBatt 将流匹配与扩散 Transformer 结合,实现跨化学体系的电池健康状态概率轨迹预测,五组基准误差低于 2.5%,并提供经验预测区间。

归一化流映射与奖励混合:生成模型如何兼顾采样速度与精确似然
微软研究院讲座解读两篇论文:Normalizing Flow Maps 让可逆生成映射同时具备少步采样与精确似然,可用于 RLHF 后训练和玻尔兹曼生成器;Martini 则用廉价代理奖励的非线性组合逼近昂贵预言奖励,在语言、图像与蛋白质对接任务上验证有效。

可训练扩散场生成式SDE:密度损失优化新方法
本文介绍了一种基于散度核的生成式SDE新方法,可联合优化神经SDE的漂移场、扩散场和初始分布,并直接使用终端密度损失训练。在二维和八维高斯混合实验中,该方法生成的离模式样本显著少于得分匹配生成器,展现出在复杂分布建模上的潜力。

量子测量噪声变废为宝:实现高效扩散模型生成
本文解读最新论文:如何将量子测量噪声转化为扩散模型的随机性来源,实现每样本仅303次测量即可达到高测量参考的生成质量,测量次数减少约5300倍,并探讨其对量子机器学习和生成模型的启示。

LOCOGEN:局部性引导破解调控DNA设计难题
LOCOGEN提出局部性引导新方法,解决调控DNA设计中奖励黑客问题,在HepG2等细胞系上实现属性、新颖性与合理性的平衡,代码已开源。

SpecSlot:解耦细节与全局注意力的像素生成Transformer
SpecSlot 提出一种角色耦合的 tokenization 方法,将低频全局结构与高频局部细节解耦,在不扩大全局注意力序列的前提下提升像素空间生成 Transformer 的细节表现,并在 ImageNet 和文本到图像任务上以更低算力取得更好效果。

JiT去噪防御:无线电信号分类抗对抗攻击新突破
本文介绍一种基于JiT去噪的无线电信号自动调制分类对抗防御方法,在RML2018.01A数据集上相比PGD对抗训练,鲁棒准确率相对提升至少20.58%,未知攻击下提升至少39.72%,且干净样本准确率提升10.20%。

OrderGPT:生成顺序也能学习,AI建模新突破
OrderGPT提出将生成顺序作为可学习建模选择,介于自回归与掩码扩散之间。无需规范顺序监督,从注意力模式学习任务级顺序,在语言、人体姿态和表格数据上验证有效性。

α稳定分数生成模型:从全局收敛到尾部收敛的理论突破
α稳定Lévy过程驱动的分数生成模型非渐近收敛分析:全局Wasserstein收敛与布朗动力学无本质差异,但尾部行为存在尖锐分离,尾部指数匹配α=ν是捕捉极端事件的关键机制。

Annealed Lévy Diffusion:用高斯代理实现重尾扩散新范式
Annealed Lévy Diffusion(ALD)通过退火稳定性指数融合重尾探索与高斯精修,以边际优先分解实现标准高斯噪声预测训练,在2D基准、MNIST、CelebA64等任务上验证生成质量。
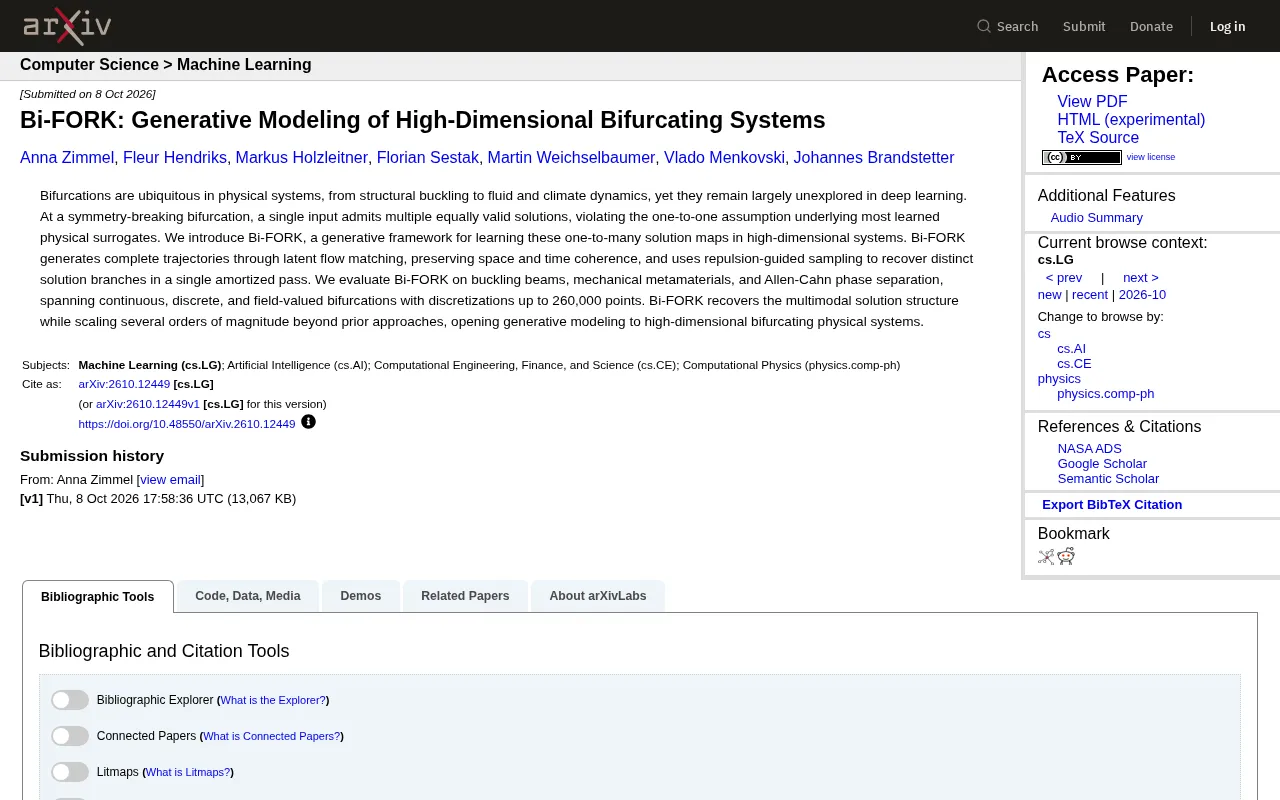
Bi-FORK:高维分岔系统的生成式建模新框架
Bi-FORK 提出面向高维分岔系统的生成式建模框架,通过潜空间流匹配与排斥引导采样,在单次推理中恢复多个解分支,可处理高达26万点的离散化问题,为物理仿真中的一对多映射提供新思路。

Prompteina:用自然语言设计蛋白质结构的突破
Prompteina 是首个支持自然语言条件的全原子蛋白质结构生成模型,类比文生图实现「文生蛋白」。基于180万结构、5000万+文本的数据集训练,在多项指标超越基线,并实验验证出针对GM2A的纳摩尔级结合蛋白。

自回归扩散模型能否生成金融市场数据?
探讨能否用自回归扩散模型生成逼真的金融市场数据,分析合成市场数据的应用价值、金融时间序列的统计难点,以及扩散模型在量化金融中的潜力与挑战。

流匹配中的速度缩放:为何有效的真正原因
最新 arXiv 研究重新解释了流匹配中速度缩放技巧的有效原因:真正问题并非 MSE 导致速度幅值不足,而是群体时间滞后。通过测量时间滞后选择增益,在 ImageNet-256 上将 FID 从 28.0 降至 12.2。

Normalizing Trajectory Models:让少步生成重拾精确似然框架
Normalizing Trajectory Models(NTM)将扩散模型反向过程的每一步建模为条件归一化流,实现少步生成下的精确似然训练,兼顾速度与概率框架完整性,突破蒸馏与一致性训练的局限。
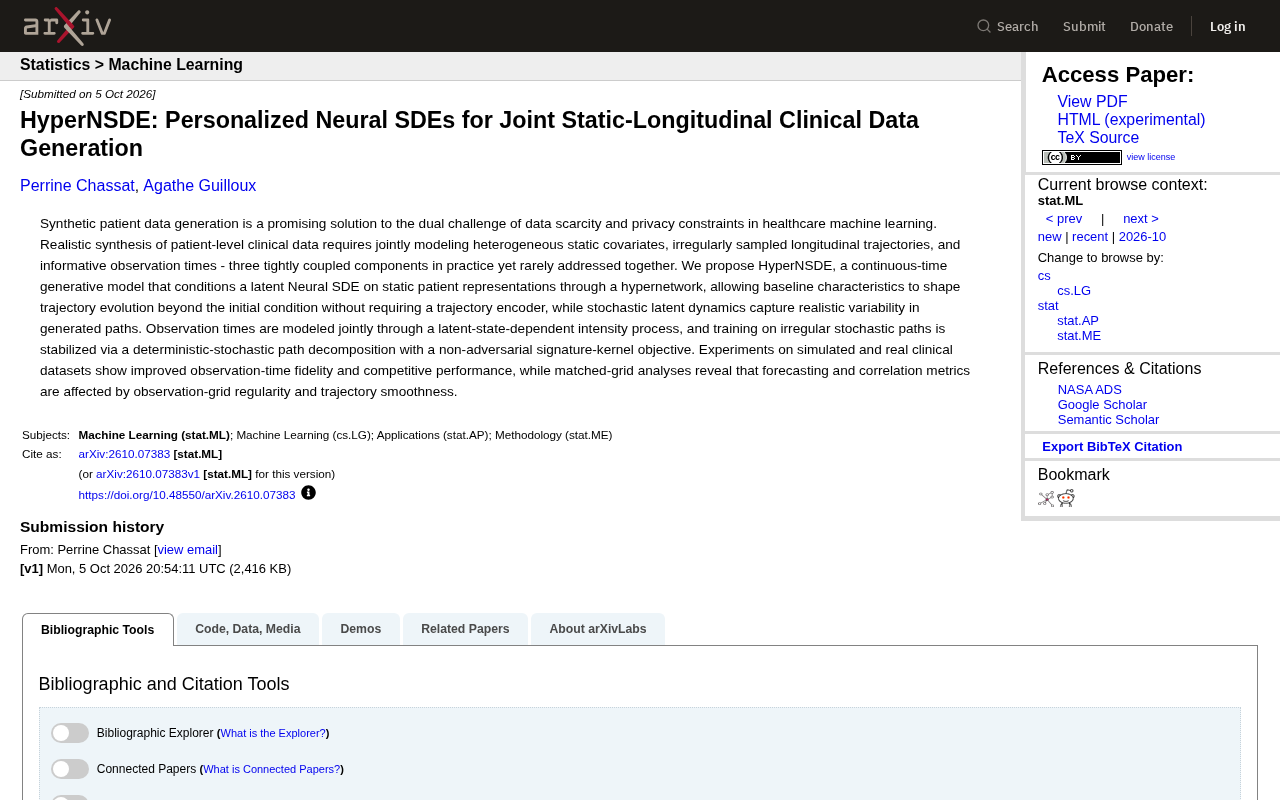
HyperNSDE:用神经随机微分方程生成个性化临床数据
HyperNSDE 是一种基于神经随机微分方程(Neural SDE)与超网络的连续时间生成模型,可联合生成静态协变量、纵向轨迹与观测时刻的个性化临床数据,有效缓解医疗AI的数据稀缺与隐私难题。
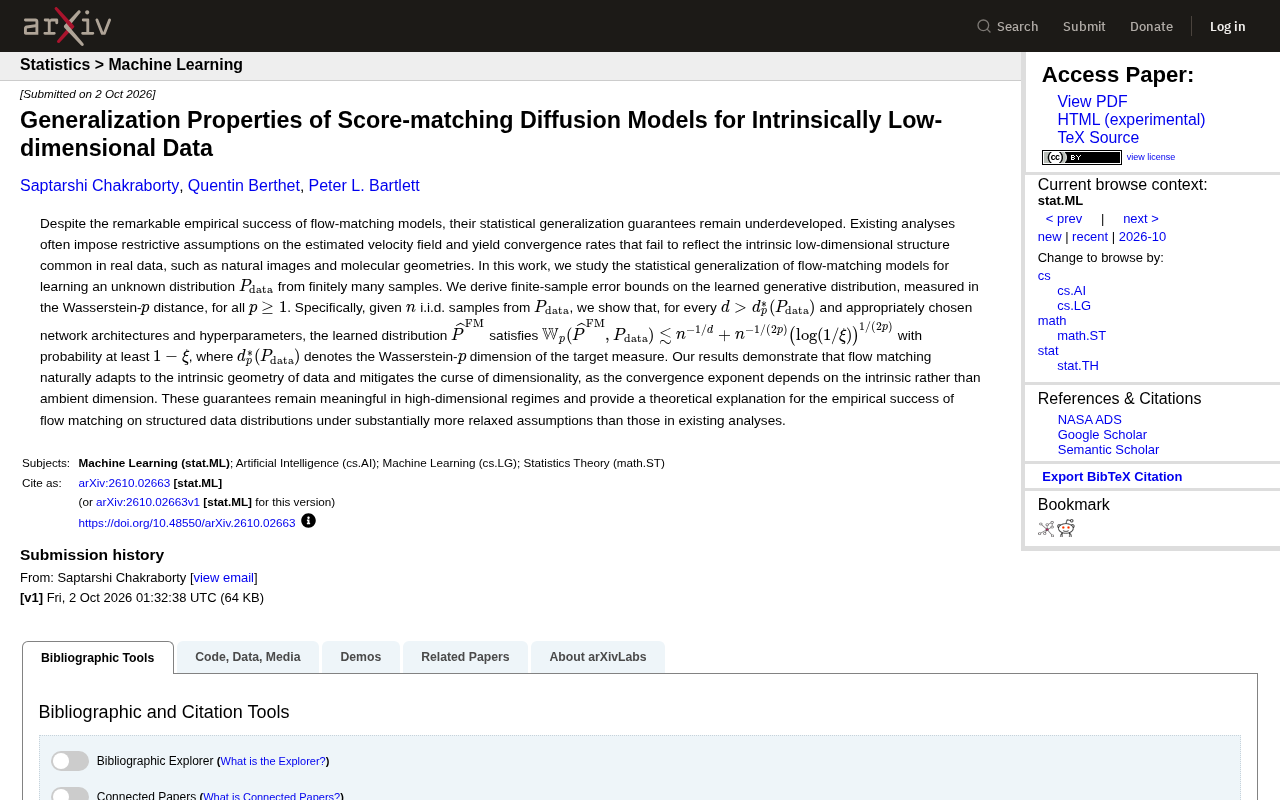
流匹配模型为何能摆脱维度灾难:低维数据的泛化理论解析
最新 arXiv 论文从理论上证明流匹配与扩散模型能自适应数据的内在低维结构,缓解维度灾难。本文解析其 Wasserstein-p 误差界、内在维度收敛率及对生成模型泛化理论的意义。
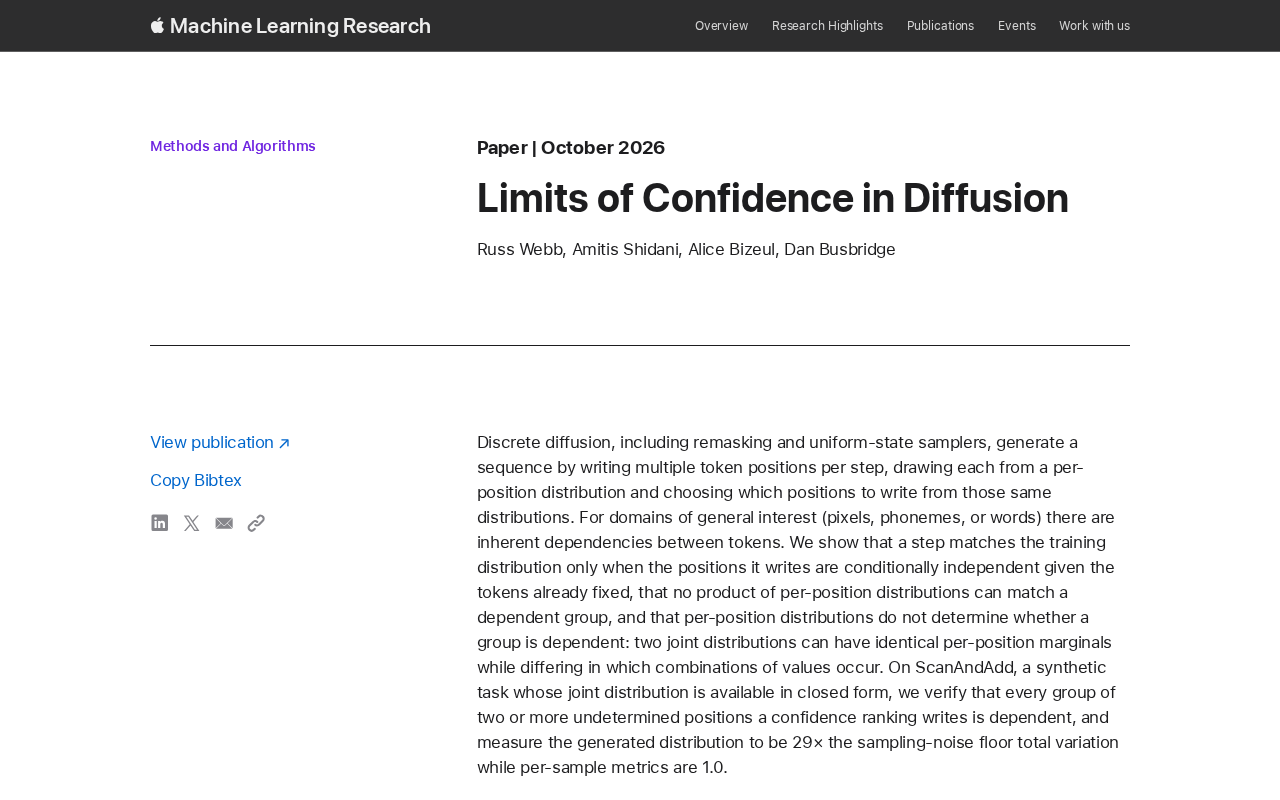
离散扩散模型的置信度困境:为何并行生成会偏离真实分布
《Limits of Confidence in Diffusion》研究揭示离散扩散模型并行生成的根本限制:只有条件独立的token位置才能同步写入,而像素、音素、词语等真实数据普遍存在依赖关系,导致乘积分布无法匹配真实训练分布。