KV缓存量化实测:413组对比揭示KVarN 6-bit反超q8_0

KV缓存量化为何值得关注
在本地部署大语言模型时,KV缓存(Key-Value Cache)往往是显存消耗的隐形杀手。KV缓存是Transformer架构中自注意力机制的核心组件——在自回归生成过程中,模型每生成一个新token都需要与所有历史token进行注意力计算。如果没有KV缓存,每一步都需要重新计算所有历史token的Key和Value向量,计算复杂度为O(n²)。KV缓存通过存储已计算过的Key-Value对来避免重复计算,将每步的增量计算降为O(n)。然而代价是显存占用:对于一个L层、H个注意力头、每头维度为d的模型,缓存n个token需要的显存为2×L×H×d×n×精度字节数。
要理解KV缓存的计算意义,需要回到Transformer自注意力机制的基本运算。自注意力通过Query、Key、Value三组向量实现token间的信息交互:每个token的Query向量与所有token的Key向量做点积运算得到注意力分数,经softmax归一化后作为权重对Value向量加权求和,得到该token的输出表示。更具体地说,自注意力的完整计算流程为:给定输入序列X,通过三个权重矩阵W_Q、W_K、W_V分别投影得到Q=XW_Q、K=XW_K、V=XW_V,然后计算Attention(Q,K,V) = softmax(QK^T / √d_k)V,其中√d_k是缩放因子,防止点积值过大导致softmax进入梯度饱和区。Multi-Head Attention将这一过程并行执行h次(h为头数),每个头使用不同的投影矩阵捕捉不同子空间的关系模式,最后拼接结果通过线性层融合。在自回归生成过程中,第t步生成时需要计算当前token的Query与前面所有t-1个token的Key的点积。KV缓存的追加操作实质上是将新token的k、v向量拼接到已有的K、V矩阵末尾,使得注意力计算只需用新token的q向量与完整的K矩阵做点积即可,避免了对所有历史token重新执行投影运算。如果不缓存历史Key和Value,生成长度为n的序列总计算量为O(n²)级别的矩阵运算。KV缓存本质上是一种经典的以空间换时间策略,将已计算的Key-Value对存储在GPU显存中,使每一步只需计算新token的QKV并追加到缓存即可。
随着上下文长度的增加,KV缓存占用的显存会线性增长,尤其在64K乃至更长的上下文场景下,KV缓存甚至可能超过模型权重本身的占用。以Qwen 27B为例,在BF16精度、64K上下文下,KV缓存可轻松占用数十GB显存。因此,如何在压缩KV缓存的同时尽可能保持模型输出质量,成为本地推理优化的核心课题之一。
近期一份来自Reddit社区的大规模基准测试给出了迄今为止较为系统的答案。测试者基于BeeLlama.cpp v0.4.0(一个提供了更多KV缓存量化选项的llama.cpp分支),在Qwen 3.6 27B和Gemma 4 31B两款模型上,累计跑了413组配置对比,其中Qwen模型238组、Gemma模型175组。
值得补充的是,llama.cpp是由Georgi Gerganov于2023年发起的开源本地推理框架,最初目的是在纯CPU上运行LLaMA模型,后逐步发展为支持GPU加速、多种量化格式的通用推理引擎。它采用GGUF格式存储量化权重——GGUF(GPT-Generated Unified Format)是2023年8月推出的自包含模型文件格式,将模型元数据、分词器配置和量化权重全部打包在单个文件中,无需额外依赖。llama.cpp的量化实现基于块级量化(block-wise quantization),每个块内的元素共享量化参数,块大小通常为32(Super Block可达256)。量化类型命名规则中,Q表示量化,数字表示比特数,K表示使用了更复杂的K-quant方案(包含超级块结构和混合精度),S/M/L后缀表示模型大小相关的量化参数调优。社区通过TheBloke、bartowski等量化提供者的工作,形成了活跃的模型量化分发生态。BeeLlama作为其社区分支,扩展了主线尚未合并的实验性功能,包括KVarN系列和扩展的低比特类型等前沿量化选项。这种社区分支机制使得前沿研究能快速进入可实测状态,但也意味着稳定性和兼容性可能不如主线版本。
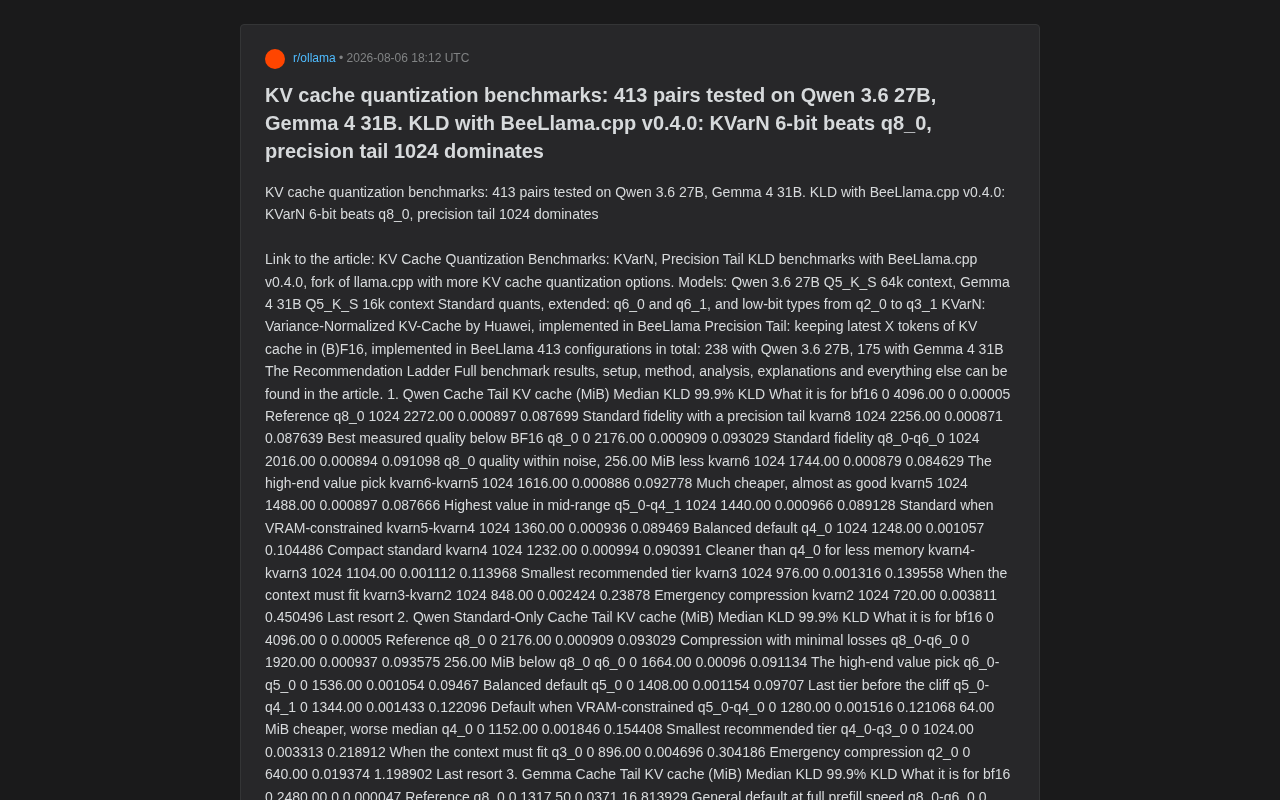
这份测试的价值在于其规模和方法论的严谨性——它没有停留在"感觉能用"的主观评价上,而是采用KL散度(KLD)作为客观量化指标,直接衡量量化后的输出分布与BF16参考分布的偏离程度。
核心指标与新方法解析
用KL散度衡量真实质量损失
测试选用KL散度(Kullback-Leibler Divergence)作为核心评估指标。KL散度源自信息论,对于离散分布P和Q,其定义为KLD(P||Q) = Σ P(x) × log(P(x)/Q(x))。在本测试场景中,P是BF16全精度模型的输出logits分布,Q是量化后模型的输出分布。KLD = 0表示两个分布完全相同,值越大表示偏离越严重。
KL散度最早由Solomon Kullback和Richard Leibler在1951年提出,是信息论中衡量两个概率分布差异的基本工具。直观理解上,KL散度度量的是:如果我们用分布Q来近似真实分布P,所需要额外付出的信息量(以比特或纳特为单位)。KL散度具有非对称性,即KLD(P||Q) ≠ KLD(Q||P),因此它不是严格意义上的距离度量。在模型量化评估中,选择P为全精度模型、Q为量化模型的方向意味着我们关注的是"量化模型在全精度模型认为重要的区域是否保持了足够的概率密度"——如果量化模型在某些全精度模型赋予高概率的token上给出了极低的概率,KL散度就会急剧上升。KL散度在深度学习领域的应用远不止量化评估:在变分自编码器(VAE)中用于约束隐变量分布接近先验分布;在知识蒸馏中衡量学生模型与教师模型的匹配程度;在强化学习的PPO算法中作为策略更新的约束项。在LLM量化评估的具体实现中,通常是对模型在大量测试prompt上逐token计算logits分布(经softmax后),然后对每个位置计算KL散度,最终汇总为统计量。
相比困惑度(Perplexity)等传统评估指标,KLD的优势在于它直接在token级别对比概率分布的形变,能更敏感地捕捉量化引入的细微偏差。KLD衡量的是量化后模型输出的概率分布相对于全精度BF16基准的偏离程度:KLD越低,说明量化造成的信息损失越小,输出质量越接近原始模型。
报告同时给出了中位数KLD和99.9%分位KLD两个数值。前者反映典型情况下的质量表现,后者则捕捉极端情况——也就是那些偶尔出现的、可能导致输出崩坏的"长尾"错误。99.9%分位KLD的引入针对的是量化误差的非均匀性:某些特定token位置可能因量化误差累积而产生远超平均水平的输出偏差,这正是用户实际使用中感知到的"偶尔说胡话"现象的量化表征。这种双指标呈现方式比单一平均值更能反映实际使用体验。
两项关键技术:KVarN与Precision Tail
本次测试引入了两个值得关注的技术特性:
-
KVarN(Variance-Normalized KV-Cache):这是华为提出的一种方差归一化KV缓存量化方案,已在BeeLlama中实现。其核心洞察来自一个经验事实:不同注意力头、不同层的KV向量具有差异极大的数值分布范围(方差)。传统量化方案对所有通道使用相同的量化参数,当某些通道的方差远大于其他通道时,低方差通道的有效精度会被严重浪费。KVarN在量化前对每个通道进行方差归一化(即除以标准差),使得所有通道的数值落入相似的范围,然后再进行均匀量化。反量化时再乘回标准差即可恢复。这种预处理使得固定比特宽度下的量化误差在各通道间分布更均匀,避免了少数"异常"通道拖累整体质量的问题——实质上,这等价于为每个通道自适应地分配量化精度。
从率失真理论(Rate-Distortion Theory)的角度理解,量化本质上是一个有损压缩问题:在给定的比特预算(率)下,最小化重建误差(失真)。最优的比特分配策略应当将更多比特分配给对最终输出影响更大的参数。高方差通道包含更多信息(熵更高),在均匀量化下会遭受更大的相对误差;归一化后等效于按信息量重新分配了量化精度。类似的思想也出现在GPTQ、AWQ等权重量化算法中——AWQ(Activation-aware Weight Quantization)通过识别"显著通道"(salient channels)来保护对输出影响大的权重,与KVarN保护高方差KV通道的逻辑一脉相承。
这里涉及量化的基础概念:量化的核心是将连续或高精度的浮点数映射到有限个离散值上。均匀量化将数值范围等间距划分为2^n个区间(n为比特数),每个区间内的值用同一个代表值表示。q4_0、q8_0等标记中的数字即表示比特数,后缀0/1通常表示是否包含偏移量(zero-point)。q4_0使用对称量化(零点固定为0),q4_1使用非对称量化(零点可浮动),后者在数值分布不对称时更精确但需额外存储零点参数。每个量化块通常包含32或64个元素共享一个缩放因子(scale),块大小的选择是精度与存储开销之间的权衡。理解了这些基础,就能更好地理解KVarN为什么通过预归一化来提升均匀量化的有效性。
-
Precision Tail(精度尾部):这一策略保留最新的X个token的KV缓存为完整的(B)F16精度,仅对较早的历史token进行量化。其有效性与Transformer注意力机制的"近因偏好"(recency bias)密切相关。研究表明,在多数生成场景下,模型对最近若干token的注意力权重显著高于远处token——这些最近的token携带了当前生成所需的即时语法和语义约束。当这些高注意力权重的token对应的KV向量被量化引入误差时,误差会通过注意力加权被放大传播到输出。而对于较远历史的token,即使KV精度稍有损失,由于其注意力权重较低,对最终输出的影响也相对有限。1024个token的精度尾部大约覆盖了2-3段当前对话的长度,在多数交互场景下足以保护最关键的近期上下文,能以极小的显存代价换取明显的质量提升。
测试还覆盖了标准量化类型以及扩展的q6_0、q6_1,甚至低至q2_0到q3_1的极端低比特类型,为不同显存预算的用户提供了完整的选择梯度。
Qwen模型测试结果:KVarN的胜利
在Qwen 3.6 27B(Q5_K_S,64K上下文)的测试中,最引人注目的发现是:带有1024精度尾部的KVarN 6-bit(kvarn6),在质量上超越了传统的q8_0。
具体数据上,kvarn6 + tail 1024的中位数KLD为0.000879,99.9%分位KLD仅为0.084629,而这一质量水平下其KV缓存占用仅为1744 MiB。相比之下,q8_0 + tail 1024占用高达2272 MiB,中位数KLD为0.000897。也就是说,kvarn6在节省约528 MiB显存的同时,质量反而略优——这是一个相当反直觉的结果。
这一结果的技术解释在于:传统q8_0虽然使用了更多比特,但其量化精度在各通道间的分配是"均匀但不最优"的。KVarN通过方差归一化预处理,使得6-bit的量化精度被更有效地"花在刀刃上"——高方差通道在归一化后不再因数值范围过大而产生过多截断误差,低方差通道也不再浪费比特在不必要的精度余量上。这再次印证了率失真理论的核心启示:智能的比特分配比盲目增加比特总量更重要。
更有意思的是精度尾部的普遍作用。对比标准量化的"Qwen Standard-Only"梯队可以看到,在没有精度尾部时,q8_0占用2176 MiB,KLD为0.000909;而加入tail 1024后的各档位普遍表现更好。测试者据此将"precision tail 1024"列为主导性最优策略。
报告给出的推荐阶梯中,几个关键档位值得记住:
- kvarn8 + tail 1024:BF16以下的最佳测量质量,2256 MiB
- kvarn6 + tail 1024:高端性价比之选,1744 MiB
- kvarn5 + tail 1024:中端最高性价比,1488 MiB
- kvarn5-kvarn4 混合 + tail 1024:均衡默认配置,1360 MiB
- kvarn3 及以下:仅在上下文必须塞进有限显存时使用,质量开始明显下滑
Gemma模型测试结果:谨慎对待激进压缩
Gemma 4 31B(Q5_K_S,16K上下文)的测试结果则呈现出截然不同的图景,也提醒我们不能盲目套用Qwen的经验。
最显著的差异在于Gemma对量化的敏感度远高于Qwen。以BF16为基准(KLD近乎为0),Gemma在q8_0下的中位数KLD就达到了0.0371,99.9%分位KLD更是高达16.81——这个绝对数值比Qwen高出几个数量级。这意味着Gemma架构下的KV缓存量化本身就更"脆弱"。
Gemma和Qwen在架构细节上的差异可能是量化耐受度截然不同的根本原因。这里需要了解Group Query Attention(GQA)这一关键架构选择:GQA是Meta在LLaMA 2中引入并被广泛采用的注意力机制变体。注意力机制的KV共享经历了从Multi-Head Attention(MHA)到Multi-Query Attention(MQA)再到GQA的演进——MQA由Google在2019年提出,所有Query头共享单一一组KV头,虽然大幅减少了KV缓存但可能损失模型容量;GQA则是MQA的折中方案,将多个Query头分组共享同一组Key-Value头,从而在减少KV缓存大小的同时保持较好的模型容量。例如,Qwen3 27B使用4个KV头配32个Query头(8:1比例),每4个Query头共享一组KV向量。不同模型的GQA配比直接影响KV缓存的总量和量化特性——共享的KV头承载了更多Query头的信息需求,因此对量化误差可能更敏感。此外,Gemma系列使用了一些独特的架构选择如logit soft-capping(对注意力logits做tanh截断以限制其范围),这些设计虽然有助于训练稳定性,但可能使KV向量的数值分布更集中,从而对量化的分辨率要求更高。RMSNorm(Root Mean Square Layer Normalization)的位置设计以及注意力logits的数值范围分布也会影响量化表现。如果某个模型的注意力分数分布更加"尖锐"(即少数token占据极高的注意力权重),那么这些关键KV向量的量化误差会被更大程度地放大。不同模型的训练方式(如是否使用过长上下文微调)也会影响KV缓存中数值的分布特征。
更关键的是存在明显的质量悬崖。数据显示:
q5_0(852.5 MiB)是"可用质量的显存下限",KLD为0.061747- 一旦降到
q4_0(697.5 MiB),KLD跳升至0.134091,被标注为"巨大悬崖前的预算档位" - 继续压缩到
q3_0(542.5 MiB),KLD飙至0.504075 - 极端的
q2_0(387.5 MiB)KLD高达2.95758,仅作"最后手段"
所谓"质量悬崖"是指量化比特数的线性下降并不会带来线性的质量损失,而是在某个临界点之后质量急剧崩塌。这通常发生在量化精度不足以表征KV向量中关键的数值差异时——一旦量化分辨率低于某个阈值,注意力权重计算中的微小差异被"抹平",导致模型无法正确区分应该关注的token和应该忽略的token。从信息论角度看,这对应的是量化信道容量低于信源熵率的临界点——当比特预算不足以承载KV向量的最低信息需求时,不可避免地出现灾难性信息丢失。
因此对Gemma用户而言,q8_0是保持全预填充速度下的通用默认,q6_0是"悬崖前的最后一档",而q5_0则是可用质量的底线。跌破这条线后,质量下降会急剧加速。
实践建议与局限性
综合这份测试,可以提炼出几条实用结论:
第一,精度尾部(Precision Tail)几乎是免费的午餐。保留最新1024个token为BF16,只增加极小的显存开销(约额外2-4 MiB级别),却能系统性地改善质量表现,值得在任何支持的场景下默认开启。
第二,方差归一化量化(KVarN)在Qwen上表现优异,kvarn6甚至能以更低显存超越q8_0,对显存吃紧但又追求质量的用户是理想选择。这也说明量化方案的进步空间不仅在于增加比特数,更在于更智能地分配有限比特的表征能力。
第三,不同模型架构对量化的耐受度差异巨大。Qwen相对宽容,可以较为激进地压缩;而Gemma则脆弱得多,建议保守地停在q5_0以上。这一发现的实践意义在于:量化策略不能"一刀切",必须针对具体模型架构进行验证。
提一嘴,本次测试来自单一Reddit来源,虽然规模庞大且方法透明,但KVarN等技术的表现仍需更多独立复现来交叉验证。此外,KLD是分布层面的指标,与实际下游任务(如代码生成、长文推理)的表现并非完全等价——一个较低的KLD可以保证输出分布的统计特性未被破坏,但不能直接映射为"代码通过率提升X%"这样的任务级指标。读者在应用这些结论时仍应结合自身场景进行验证。
尽管如此,这份413组的系统性基准仍然为本地大模型部署者提供了一份难得的量化参考图谱,尤其是将新兴的KVarN与Precision Tail策略纳入对比,具有相当的前瞻价值。
核心要点
核心要点
核心要点
相关推荐

本地AI部署神器LocModel:一键玩转开源模型与AI生成
LocModel是一款本地AI部署工具,可自动适配硬件、一键下载开源模型,支持图片生成、视频生成、无审查大模型和Agent智能体,完全免费。本文基于实测视频介绍其安装与使用流程。

Antigravity CLI:终端免费调用Gemini与Claude顶级模型
Antigravity CLI(agy)宣称可在VS Code终端免费调用Gemini 3.1 Flash、Claude Sonnet等顶级模型,几秒完成安装。本文拆解其使用流程、终端内调用模型的价值,以及免费宣称背后需要核实的安全与可持续性问题。

聊天机器人与AI智能体:核心区别与选型指南
聊天机器人与AI智能体到底有什么区别?本文从工具、记忆、工作流三个维度拆解两者差异,用整理收件箱、安排会议等四个真实场景对比,并给出权限控制、不可逆操作确认等风险防范建议与选型判断标准。