LangChain+RAG面试实战:一文读懂LangChain核心价值

LangChain是补齐大模型知识截止、外部交互与状态保持三大局限的智能体开发框架。
文章介绍LangChain在Agent与大模型应用开发中的定位:它不是简单的模型API封装,而是提供预构建智能体架构与工具集成的开源框架,角色可类比Java中的Spring,底层还涉及LangGraph。文章重点剖析大模型的三项局限——知识受限于训练数据截止时间、无法直接与外部系统交互、缺乏状态保持能力,并说明LangChain如何通过Function Call、工具集成和链式组合加以补齐,同时解释其名字源自Language与Chain。学习路径上主张以官方文档为主、中文文档为辅,关注LangChain、LangGraph、DeepAgencies与LangSmith的生态关系。最后给出面试与实战启示:理解框架定位与模型边界比背API更重要。
在Agent开发和大模型应用开发领域,LangChain几乎是绕不开的框架。B站上有一门被称作“吊打付费”的LangChain+RAG面试实战教程,首次公开了其核心内容。本文基于该教程的讲解,梳理LangChain的定位、它能解决的大模型三大局限,以及学习路径建议,帮助你在面试和实战中真正理解这个框架。
LangChain是什么:不只是API封装
LangChain是一个用于开发由大语言模型驱动的应用程序的开源框架。很多开发者最初接触大模型时,第一站就是它。但需要明确的是,LangChain并非简单的模型调用API封装——它提供的是预构建的智能体架构和丰富的工具集成。
如果你有Java背景,可以暂时把LangChain在Agent生态中的角色类比为Spring在Java中的地位。它内部不仅包含LangChain本身,底层还涉及LangGraph,同时也涵盖DeepAgent相关内容。这意味着开发者无需从零搭建复杂的集成架构,就能快速构建基于大语言模型的高级应用。
大模型的三大局限,LangChain如何补齐
学习任何技术之前,先搞清楚它解决了什么问题。从宏观维度看,LangChain主要应对大语言模型的三个关键限制。
知识受限与训练数据截止
大模型的知识受限于训练数据的时间节点。比如模型在8月10号完成训练,你问它8月11号的天气或8月12号发生了什么,它无法回答。有人可能会说“我问豆包它知道啊”——但那已经是别人封装过的应用,你并没有直接与豆包模型交互,用的本身就是基于大模型驱动的应用。LangChain通过Function Call机制解决这个问题:开发者可以自行调用工具获取模型训练时间之后的数据。
Function Call(函数调用) 是大模型平台提供的一种结构化输出能力:开发者以 JSON Schema 描述可用的工具(名称、用途、参数类型),模型在判断需要外部信息时,不直接给出自然语言答案,而是返回一个指定工具与参数的调用请求;由开发者侧代码真正执行该工具,再把结果回传给模型,模型据此组织最终回复。它本身不赋予模型联网或计算能力,只是把“该调什么”的决策交给模型、“实际执行”交给程序,因此安全性、权限与结果校验都由开发者掌控。LangChain 在此基础上封装了工具定义、调用解析与结果回填的流程,使接入实时数据、数据库查询或精确计算时不必重复编写胶水代码。
无法直接与外部系统交互
大模型本身无法直接和外部系统交互。比如调用第三方API查询天气,或者写工具类实现精确的加减乘除运算——模型对复杂运算往往算不准确,这时可以通过Function Call拿到反馈信息,再自行做计算。此外,公司内部数据通常存放在数据库里,大模型也无法直接通过JDBC等方式连接获取。这些都可以借助LangChain来解决。
缺乏状态保持能力
在与豆包、DeepSeek广告等交互时,你会发现它能记住之前的聊天记录,结合上下文给出回答。但这并非大模型本身的能力——大模型不具备状态保持,本质上是一问一答,你问第二个问题时它不会关联第一个问题。光靠模型本身无法实现多轮对话。LangChain框架正是为解决这一问题而生。
大模型的“无状态” 指的是:模型每次推理只处理本次请求中显式传入的内容,服务端不会自动保留上一次对话。所谓“记得上文”,实际是应用把历史消息拼接进本次提示词一并发送,受上下文窗口长度限制,过长时需要截断或摘要压缩。LangChain 用 Memory(记忆)与 Conversation Chain 等组件把这一过程抽象出来:负责保存历史消息、按策略裁剪或总结、在每轮调用前组装成完整上下文,并可将会话持久化到数据库或缓存。理解这一点有助于在面试中说明“多轮对话是工程能力而非模型能力”,也能解释为何长对话会出现遗忘与成本上升。
名字的由来:Language + Chain
LangChain的名字本质就两点:Lang代表Language(语言,即大语言模型),Chain代表链式交互的组合。说人话就是:将大语言模型与计算机中的其他资源以链式方式连接起来,让它们之间产生交互,从而构建更强大的AI应用或智能体。
Chain(链) 在 LangChain 中是把多个处理步骤按顺序或条件串联起来的抽象:一步的输出作为下一步的输入,例如“提示词模板 → 模型调用 → 输出解析”构成最基础的一条链,再往上可组合检索、工具调用、分支判断等环节。与早期以 Chain 为中心的写法相比,LangChain 当前主推 LCEL(LangChain Expression Language),用管道符风格的声明式语法描述数据流,天然支持流式输出、异步、并行与重试。需要注意的是,当流程涉及循环、条件回跳等复杂控制流时,官方更推荐转向 LangGraph,以图结构表达节点与边。
学习路径:官方文档为主,中文文档为辅
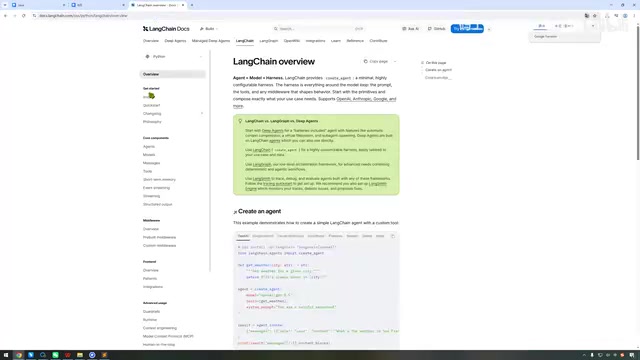
LangChain一直在迭代更新,学习时更多要参考官方文档。官方生态主要围绕三个核心:LangChain、LangGraph和DeepAgencies,此外还有LangSmith等工具,它们之间的关系和区别在文档中都有介绍。
英文文档是最新更新的第一来源,推荐英文能力尚可的开发者直接阅读。如果英文水平一般,中文文档基本同步更新,代码内容一致,可以理解为AI翻译版本——虽然个别措辞可能不够准确,但大部分内容都是OK的。中文文档中也能清晰看到LangChain的整体定位:模型加封装框架,即大语言模型与对应框架的结合。官方还提供了CurateAgent这样极其简单且高度可配置的封装框架,方便与各种模型交互。
LangGraph 是构建在 LangChain 之上的编排框架,把应用建模为状态图:节点是处理函数,边定义跳转与条件分支,并共享一份可持久化的状态。它特别适合需要循环(如“思考—调工具—再思考”)、人工介入审批、多智能体重协作以及断点续跑的场景,弥补了线性链在复杂控制流上的不足。LangSmith 则是配套的可观测与评测平台,用于追踪每次调用的输入输出、耗时与 token 消耗,管理提示词版本,并基于数据集做回归评测,排查 Agent 行为异常时尤为有用。两者与 LangChain 分工明确:LangChain 提供组件与集成,LangGraph 负责流程编排,LangSmith 负责调试与评估。
面试与实战启示
对于准备面试的开发者,理解LangChain的定位比记住API更重要。面试官更可能考察你是否清楚大模型的边界——知识截止、外部交互缺失、状态保持不足——以及LangChain如何通过Function Call、工具集成和链式组合来补齐这些短板。把LangChain类比为Java中的Spring,能帮助面试官快速理解你的认知深度。
从实战角度看,LangChain的价值在于让开发者不必重复造轮子。无论是接入公司内部数据库,还是构建多轮对话的Agent,框架已经提供了预构建的组件和集成方案。掌握官方文档的阅读方法,跟进LangGraph和DeepAgencies的演进,是在这个快速迭代领域保持竞争力的关键。
相关推荐

DeepSeek Harness速通指南:从安装到5个实战案例
DeepSeek Harness 是什么?本文基于 B 站教程,介绍这款 AI Agents 软件的工作原理、安装配置、四种工作模式,并通过 3D 赛车游戏、官网、音乐播放器、科普动画、自开发插件五个实战案例展示其能力,附 Token 省钱技巧。

拆解DeepSeek Super-agent架构:Router+Worker如何破解多会话管理瓶颈
解读DeepSeek Super-agent论文:Router+Worker双层架构如何通过Fast Pass、链式召回、存算分离解决多AI会话管理瓶颈,并分析其对人注意力瓶颈的真实缓解程度与工程取舍。

5天1.9万星!DeepSeek开源AI程序员为何爆火
DeepSeek开源AI程序员5天斩获1.9万星,从零登顶GitHub榜首。它为何爆火?本文分析智能体赛道热潮、AI自写代码的叙事以及从问答工具到AI员工的范式转变,并提醒研究代码仍需谨慎审核。