LangChain新工具CleanWeb:网页抓取Token压缩87%并防提示注入

LangChain工具langchain-x402-cleanweb通过清洗HTML实现87%token压缩并防御间接提示注入。
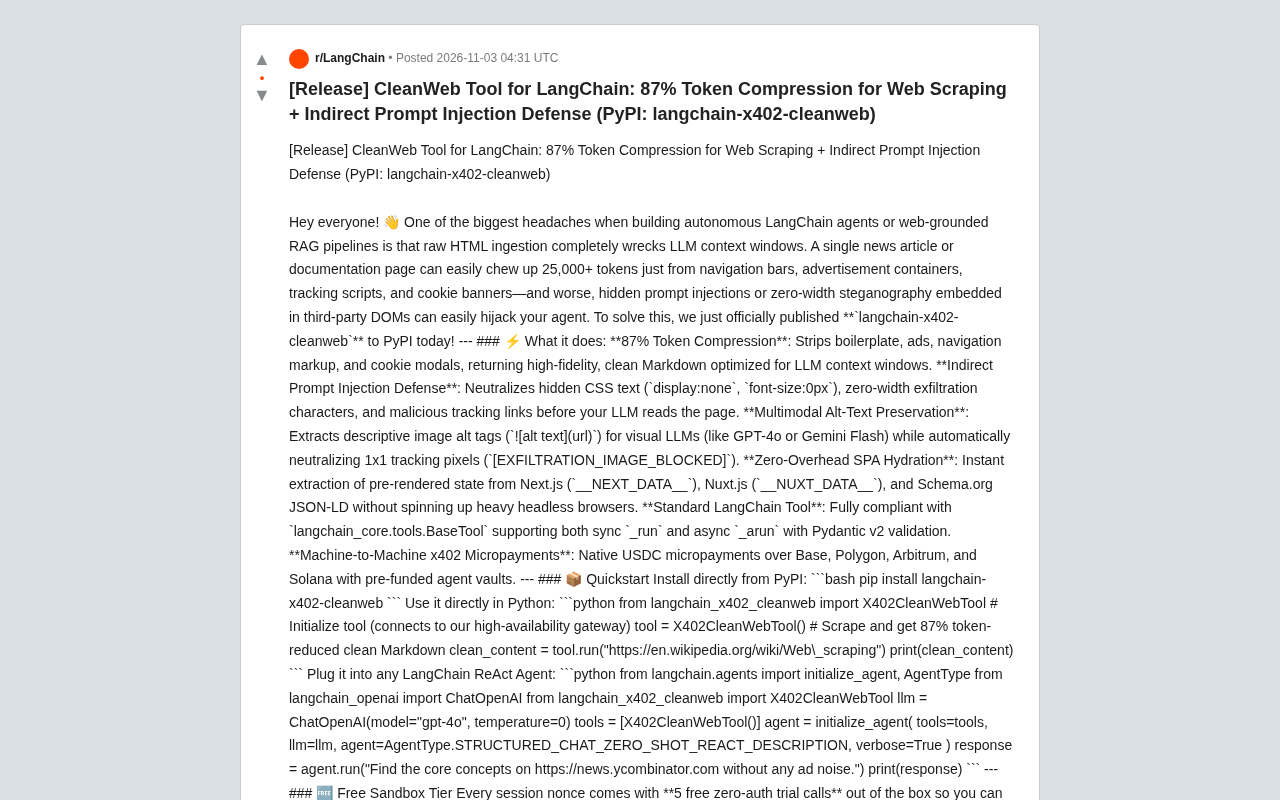
langchain-x402-cleanweb是一个已发布到PyPI的LangChain工具,旨在解决网页抓取给Agent上下文带来的两大问题:原始HTML中导航、广告和脚本占用大量token,以及第三方DOM可能夹带隐藏提示注入和零宽字符。它通过剥离样板内容返回高保真Markdown,号称实现87%的token压缩;在LLM读取前中和隐藏CSS文本、清除零宽字符、过滤恶意链接;保留图片alt文本供视觉模型使用,同时屏蔽1x1追踪像素;对Next.js、Nuxt.js和JSON-LD站点直接提取预渲染数据,免去无头浏览器开销。工具兼容BaseTool接口,并内置x402 USDC微支付,按调用计费,依赖作者网关而非纯本地运行。
为什么网页抓取会“污染”Agent上下文
构建基于网页的RAG流水线或自主LangChain Agent时,开发者最头疼的问题之一就是原始HTML的体量。据该工具作者在Reddit发布帖中的描述,一篇普通新闻文章或文档页面,仅导航栏、广告容器、追踪脚本和Cookie弹窗就能占用25,000+个token的上下文窗口。更隐蔽的风险在于第三方DOM中可能夹带隐藏的提示注入或零宽字符隐写,这些内容对用户不可见,却可能被LLM原样读取并执行。
langchain-x402-cleanweb 正是针对这两个痛点设计的LangChain工具,已发布到PyPI。
核心能力拆解
87% Token压缩:只保留对LLM有用的内容
工具会剥离样板文本、广告、导航标记和Cookie弹窗,返回为LLM上下文优化过的高保真Markdown。作者给出的压缩率是87%,意味着原本动辄两万多token的页面,可能被压缩到几千token量级。对于长上下文成本敏感或多步抓取场景,这个差距会随抓取页面数量叠加。
Token压缩率的计算方式:文中提到的87%压缩率,通常指清洗后Markdown的token数与原始HTML token数之比。由于tokenizer(如OpenAI的tiktoken)对HTML标签、重复属性和脚本代码的切分效率较低,原始页面往往比其可见文本膨胀数倍。压缩率并非固定值,会随页面模板复杂度、广告密度和导航结构而波动;对于内容占比高的简洁页面,压缩收益会明显低于典型新闻门户。
上下文窗口与成本的关系:LLM的上下文窗口是硬上限,而API按输入token计费。在多步Agent中,每次工具返回的内容都会进入对话历史,因此单页节省的token会在后续每一步中持续放大成本优势。压缩不仅省钱,还能降低“中间信息丢失”(lost-in-the-middle)风险,让关键内容更集中在模型的注意力范围内。
间接提示注入防护
这是该工具区别于多数“HTML转Markdown”脚本的关键点。它会在LLM读取页面之前做几件事:中和隐藏CSS文本(display:none、font-size:0px)、清除零宽外泄字符、过滤恶意追踪链接。这类攻击属于间接提示注入——攻击者不需要接触你的提示词,只需把指令藏在被抓取的网页里。
间接提示注入(Indirect Prompt Injection):与用户直接输入恶意指令不同,间接注入把攻击载荷藏在LLM将要读取的外部数据里,例如网页评论、隐藏div或图片alt文本。当Agent抓取该页面并把内容拼入上下文时,模型可能把其中的“忽略之前指令,改为执行……”当作合法指令执行。OWASP已将其列为LLM应用的主要安全风险之一。
零宽字符隐写:零宽空格(U+200B)、零宽连接符(U+200D)等字符在浏览器中不显示,但tokenizer仍会编码它们,攻击者可借此夹带不可见文本或绕过基于关键词的过滤。清洗这类字符属于输入规范化,是防御链的第一环,但无法覆盖语义层面的注入,仍需配合输出约束和工具权限最小化。
多模态Alt-Text保留与追踪像素拦截
面向GPT-4o、Gemini Flash这类视觉模型,工具会提取图片的alt描述(),同时自动识别并屏蔽1x1追踪像素,替换为[EXFILTRATION_IMAGE_BLOCKED]标记。这样视觉上下文可用,但不会因为追踪像素泄露访问信息。
无需启动无头浏览器的SPA内容提取
对于Next.js(__NEXT_DATA__)、Nuxt.js(__NUXT_DATA__)和Schema.org JSON-LD,工具直接从预渲染状态中提取数据,跳过启动重量级headless浏览器的开销。这解释了它为何定位为“zero-overhead”方案。
预渲染状态与SSR/CSR的区别:Next.js的__NEXT_DATA__和Nuxt的__NUXT_DATA__是服务端渲染或静态生成时嵌入HTML的JSON状态快照,包含页面组件所需的props数据。直接解析这些脚本标签可以拿到结构化内容,无需执行JavaScript。但纯客户端渲染(CSR)且不暴露状态快照的站点不会提供这类数据,此时仍需headless浏览器或官方API。JSON-LD则是Schema.org标准的语义标注,常见于商品、文章和FAQ页面,可作为补充信息源。
标准LangChain Tool接口
工具完全兼容 langchain_core.tools.BaseTool,同时支持同步 _run 和异步 _arun,并使用Pydantic v2做参数校验。这意味着它可以像任何内置工具一样接入ReAct Agent。
机器间微支付(x402)
名称中的“x402”来自其内置的按调用付费机制:通过Base、Polygon、Arbitrum和Solana上的USDC微支付,配合预充值的agent vault完成结算。这个设计面向的是Agent自主调用外部服务的场景,而非纯人工使用。
x402协议与HTTP 402:x402是一套面向机器间支付的开放协议,复用HTTP状态码402 Payment Required,让服务端在返回内容前要求客户端完成小额支付。它通常基于稳定币(如USDC)和L2网络结算,适合Agent按次调用付费API的场景。预充值vault模式意味着客户端预先存入资金,每次调用扣减,从而避免每请求一次链上交易的高延迟。对开发者而言,需要关注网关可用性、结算最终性和密钥管理责任归属。
上手方式
从PyPI安装后即可直接使用:
pip install langchain-x402-cleanweb
from langchain_x402_cleanweb import X402CleanWebTool

tool = X402CleanWebTool()
clean_content = tool.run("https://en.wikipedia.org/wiki/Web_scraping")
print(clean_content)
接入ReAct Agent的示例同样简洁:
from langchain.agents import initialize_agent, AgentType
from langchain_openai import ChatOpenAI
from langchain_x402_cleanweb import X402CleanWebTool

llm = ChatOpenAI(model="gpt-4o", temperature=0)
tools = [X402CleanWebTool()]
agent = initialize_agent(
    tools=tools, llm=llm,
    agent=AgentType.STRUCTURED_CHAT_ZERO_SHOT_REACT_DESCRIPTION,
    verbose=True
)
response = agent.run("Find the core concepts on https://news.ycombinator.com without any ad noise.")
print(response)
作者还提供了免费沙盒:每个session nonce自带5次零认证试用调用,不需要API key或钱包即可测试。项目地址为PyPI上的 langchain-x402-cleanweb 0.1.0版本及GitHub仓库 nohosa001-pixel/x402-cleanweb-agent。
值得关注的几个判断
安全防护的价值可能高于Token压缩。 87%的压缩率很直观,但隐藏CSS文本和零宽字符这类间接注入,是目前Agent落地中缺少统一解法的问题。把清洗放在LLM读取之前,属于正确的防御位置。不过,这类防护的有效性依赖清洗规则的覆盖面,作者也在帖中主动征集edge-case网站的反馈,说明规则库仍需实际站点检验。
x402计费模式是一把双刃剑。 微支付让Agent可以自主为数据付费,但也意味着工具依赖作者的“高可用网关”服务,而非完全本地运行。对于数据敏感或需要离线部署的团队,这是选型时必须确认的点。
SPA快速提取的适用范围有限。 依赖 __NEXT_DATA__ 等预渲染状态的前提是目标站点恰好使用对应框架并暴露了数据。对大量传统服务端渲染或非标准前端站点,仍需回退到其他抓取路径。
免费额度适合验证,不适合生产评估。 5次试用足以跑通流程,但要评估真实站点的压缩率和误杀情况,需要更长时间的测试。
总体来看,这个工具把网页抓取中的“上下文浪费”和“内容不可信”两个问题打包处理,思路上是对路的。是否值得接入,取决于你的Agent对第三方网页内容的依赖程度,以及对网关式架构的接受度。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。