Laya开源决策模型实测:比商业API快7倍、数据不出域

Laya:专做决策的开源小模型,毫秒级输出结构化结论,零成本替代闭源付费API。
Laya 是一个专注于结构化决策的开源小模型,支持是/否判断、多选、评分三类任务,在 T4 显卡上单问题延迟仅 33 毫秒,批量处理可压至 7 毫秒,输出为 JSON 格式且无幻觉风险。它直接对标闭源付费产品 JF,采用 Apache 2.0 协议完全开放权重、代码与训练数据,模型仅 800MB、CPU 即可运行,数据全程不出域,成本比商业方案低一个数量级。配套的 Laya Server 提供开箱即用的 Docker 镜像和网页管理后台,并兼容 JF 接口协议,便于迁移。其最典型的落地场景是在 AI 网关中充当智能路由器,用几十毫秒的低成本判断将简单请求分流至轻量模型、复杂请求交给强模型,显著压缩整体推理成本,是大模型时代「小而专」开源方案的务实代表。
开源社区最近被一个叫 Laya 的项目刷屏。它在 Hacker News 拿下 560 分,Reddit 收获 1566 个赞,GitHub Star 5 天冲到 20.9K。热度背后是一件很多人想做却没做成的事——把一类原本只能付费调用的商业决策服务,彻底开源了出来。
Laya 到底是什么模型
Laya 是一个专门做决策的小模型,和 ChatGPT 那类擅长写作文、生成长文本的大模型走的是完全不同的两条路。它不生成任何文字,你给它一段文本,外加几个自己定好的问题,它一次计算就直接给出结论。
它的核心优势可以浓缩成三个字:快、稳、省。
- 快:在一张 T4 显卡上,单个问题耗时 33 毫秒,批量处理能压到 7 毫秒;
- 稳:输出直接是结构化格式(JSON),不存在幻觉,也不会出现格式错乱;
- 省:模型只有 3 到 4 亿参数,CPU 就能跑,成本比大模型低一个数量级。

它还内置了多语言路由,能自动识别 100 多种语言,中文场景完全没问题。业务上它支持三类问题:是或否、选哪个、打几分——几乎所有判断题都能拆解成这三种基本形态。
Laya 所针对的「决策型」任务,在 NLP 领域通常被归类为文本分类(Text Classification)或自然语言推理(NLI)。与生成式大模型(GPT、Claude 等)需要逐 Token 自回归解码不同,决策模型只需对输入做一次前向传播,输出固定维度的概率分布即可。这种架构天然适合 BERT 系列的编码器(Encoder-only)模型,参数量通常在 1 亿到 5 亿之间,推理计算量与序列长度呈线性关系而非平方关系,因此速度远快于同等精度的生成模型。「无幻觉」也是这类架构的结构性优势:因为模型根本不做文本生成,所有输出都来自预设的标签空间,不存在生成式模型那种「一本正经胡说八道」的可能性。
和商业产品 JF 的三点关键差异
Laya 走的技术路线上,有一个绕不开的对手 JF——一家旧金山初创公司 TypeSafe AI 做的闭源付费 API。两者的接口设计几乎一模一样,但差异体现在三个层面。
时间上,Laya 其实更早。作者的论文比 JF 早了一年半,这一点在讨论谁抄谁的争论中经常被忽略。
开源性上完全不同。JF 是黑盒,你只能调 API;而 Laya 采用 Apache 2.0 协议完全开源,权重、代码、训练数据全部公开。
成本和可控性差距明显。JF 收费 0.042 美元每百万 Token,数据还得上传到它的服务器。Laya 则是自托管,零成本,模型只有 800MB,数据完全不出域,延迟还快了将近 7 倍。

对于数据合规要求高、又不想被 API 计费绑架的团队来说,「数据不出域」加「零成本」这两个特性,几乎是决定性的。
Laya Server:让模型开箱即用
Laya 本身只是一个 Python 库,要写代码才能用。而 Laya Server 是 OnePyro 团队做的开源项目,给它套了一层壳,实现开箱即用。它有四个特点:
- 提供 System 接口,兼容 JF 协议,三类问题可以一次批量调用;
- 镜像里直接内置了多语言模型,拉下来就能跑,不用额外下载;
- 自带网页管理后台,能管理 API Key、在线调试、查看用量统计,界面支持简体中文、英文和繁体中文;
- 安全做得比较到位:管理员密码用(哈希算法)存储,登录有限流和 CSRF 保护,API Key 只存哈希摘要,不怕泄露。

部署过程很简单:在 OnePyro 应用商店里搜索 Laya Server,点击安装,Web UI 端口保持 8080,管理员用户名设为 Admin,密码按规范设置至少 10 位。确认后服务很快就部署完成。
登录后进入控制台首页,界面非常简洁。按页面提示创建新密钥即可,注意这个密钥只显示一次,要及时保存。下面还有试用 Playground 和接口文档,可以直接在网页上调试,不用先写代码。
文中提到管理员密码使用「哈希算法」存储,这里指的是密码哈希(Password Hashing)而非普通摘要哈希(如 MD5/SHA-1)。密码哈希专门设计为计算缓慢、且包含随机盐值(Salt),常见实现有 bcrypt、Argon2 等,目的是让暴力破解的时间成本极高。API Key「只存哈希摘要」则意味着即使数据库泄露,攻击者也无法直接还原出原始 Key,这与 GitHub、Stripe 等主流平台的 Token 管理方式一致——这也是为什么系统提示「密钥只显示一次」,因为服务端自身也无法再次查看明文。CSRF(Cross-Site Request Forgery,跨站请求伪造)保护则防止恶意网页借用已登录用户的身份偷偷发起管理操作。
在 AI 网关里当「智能门卫」
Laya 最实用的落地场景之一,是在 AI 网关中充当智能路由。
这里 Laya 扮演的角色是「智能调度员」:网关收到用户请求后,先交给 Laya 判断该发给哪个模型组。配置时把策略的提供商与模型改为 Auto,然后填三样东西——服务地址(Laya Server 地址)、API Key(刚生成的密钥)、兜底模型。

设置好检查点后,Laya 会自动按输入内容做判断。比如:
- 用户问「帮我写个 Python 爬虫」,Laya 判断这是代码分析类,路由到复杂模型;
- 用户问「北京明天天气怎么样」,Laya 判断是简单问答,路由到快而便宜的简单模型。
换句话说,Laya Server 在 AI 网关里不是替代大模型,而是站在大模型前面当门卫,用几十毫秒决定「这个问题该让谁回答」。复杂请求交给强模型,简单请求交给快模型,整体成本和延迟都能显著降下来。
AI 网关(AI Gateway)是近两年随大模型落地而兴起的基础设施层,功能类似传统 API 网关,但专门针对 LLM 调用做了扩展:统一管理多家模型供应商的密钥、限流、计费、日志,以及请求的负载均衡与故障转移。在成本优化层面,「智能路由」是核心诉求之一——用简单规则或轻量分类模型把请求分流到不同能力层级的模型,避免把「查天气」之类的简单问题浪费在 GPT-4 级别的高成本模型上。Laya 扮演的正是这个路由分类器角色:以极低的自身延迟(7-33 毫秒)换取整体链路的成本和速度优化,是「用小模型降低大模型调用成本」这一思路的典型工程实践。
小模型的价值正在被重新发现
Laya 的走红折射出一个趋势:并非所有任务都需要动用昂贵的大模型。判断、分类、路由这类结构化决策任务,用一个几亿参数的小模型就能又快又稳地完成,还能省下大笔推理成本。
在大模型军备竞赛的喧嚣中,Laya 这类「小而专」的开源方案,给出了一条务实的降本增效路径——尤其是对那些既要控制成本、又对数据合规敏感的团队而言,它的吸引力大家都看得到。
相关推荐
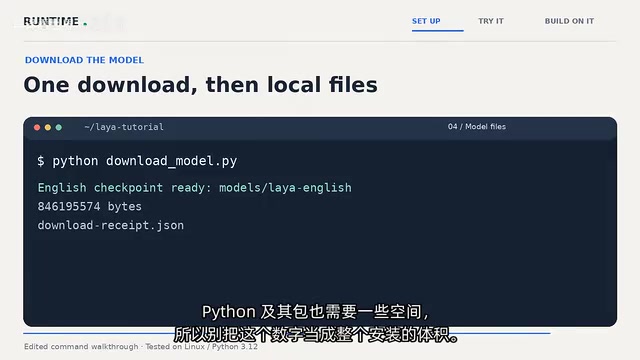
本地部署开源Laya实战:搭建环境并运行三个AI客服分类演示
开源项目 Laya 本地部署完整实战:从虚拟环境搭建、模型下载到三个客服文本分类演示,涵盖置信度阈值判断与接入本地大模型生成草稿回复,全程 CPU 运行无需 API 密钥。
Athena:让AI智能体学会遗忘的三层记忆系统
Athena是一个开源AI智能体记忆服务,采用三层结构与艾宾浩斯遗忘曲线机制,让智能体主动决定记住什么、遗忘什么。本文解析其话题切链、热度评分与间隔重复原理。
Qwen-Image-2.1 开源实测:7B参数媲美闭源图片模型
Qwen-Image-2.1 正式开源,视觉生成仅 7B 参数却媲美顶级闭源图片模型,支持多图参考编辑、透明图像生成与消费级显卡本地部署。本文实测其效果与 ComfyUI 部署全流程。