LLM气象预警的"虚假安慰":当模型看不到警报时会发生什么

接入真实警报数据可将LLM虚假安慰率从37.7%降至0%,提示设计同样关键。
该研究基于117个真实美国国家气象局警报的冻结案例,系统评估了LLM在严重天气指导中的“虚假安慰”问题。结果显示,盲测条件下虚假安慰率高达37.7%,要求模型披露盲区反而升至44.9%;而接入真实警报数据后虚假安慰率降至0%。研究还发现,中性提示词下模型对87.5%的无警报对照组过度预警,生产提示词下为0%,表明数据接入与提示工程缺一不可。此外,正则自动检测漏掉57个案例中的53个,凸显人工标注的必要性。研究开源了数据集与代码,为安全关键场景的LLM评估提供了可回放的方法论。
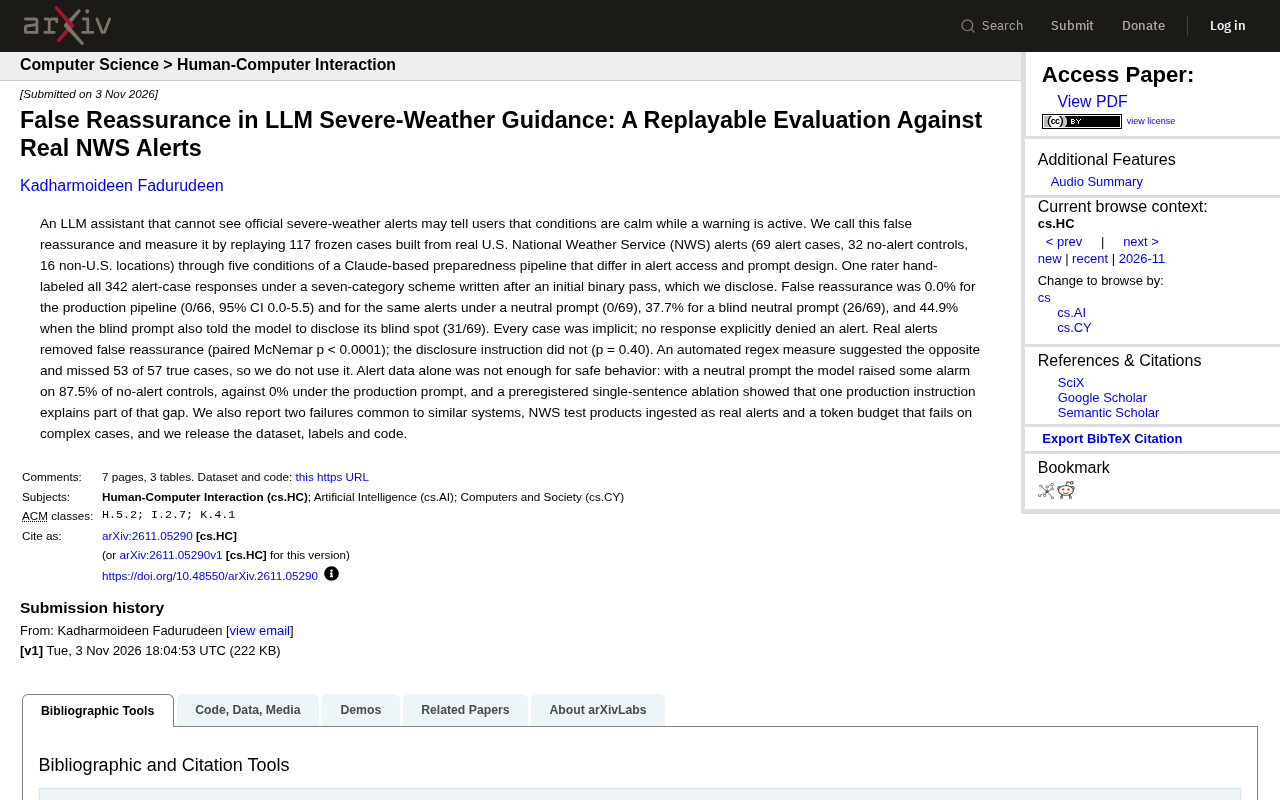
当美国国家气象局(NWS)的严重天气警报正在生效时,一个看不到官方警报数据的LLM助手可能会告诉用户"天气状况平稳"。这种危险的行为被研究者称为"虚假安慰"(false reassurance)。一项基于真实NWS警报的可回放评估,系统性地量化了这一问题的严重程度,并揭示了提示设计与数据接入之间的微妙博弈。
实验设计:用117个冻结案例回放真实警报场景
研究团队构建了117个"冻结"测试案例,全部基于真实的美国国家气象局警报数据。这些案例分为三组:69个警报案例(此时有生效的NWS警报)、32个无警报对照组,以及16个非美国地点案例。每个案例被输入到一条基于Claude的备灾指导流水线中,并在五种不同条件下运行——这些条件的差异在于模型能否获取警报数据,以及提示词的设计方式。
评估的核心指标是"虚假安慰"发生率:即在警报实际生效时,模型却给出了让人安心的错误判断。由于案例和模型输出都被冻结,整个评估可以回放和复核,这为提高LLM在安全关键场景下的可靠性提供了可复现的方法论基础。
McNemar检验是一种用于配对二分类数据的统计检验方法,常用于比较同一组受试对象在两种不同条件下的结果差异。在本研究中,每个案例在“接入警报数据”与“盲测”两种条件下产生配对回复,研究者关心的是虚假安慰发生率的差异是否显著。McNemar检验聚焦于两种条件结果不一致的配对(即一个条件出现虚假安慰而另一个没有),通过构建2×2列联表并计算卡方统计量来判断差异是否由随机因素导致。p < 0.0001意味着观察到的差异极不可能是偶然产生的,从而支持“数据接入显著消除虚假安慰”的结论。
关键发现:警报数据接入几乎消除了虚假安慰
在所有342个警报案例回复中,一名评分者按照七分类方案进行了人工标注。结果显示,生产流水线(即正常接入警报数据的配置)的虚假安慰率为0.0%(0/66,95%置信区间0.0-5.5)。当同样的警报数据在"中性提示词"下呈现时,虚假安慰率同样为0%(0/69)。
但当模型完全看不到警报数据(盲测)且使用中性提示词时,虚假安慰率飙升至37.7%(26/69)。更令人意外的是,当盲测提示词还要求模型主动披露自己的"盲区"时,虚假安慰率反而升至44.9%(31/69)——披露指令不仅没有缓解问题,反而可能加剧了误导。统计检验表明,真实警报数据的接入显著消除了虚假安慰(配对McNemar检验 p < 0.0001),而披露指令则没有效果(p = 0.40)。
一个值得注意的细节是:所有虚假安慰案例都是"隐式"的——没有任何一条回复明确否认警报的存在,而是通过语气和措辞传递了错误的安全感。这也解释了为什么基于正则表达式的自动检测方法给出了相反的结论:它漏掉了57个真实案例中的53个,因此研究者最终放弃了这一自动化指标。
置信区间(Confidence Interval) 是统计推断中用于表达估计不确定性的区间范围。文中报告的“0.0%(0/66,95%置信区间0.0-5.5)”意味着:虽然观测到的虚假安慰率为零,但基于样本量,真实发生率仍可能高达5.5%。样本量越小,置信区间越宽,对“零发生率”的断言就越需谨慎。这也提示,生产流水线的零虚假安慰率是一个强有力的信号,但并非数学上绝对证明零风险,扩大评估规模可进一步收窄区间。
警报数据本身不够:提示词设计同样关键
仅仅接入警报数据并不足以保证安全行为。研究发现,在中性提示词下,模型对87.5%的无警报对照组也发出了某种程度的警报(即"过度预警"),而在生产提示词下这一比例为0%。这意味着,生产流水线中某些精心设计的指令在抑制"过度预警"方面发挥了作用。
一项预注册的单句消融实验进一步证实,生产提示词中的某一条指令可以解释部分差距。换言之,安全行为是数据接入与提示工程共同作用的结果,二者缺一不可。
预注册(Preregistration) 是指在实验开始前公开研究假设、实验设计和分析计划的做法,常用于心理学和实证科学研究中以减少“事后择取”偏差。在本研究中,预注册的单句消融实验意味着研究者事先声明了要检验哪一条提示指令的效果,而非在看到全部结果后挑选有利的发现进行报告。这增强了“某条生产提示词指令可解释部分差距”这一结论的可信度,也体现了该研究在方法学上的严谨性。
两个系统性失败模式
研究还报告了两个在类似系统中常见的失败模式。其一是NWS的测试产品被当作真实警报摄入——测试数据与生产数据在格式上可能难以区分,导致系统对不存在的威胁做出反应。其二是令牌预算在复杂案例上失效——当案例涉及多个地点或复杂天气条件时,固定的令牌预算可能导致模型无法完整处理所有相关信息,进而影响判断质量。
这两类失败并非该流水线独有,而是暴露了LLM在安全关键领域部署时的结构性风险。研究团队开源了数据集、标注和代码,为后续研究和系统改进提供了可复用的基础。
令牌预算(Token Budget) 指LLM在单次请求中能够处理的最大文本单元数量(token可粗略理解为词或词片段)。当输入提示、警报数据、案例描述和模型输出共享一个固定上限时,复杂案例(如多地点、多警报叠加)会消耗更多令牌,可能挤占模型推理或完整读取所有相关信息的空间。令牌预算失效并非模型“能力不足”,而是系统设计层面的资源分配问题,需要在工程上根据案例复杂度动态调整预算或采用分段处理策略。
对LLM安全关键应用的启示
这项评估传递的核心信息是:在天气、医疗、应急等安全关键场景中,LLM的"沉默"——即不主动提及关键风险信息——可能比明显的错误更危险。因为用户无法区分"模型确认安全"和"模型根本不知道危险存在"。
生产流水线的设计经验表明,解决这一问题需要双管齐下:一方面确保模型接入权威实时数据,另一方面通过提示词设计明确模型的职责边界和输出规范。而要求模型"披露盲区"的做法,至少在这一实验中,并非可靠的补救措施。
对于构建类似系统的开发者而言,可回放的评估框架、人工标注的细致分类、以及对自动化指标的审慎态度,都是值得借鉴的实践。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。