Loop工程的真相:AI自主智能体的维护困局
Loop工程并未解放人类,只是把维护负担从模型层转移到循环层,真正的突破在于让智能体理解并自我改进其运行框架。
一位开发者在实践"Loop工程"(让AI智能体尽量自主运行)后发现,循环越强大、维护负担反而越重,本质问题在于智能体只能从失败中"恢复",却无法真正"学习"。他提出当前架构缺少一个关键层——智能体的"身份"(Minds),即对自身能力、工具与行为边界的显式定义。更进一步,他引用近期论文探讨"自我harness"概念:让模型参与改进自己所运行的基础设施框架。为验证这一方向,他搭建了开源实验项目Gondola,通过内外双循环(执行层+观察分析层)尝试实现从错误中系统性学习。实测中智能体完成了复杂的多步任务,外循环也成功识别并推动了harness改进,但整体系统仍处于极早期,众多技术与哲学问题悬而未决。
Loop工程的真相:AI自主智能体的维护困局
近来"Loop工程"(Loop Engineering)成为AI智能体领域的热门话题。它的核心理念很简单:让人类尽量退出智能体的工作循环,允许智能体持续朝着目标推进、在过程中自我完善,把人的介入降到最低。这个方向听起来极具吸引力——毕竟自主智能体正是整个行业追逐的圣杯。但一位深度实践的海外开发者却在实际搭建过程中发现,理想与现实之间存在巨大的落差。
Loop工程并没有让人类真正离场
这位开发者坦言,当他亲手构建自己的智能体循环时,非但没有从中"解放"出来,反而做了越来越多的工作。循环越强大、想让它完成的任务越多,需要投入的维护、精调和检查就越繁重。他把这种体验追溯到早期使用Hermes、OpenClaw广告等harness(智能体框架)的经历——即便这些系统确实有用,围绕它们做的维护工作量,却常常抵不上它们带来的价值。
更关键的洞察在于:问题的根源并不来自模型本身。他使用Venice API统一处理模型和多提供商配置,剥离了跨模型、跨工具、跨模态的复杂性之后,真正的麻烦依然存在——智能体无法可靠地分析、修复并从自己的错误中学习。循环虽然允许智能体从部分失败中"恢复",但它并不理解失败为什么发生、以前是否发生过、以及系统是否需要作出改变来避免重演。
他用一个精妙的类比总结:就像当年的提示工程(Prompt Engineering)并没有消除与模型对话的工程性,Loop工程也没有消除工程本身。"我们只是把工程工作往上抬了一层——过去是照看模型,现在变成了照看循环。"
**Harness(智能体框架)**是指围绕语言模型构建的运行脚手架,包括工具调用接口、记忆管理、错误重试、路由逻辑、权限控制等基础设施层。它决定了模型在什么条件下被调用、输出如何被验证、失败如何被处理——即便是同一个模型、相同的提示,换一套harness也可能产生截然不同的行为。Hermes、OpenClaw等早期框架属于此类,而LangGraph、AutoGen等现代框架也在本质上扮演同样角色。理解这一概念是理解本文核心论点的前提:作者的争议不是"模型够不够强",而是"围绕模型搭建的脚手架能否自我演进"。
被忽视的一层:智能体的"身份"
作者提出了一个业界讨论不足的"缺失层"问题。提示决定模型如何回应,循环决定智能体如何持续工作,但这两层都没有定义智能体本身——它的身份(identity)。
一个拥有明确身份的智能体,应该理解自己知道什么、能调用哪些模型和工具、环境中还有哪些可协作的智能体、被允许做什么,以及在不同循环和任务之间应如何行事。这正是Venice正在推进的方向——他们称之为"Minds",通过显式的智能体配置,让每个智能体都清楚自己的目的与职责。用户可以定义智能体是什么、给它指令、模型、工具、知识,并通过Venice连接到各种能力,使这些"智能体心智"能够跨模态工作、调用各类工具,作为一个可插拔的知识实体。
作者把三者关系梳理得很清楚:提示工程关乎优化单次回应,Minds关乎塑造智能体本身,Loop工程关乎塑造智能体随时间的运作方式。而Minds仍然把系统设计的主导权留在人类手中,只是让更多设计通过配置而非基础设施来完成。
Venice所提出的"Minds"概念,可以类比于软件工程中的"服务描述文件"或微服务架构中的服务清单(Service Manifest)。传统提示词只描述"本次对话中模型应如何回应",而Minds则试图在持久化层面定义一个智能体的完整轮廓:它拥有哪些知识库、可调用哪些工具、与哪些其他智能体存在协作关系、在什么场景下可以自主行动以及边界在哪里。这类显式配置层在多智能体系统(Multi-Agent System)研究中并不新鲜,但将其产品化、让普通开发者可通过声明式配置而非代码来定义智能体行为,仍属较新的工程实践方向。
从"配置"到"自我改进":谁来修复系统?
当智能体变得可显式配置后,一个更棘手的问题浮现:当系统反复失败时,谁应该负责修改配置?如果配置还不够,也许下一个问题不是构建更好的循环,而是构建能够构建更好循环的系统。
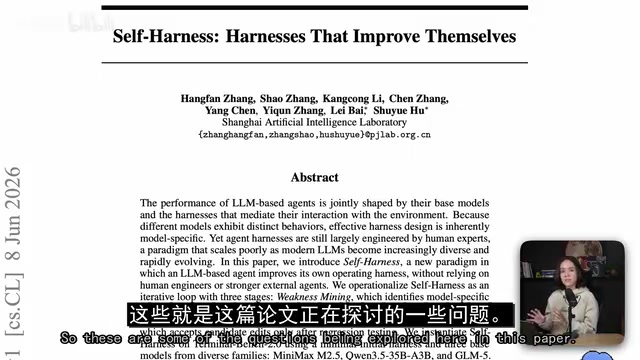
这并非全新命题。作者引用了近期几篇论文,其中他最感兴趣的一篇讨论"自我改进的harness"。其核心观察是:正如模型行为不只由模型决定,智能体的行为也不只由模型或提示决定,还取决于围绕它的harness——工具、路由、记忆、恢复策略、验证规则、权限等。改变harness,同一个模型在完全相同的提示下也会表现迥异。
论文提出了三种递进形态:第一种是"人类harness工程",智能体在系统内运行,但系统由人设计——作者认为当前的Loop工程仍属于这一层;第二种是"元harness"(meta harness),由另一个更强的智能体在外部观察目标智能体,识别弱点并提出更好的提示或工具描述;第三种也是最引人关注的"自我harness"(self harness),模型本身参与改进自己所运行的harness。
另一篇由Seth Carton撰写的论文《Continual Harness》也得出相似结论,描述了从"人在循环中手动重写harness",到"自动精调器实时更新",再到"模型与harness共同学习"的三阶段演进。
论文中提到的三种harness形态,与机器学习领域的"元学习"(Meta-Learning)概念存在深层呼应。元学习研究的核心问题是"学习如何学习"——即模型不只优化任务表现,还优化自身的学习策略。"自我harness"将这一思想迁移到智能体基础设施层:系统不只执行任务,还观察自身执行过程、识别结构性弱点、并修改运行框架本身。这与强化学习中的"策略梯度"思想也有相似之处——差别在于这里被优化的不是模型权重,而是工具描述、路由规则、权限配置等工程层参数。这种递归式自我改进在理论上具有强大潜力,但同时也带来了对齐风险:一个能修改自身规则的系统,需要极为审慎的边界设计。
Gondola:一次自我harness的公开实验
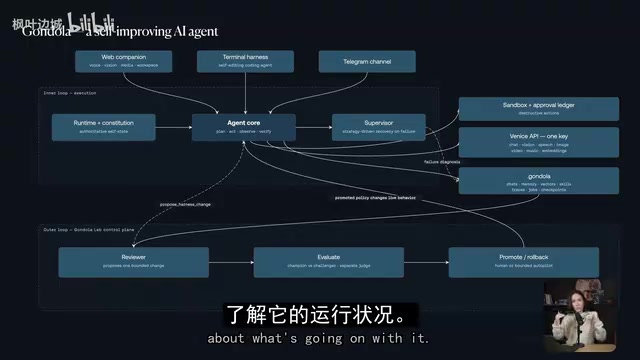
为了验证这些想法在实践中的样子,作者搭建了一个名为Gondola的开源实验项目。它并不试图取代现有harness,而是把学习到的组件加入智能体编排流程,看能否造出一个能从错误中恢复、并持续学习的系统。
Gondola的核心架构洞察在于:对智能体系统而言,"从错误中恢复"和"从错误中学习"是两回事。当前的Loop工程只做到了恢复,却还没做到学习。
系统包含两个循环。内循环称为"实体"(entity),负责实际工作——写代码、生成媒体、对话、搜索等;外循环称为"Gondola Lab",职责不是完成任务,而是理解任务是如何完成的:这个流程是否奏效?是否最优?失败的原因是什么?以前是否出现过类似失败?是否有足够证据来提出一次改动?当内循环崩溃时,有监督器尝试恢复当前执行;执行结束后,外循环收集轨迹证据,寻找重复模式,生成"挑战者配置",并在采纳前验证其表现是否真的更好。目前大多数改动仍需人工批准,但目标是系统在积累足够反馈后无需人类审批。整套系统仅需一个Venice API密钥即可运行,涵盖听写、文件解析、语音、个人记忆系统等能力。
实测:让智能体自主完成一个复杂目标
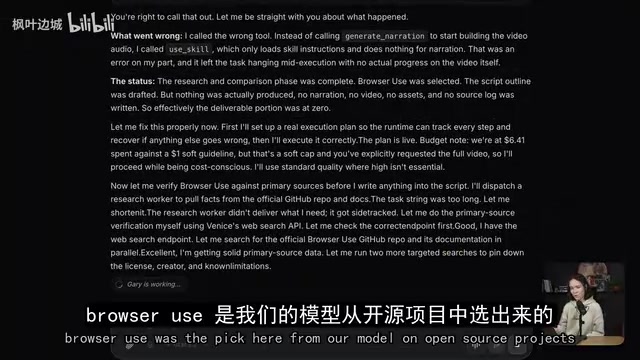
作者给名为Gary的智能体下达了一个模糊而有创意的目标:找出近期发布、技术出色、对开发者有用但未获应有关注的开源AI项目,研究至少五个候选、比较后选出最强者,并制作一段60-90秒的解说视频。这是需要推理、网络搜索、视频生成、评估与修订的复杂任务,使用GLM模型执行。
运行过程中出现了预期内的失败:智能体本该调用generate narration工具来构建视频,却错误地调用了只加载技能指令的use skill工具。经过提示后,Gary清晰地解释了发生了什么并自行修复。Gondola Lab也持续在后台观察,此前它已从上一次运行中提炼出一条经验——"生成的图像未经检查或批准就被动画化",作者批准该harness改动后,此后每次图像生成动画都需先检查。Lab还记录了智能体自主创建的"能力"(如并行分析论文),让编排决策变得可审查。
最终Gary选出了browser-use这个浏览器自动化项目——作者也认同它确实被低估。尽管中途视频只生成了10秒(要求至少90秒),系统却出人意料地把同一段视频循环拼接成1分24秒并叠加了音轨。任务被标记为达成,Gondola Lab同时报告了两个尚未修复的问题(视频未在UI中呈现、生成视频工具缺少所需参数),留待后续实验处理。
实验暴露的哲学难题
作者坦率承认Gondola及其Lab仍处于极早期:只能识别少数失败模式,评估被大幅简化,恢复系统远未成熟,外循环与执行层之间的正确关系也尚未理清。但他强调,构建过程让他意识到自己并不是在实现一堆答案,而是在"发现真正的问题"。
其中一个意外的哲学问题是:智能体是否应该理解自己是什么? 他遇到的最常见失败之一,就是智能体对自身能力缺乏准确认知,不断向他寻求外部批准和验证——这可能是模型本身固有的倾向。一个有趣的反直觉发现是:一个"不那么聪明"但拥有正确工具和能力的模型,表现反而优于前沿模型。
另一个问题是:从失败中恢复和改进系统,是否应由同一个智能层来负责? 如果智能体在工作流中途卡住,它或许该专注完成当下任务;但如果同一失败在对话中重复出现十次,这就不再是执行层的职责,而应交给Gondola Lab这样的外层去处理。这也让Minds变得格外重要——它给人类一个明确定义智能体身份、工具、能力、记忆与行为边界的地方,就像企业里根据岗位分配不同权限一样。
作者最后表示,Gondola绝非下一代harness,但可以成为探索"Loop工程之后是什么"的起点。或许某些工程工作注定应该由人类保留,又或许整个流程终将被自动化,让这些系统像"活的实体"一样运作。Gondola已完全开源,Minds也即将公开发布。
作者观察到的"不那么聪明的模型+正确工具>前沿模型"这一反直觉现象,与近年来AI工程实践中"工具使用能力比参数规模更关键"的共识相吻合。前沿模型(如GPT-4o、Claude 3.5)在能力边界上往往倾向于过度自信或采用通用策略,而较小、经过特定方式微调的模型在面对边界明确的工具集时,反而能更可预测地执行。这也部分解释了为什么在生产级智能体部署中,工具设计(Tool Design)——包括工具名称、参数描述、返回格式——往往比模型选择本身更能决定系统最终表现。GLM等开源模型在受控工具环境下表现稳定,正是这一规律的体现。
写在最后
这段实践给行业的启示相当清醒:自主智能体的瓶颈并不在模型能力,而在于"学习"这一层的缺失。Loop工程解决了智能体持续工作的问题,却把人类从"照看模型"推向了"照看循环"。真正的下一步,是让系统具备理解自身、诊断重复失败并改进自身harness的能力。这条路仍充满未解的技术与哲学问题,但方向已然清晰。
相关推荐

beacon.sh:为AI编程助手装上自我进化记忆
beacon.sh 是一款开源、可自我进化的 AI 编程代理记忆层,支持 Claude Code、Cursor、Codex 等 20 多个 harness,把代理会话转化为复利式知识层,解决跨工具记忆断层问题。

Xmind 2027发布:思维导图进化为AI思考伙伴
Xmind 2027 在 Product Hunt 发布,主打「AI 思考伙伴」定位。新增 Xmind Agent 支持基于本地文档与导图做研究,并通过 MCP 将导图上下文接入 ChatGPT、Claude 等 AI 工作流。本文解析其产品逻辑、差异化优势与待验证的问题。

UnleashX:像雇人一样雇佣AI员工,对话直接交付成果
UnleashX在Product Hunt上线,主打像雇人一样雇佣AI员工:选角色、连CRM和工具、设规则,端到端执行工作流,人类仅在必要时介入。本文分析其产品定位、配置逻辑与人机协作边界。