LoRA模型短标题跳过首行?原因与解法

LoRA 微调模型在短 caption 下跳过根节点行,疑因训练与推理的 caption 长度分布不匹配。
一位 MSc 学生在 Reddit 报告:Qwen3-0.6B 经 LoRA 微调后用于 LEGO 模型文本生成,当 caption 很短(约 4 token)时模型总是跳过第一行根节点,直接从 "b" 开始输出,违反语法;caption 达 18+ token 时则 36/36 正确。用户已排除保存/解码 bug、tokenisation 不一致和强制前缀无效等因素,提出训练 caption 可能全为长描述、导致条件分布偏移的假设,同时怀疑 bf16 合并两个堆叠适配器带来数值误差。建议包括约束解码控制整个根节点行、在 SFT 数据中加入短 caption 增强,以及检查训练 caption 长度分布。
一位 MSc 学生在 Reddit 上报告了一个棘手的 LoRA 微调问题:当条件文本(caption)很短时,模型会跳过输出的第一行(根节点行),直接从第二个 token 开始生成,导致语法错误。该问题在 BrickNet 项目(CVPR 2026)中出现,使用 Qwen3-0.6B 模型和 LoRA 适配器。

问题现象:短 caption 下模型“失忆”
据该用户描述,模型经过 LoRA 微调后,负责将 LEGO 模型表示为纯文本。文本格式为:第一行是根节点("a <part> | <colour>"),随后是成对的节点行和边行。用户合并了 PT 适配器(学习文本格式)和 SFT 适配器(以 caption 为条件),使用 peft merge_and_unload 以 bf16 精度合并,然后用 caption token 加换行 token 作为提示。
问题在于:当 caption 很短(例如 "A red car.",约 4 个 token)时,模型从不写出根节点行。第一个生成的 token 总是 "b",输出因此违反语法。用户测试了五个不同物体,每个 12 次生成,结果 0/12 正确。而当 caption 达到约 18+ token 时,模型每次都正确写出 "a"(三个新物体,36/36 正确)。
LoRA(Low-Rank Adaptation) 是一种参数高效微调方法:它冻结预训练模型的原权重,只在 Transformer 的线性层旁注入两个低秩矩阵 A 和 B(秩 r 远小于原维度),训练时仅更新这两个小矩阵。推理时可选择将 LoRA 权重按 W' = W + BA 合并回原权重,从而不增加推理延迟。本文中用户先用 PT 适配器学习 LEGO 文本格式,再用 SFT 适配器学习以 caption 为条件生成,两个适配器叠加后通过 merge_and_unload 合并为单一权重。理解“堆叠适配器 + 合并”这一流程,有助于判断 bf16 精度下低秩矩阵相乘与累加可能引入的舍入误差如何影响起始 token 的预测。
已排除的嫌疑
用户已经排除了几个常见原因:
- 保存/解码 bug:检查了原始 token,第一个确实是 "b"。
- Tokenisation 不匹配:
train.py和generate.py对 caption 的编码方式一致,都是单独编码 caption 再追加换行 token。 - 强制前缀无效:即使强制模型以 "a" 开头,它也会直接写节点和边,仿佛根节点已经写过。
- 并非信息量问题:一个 31 词但主要是填充内容的 caption 也能正常工作。但在 15 token 左右时表现不稳定(一个 9 词的零件列表对汽车有效,对椅子只有 1/12 正确)。
目前可行的 workaround 是将短 caption 扩展为完整描述,但用户希望理解根本原因。
条件分布偏移(conditional distribution shift) 指模型在推理时接收到的条件输入分布与训练时不同。在 SFT 中,模型学习的是 P(输出 | caption);若训练集 caption 普遍较长(如 18+ token 的完整描述),模型隐含地依赖“长 caption 之后紧跟换行再进入根节点”这一模式。推理时短 caption(约 4 token)落在训练分布之外,模型对“换行 token 之后应输出根节点”的置信度下降,转而预测节点行首 token。这并非模型“遗忘”语法,而是条件概率在分布外输入上的系统性偏移,属于典型的分布外泛化失败。
可能的原因:训练数据分布偏移
该用户提出了一个关键假设:训练时的 caption 可能都是长描述,而推理时短 caption 的分布与训练分布严重不匹配。这属于典型的条件分布偏移问题——模型在 SFT 阶段习惯了“长 caption + 换行 + 路径”的模式,当 caption 异常短时,模型可能将“换行”误判为已经进入路径部分,从而跳过根节点。
另一个因素可能是 bf16 合并两个堆叠适配器带来的数值误差。用户计划测试 fp32 合并,这是一个合理的排查方向。bf16 的精度损失在叠加适配器时可能被放大,影响模型对起始 token 的预测。
bf16(bfloat16) 是 16 位浮点格式,保留 8 位指数(与 fp32 相同)但仅 7 位尾数,动态范围大而精度较低。合并两个 LoRA 适配器时需计算 W + B₁A₁ + B₂A₂,低秩矩阵乘积的中间结果在 bf16 下有效位数有限,多次累加会放大舍入误差。若误差恰好落在决定首个 token 的 logits 差距很小的位置上,就可能把本应偏向 "a" 的预测翻转为 "b"。改用 fp32 合并可保留约 24 位尾数,是排查数值因素的直接手段;但需注意,若分布偏移是主因,fp32 合并未必能完全修复。
解决方案建议
针对这一问题,有几种可能的解决路径:
短期修复:约束解码,强制第一个 token 为 "a"。但用户尝试强制前缀后模型仍然跳过节点行,说明问题不只是第一个 token,而是模型对“根节点已存在”的假设。因此约束解码需要更精细地控制整个根节点行。
中期改进:短 caption 数据增强。在 SFT 训练集中加入短 caption 样本,让模型见过“短 caption + 换行 + 根节点”的模式。这是最直接的分布对齐方法。
长期排查:检查训练数据中 caption 的长度分布。如果确实全是长描述,那么短 caption 推理就是分布外泛化问题,数据增强是根本解法。
该用户也承认样本量小(每个 caption 12 次)、仅测试了 0.6B 模型、模型质量靠肉眼判断,这些局限性值得注意。
约束解码(constrained decoding) 是在生成每一步对 logits 施加掩码、只允许符合语法或格式的 token 被采样。常见实现包括 Hugging Face 的 prefix_allowed_tokens_fn、Outlines、Guidance 等。本文的教训是:若只强制首 token 为 "a",模型仍可能认为根节点行已结束而直接输出节点行,因此约束需覆盖整行结构(如用正则或语法约束保证 "a <part> | <colour>\n" 完整出现)。约束解码是推理期的补丁,不能替代训练分布的对齐,宜与短 caption 数据增强配合使用。
对 LoRA 实践者的启示
这个案例提醒我们,LoRA 微调中的条件文本长度分布一致性至关重要。许多教程关注数据质量和任务匹配,却忽略了推理时条件文本的长度分布。当训练和推理的条件输入在长度、风格上存在显著差异时,模型可能表现出意外的行为。
对于类似 BrickNet 的序列生成任务,建议在训练时混合不同长度的 caption,并在推理时监控首个 token 的分布。如果发现模型跳过结构标记,优先检查条件文本的分布偏移,而不是急于调整解码策略。
相关推荐
Claude Code隐藏设置:开启Idle Compaction省大钱
Claude Code 的 Idle Compaction 设置可避免提示缓存过期后整段上下文按全价重发。本文介绍问题根源、开启路径与注意事项,帮助开发者降低长会话的 API 成本。
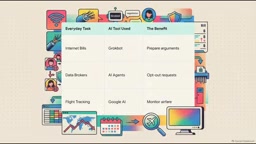
13个AI实用技巧:省钱、护隐私、升级数字生活
梳理The Explainer分享的13个AI实用技巧,涵盖用AI代理省钱谈判、数据删除请求、Claude Code诊断电脑、本地离线模型、车内语音学习与运动姿态分析,并强调人类监督与安全边界。
Claude Code省钱三件套:三个免费工具砍掉Token浪费
介绍Claude Code三个免费Token优化工具:RTK压缩终端输出、Caveman精简回复、微软Token Economizer学习仓库剪掉未用工具,测试中成本降低18%到31%,并提醒micro skills默认关闭需手动开启。