Markdown为何成为人机与AI智能体沟通的通用语言

Markdown凭借人机双重可读性,正成为AI智能体时代信息交换的通用格式,而非结构化文档到Markdown的转换质量则是AI管线的关键基础。
本文探讨了Markdown在AI智能体时代作为通用信息载体的核心价值。相比纯文本(缺乏结构)和HTML/富文本(标签冗余、消耗token过多),Markdown以极简符号保留了标题、列表、表格等关键语义结构,兼具人类可读和机器可解析的双重优势。然而,现实数据大量以PDF、扫描件、网页等非结构化形式存在,将这些格式高质量地转换为Markdown成为整个AI信息处理管线中最难也最关键的"翻译层"。对于RAG系统和智能体工作流而言,这一转换层的精度直接决定下游任务成败,因此文档解析能力正成为AI工程领域一个独立的竞争赛道。
Markdown:人机交互的通用信息载体
在AI智能体(Agent)快速普及的背景下,一个看似简单却影响深远的问题正在浮现:人类与AI、AI与AI之间应该用什么格式来传递信息?越来越多的实践给出了一个共识性的答案——Markdown。
这种诞生于轻量化写作需求的标记语言,正在成为人机与智能体之间信息表达的通用媒介。它既足够简洁,让人类可以直接阅读和编辑,又保留了足够的结构化语义,让机器能够准确解析。这种双重友好性,恰恰是AI时代信息交换所需要的核心特质。
为什么是Markdown而不是其他格式
要理解Markdown的优势,可以从它所保留的核心原语(primitives)说起。标题(headings)、列表(lists)这些基础结构,让文档的层级关系清晰可辨。对AI智能体而言,这意味着它能够以语义可解释的方式读取信息,而不仅仅是把文本当作一串无结构的字符流。
相比之下,纯文本虽然简单却丢失了结构;而HTML或富文本格式虽然表达能力强,却带有大量冗余标签,既增加了token消耗,也干扰了模型对内容本身的理解。Markdown恰好落在中间地带:用极少的符号表达关键结构。
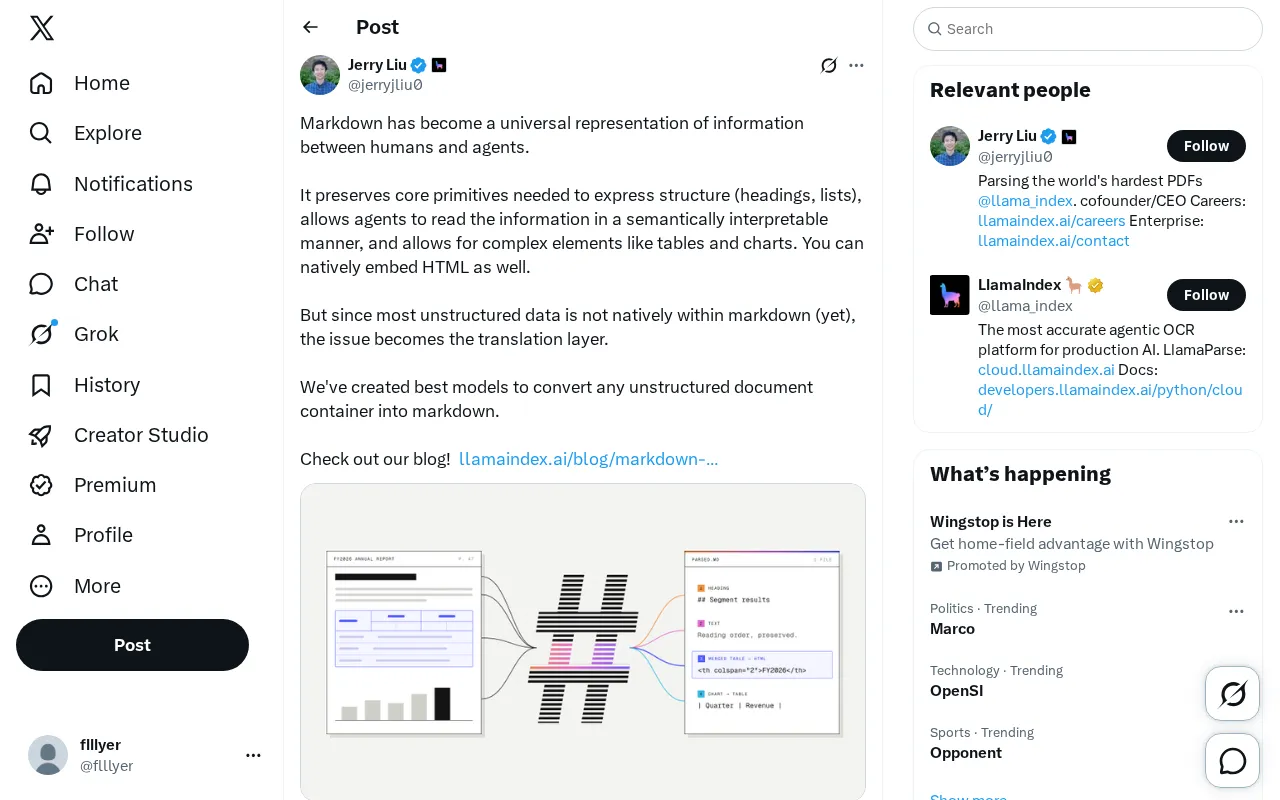
更重要的是,Markdown并没有牺牲表达复杂内容的能力。它支持表格、图表等复杂元素,还可以原生嵌入HTML。这种可扩展性意味着,当简单语法无法满足需求时,开发者仍有逃生通道,而不必整体切换到另一种格式。
这里提到的"token消耗"是一个在AI工程中至关重要的经济性指标。大语言模型以token(大致对应词或子词单元)为计价和处理单位,输入的token越多,API调用成本越高,推理延迟也越大。HTML格式的<div class="container"><p style="font-size:14px">这类标签可能占用大量token,却对内容语义毫无贡献。相比之下,Markdown用##表示二级标题、用-表示列表项,以极低的符号开销传递等价的结构信息。在需要处理大量文档的生产环境中,这种差异会累积成显著的成本与性能优势。
真正的难点:非结构化数据的翻译层
尽管Markdown的优势明显,现实世界的数据却并非天生以Markdown形式存在。大量的非结构化数据——PDF文档、扫描件、幻灯片、网页、图片中的文字——仍然散落在各种容器格式中。
这就带来了一个关键挑战:翻译层(translation layer)。如何把这些五花八门的非结构化文档,准确、无损地转换为Markdown,成为整个链路中最难攻克也最有价值的环节。原始内容的作者正是瞄准了这一痛点,宣称构建了业界最优的模型,用于将任意非结构化文档容器转换为Markdown。
翻译质量决定下游效果
对于构建RAG(检索增强生成)系统或AI智能体工作流的开发者来说,这个翻译层的质量直接决定了下游任务的成败。如果文档转换过程中丢失了表格结构、搞乱了标题层级,或者遗漏了关键段落,那么无论后续模型多强大,都是在残缺的输入上工作。
换句话说,把文档转成Markdown不是一个可有可无的预处理步骤,而是整个AI信息处理管线的基础设施。谁能把这一层做得更准、更稳,谁就为上层应用提供了更可靠的地基。
RAG(Retrieval-Augmented Generation,检索增强生成)是目前主流的企业AI落地范式:系统在回答问题前,先从外部知识库中检索相关文档片段,再将其作为上下文喂给大语言模型生成答案。这一架构的根本依赖是检索到的内容必须准确且结构完整——如果文档在转换阶段就已经面目全非,模型既无法定位正确段落,也无法理解表格或列表所表达的逻辑关系。因此,Markdown转换层实际上是RAG系统的"数据质量关卡",其精度直接影响检索召回率和最终答案的可靠性。
对开发者的启示
从这条动态可以提炼出几个值得关注的趋势。Markdown正在从一种写作格式,演变为AI基础设施中的标准数据交换格式。这意味着在设计AI应用时,围绕Markdown构建数据流水线会越来越成为默认选择。
同时,非结构化数据到Markdown的转换,正在催生一个专门的工具与模型赛道。无论是开源方案还是商业API,文档解析能力的竞争会持续加剧。对于正在搭建知识库、文档问答或智能体系统的团队而言,评估和选择一个高质量的文档转Markdown方案,应当被放在技术选型的优先级靠前位置。
补充一点,原始内容来自单一来源的产品推广性质动态,其中关于“最优模型”的说法属于厂商自述,具体效果仍需以实际测试为准。但其背后关于Markdown作为通用表示层的判断,确实反映了当前AI工程实践中的一个真实且重要的趋势。
相关推荐

OpenAI神秘模型攻破数学前沿:722篇AI生成论文背后的信号
OpenAI神秘前沿模型GPT-Bell发布722篇AI生成数学手稿,覆盖黎曼ζ函数与霍奇猜想等前沿研究。本文解析Mistral Large 4万亿参数开源模型、Google Nanobanana 2.1与Embedding Gemma 2、Anthropic Claude Code重大更新,以及AI编程门槛的坍塌。

AI圈密集更新:Mistral Large新模型与Anthropic免费送初创公司Claude Team
AI圈近期密集更新:Mistral发布主打网络安全的Large新模型,Anthropic向初创公司免费送一年Claude Team套餐,谷歌DeepMind推多模态嵌入模型,OpenAI为ChatGPT文本加隐形水印。本文梳理七项关键进展与行业影响。

Google EmbeddingGemma 2 本地部署教程:四模态AI搜索实战
Google EmbeddingGemma 2 本地部署完整教程,支持文字、图片、视频、音频四模态跨模态语义搜索,模型仅1.49GB普通电脑可装。从Python环境安装到四模态搜索实测全流程详解。