MCP 事件驱动扩展:让 AI Agent 摆脱聊天窗口束缚
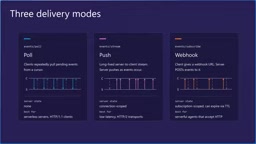
MCP 实验性扩展 Triggers and Events 为 AI Agent 引入事件驱动能力,支持 Pull、Push、Webhook 三种模式。
文章介绍了 AI Agent 触发方式的演变趋势:从用户主动输入,转向由 GitHub、Slack、监控告警等外部事件自动驱动。当前 MCP 协议本质上是请求-响应模型,缺乏标准化的事件接入能力,开发者只能各自拼凑轮询或定制 webhook 方案。为此,MCP 社区正在开发实验性扩展 Triggers and Events,支持客户端向 MCP 服务器注册订阅,并提供 Pull(带游标的轮询)、Push(基于长连接流的服务端推送)和 Webhook(基于 Standard Webhooks 标准的端点回调)三种投递模式。文章以一个无服务器地震监测 Agent 为例,展示了如何在事件驱动的同时彻底消除常驻进程,通过队列、冷存储会话水合和 HMAC 签名验证构建出低成本、安全、可扩展的 Agent 架构。该扩展目前仍处于实验阶段,但有望将事件接入标准化,大幅降低构建事件驱动 Agent 的门槛。
从对话式 Agent 到事件驱动 Agent
大多数人对 AI Agent 的认知还停留在对话式交互层面——通过终端、浏览器或某个专用应用里的聊天窗口敲下指令,Agent 才开始工作。但一位 AWS 资深首席工程师、同时也是 MCP 核心维护者的开发者指出,Agent 的触发方式正在悄然发生变化。
越来越多的 Agent 不再依赖人的主动输入,而是被各种外部事件唤醒:WhatsApp、Telegram、Slack 的消息,GitHub 的 PR 事件、Issue 事件、CI 构建事件,Datadog 这类监控系统的告警,甚至是支付事件。这些事件通过消息队列、newsfeed 或其他系统源源不断地涌入,成为驱动 Agent 运行的新起点。
问题在于,当前的 MCP(Model Context Protocol)本质上是请求-响应模型:工具由 Agent 主动调用,随后返回结果或资源。它天然缺乏接收外部事件的能力。这正是 MCP 社区正在探索的方向。
MCP 的空白:事件接入为何如此困难
在现有架构下,把外部事件送进 Agent 是一件相当麻烦的事。想象一个 GitHub webhook 触发,或某个长时间运行的任务在完成后往队列里丢一条消息,又或者某个文件被修改需要通知——要让这些事件抵达 LLM,开发者往往得自己搭建一套定制化机制。
具体来说,你要么不断轮询某个系统,要么手工搭一套 webhook 服务,再想办法把接收到的事件转化成消息传给 Agent 框架。每套系统都是「一次性」的 bespoke 方案,缺乏标准化,复用性极差。
为填补这一空白,MCP 社区正在开发一个名为 Triggers and Events(触发器与事件) 的实验性扩展。它允许客户端向 MCP 服务器注册订阅——例如声明「我想知道 GitHub PR 何时被打开」「我想知道构建何时完成」,然后通过约定的机制接收这些事件。MCP 客户端会在有事件就绪时通知 Agent,把事件作为消息送入对话流。
MCP(Model Context Protocol)是 Anthropic 于 2024 年底提出的开放协议,旨在为 LLM 提供一套标准化的工具调用与上下文获取接口。其核心架构分为三层:MCP Host(如 Claude Desktop、IDE 插件)、MCP Client(嵌入 Host 的协议客户端)和 MCP Server(对外暴露工具、资源、Prompt 模板的服务端)。现有协议以 JSON-RPC 2.0 为基础,所有交互均由客户端发起请求、服务端返回响应,属于严格的同步请求-响应模式。这一设计在工具调用场景下运转良好,但在需要服务端主动推送数据的场景——如外部系统产生事件后通知 Agent——就显得力不从心。理解这一架构前提,有助于把握为何「让事件进入 Agent」在当前标准下需要开发者额外搭建大量胶水代码。
三种事件投递模式:Pull、Push 与 Webhook
这个实验性扩展提出了三种事件投递方式,各自适配不同的架构场景。
Pull(拉取)
顾名思义,客户端反复向服务器发起同一请求,询问是否有新事件,服务器在事件可用时返回。设计上的巧思在于引入了 cursor(游标) 机制:客户端可以携带「上一次收到的事件」游标,服务器返回下一批事件并给出新的游标,类似分页。首次订阅时使用 null 游标进行 bootstrap。
更有意思的是,轮询频率由客户端自主决定——每秒一次还是每小时一次都可以。同时服务器也能反向建议下次轮询时间,比如「5 分钟后再来」或「1 小时后再来」,客户端可自行决定是否遵守。
Push(推送)
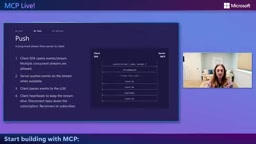
Push 复用了 MCP 已有的 stream 机制,在客户端与服务器之间建立一条长连接的 event stream。连接打开后,双方通过 heartbeat 保持存活,一旦有事件可用,服务器直接沿着这条流推送下来。
这种方式非常适合对低延迟、高吞吐有要求的场景。相比把事件攒成一批再返回,长连接能让事件更快抵达客户端。
Webhook
Webhook 是事件驱动应用中最常见的模式,但过去从未进入 MCP 环境。如果客户端拥有一个可接收事件的 webhook 端点,就可以把这个入站 URL 提供给服务器来创建订阅,之后服务器会把事件直接 POST 到该端点。
它基于 Standard Webhooks 标准,规定了如何共享密钥、如何对 payload 签名,从而让客户端能够验证事件确实来自它所信任的 MCP 服务器,而非攻击者伪造。
需要注意的是,Webhook 更适合所谓 serverful(有常驻服务器) 的 Agent。你笔记本上随时运行的编码助手通常没有对外暴露的 webhook 端点,但作为更大系统的一部分,webhook 可以先把事件丢进队列,再流转到 Agent 应用。
这三种投递模式实际上对应了分布式系统中经典的事件消费范式,各有明确的适用边界。Pull 模式本质上是客户端驱动的轮询,实现简单、无需持久连接,但存在固有的延迟(取决于轮询间隔)和无效请求开销;游标机制的引入借鉴了消息队列(如 Kafka offset)的思路,解决了断线重连后的事件续接问题。Push 模式复用了 HTTP SSE(Server-Sent Events)或类似的长连接流,服务端可主动投递,延迟接近实时,但对网络稳定性要求更高,且在无服务器或 NAT 环境中难以维持长连接。Webhook 则将投递控制权交给服务端,最适合服务端已有明确触发点的场景,但要求客户端必须暴露可公开访问的 HTTP 端点,因此天然不适合本地运行的轻量 Agent。三种模式并非互斥,实际部署中可根据 Agent 的运行环境和延迟要求混合使用。
实战演示:无服务器地震监测 Agent
为展示扩展的实际效果,作者构建了一个地震监测 Agent。数据来源是美国地质调查局(USGS)开放的实时地震数据源——任何人都可调用,覆盖全球。演示中订阅的是过去一天内震级不低于 2.5 的地震,当时一天内全球约有 39 次地震,数据量适中,既保证演示中总有数据,又不至于形成高吞吐压力。
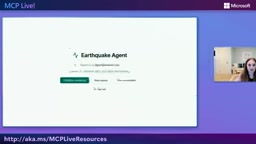
在应用界面里,作者以「客户」身份配置了一份周期性报告:希望了解所有区域的地震,并设置了每 4 小时一次的简报提示词。运行时,一个 MCP 服务器负责拉取 USGS 数据源,再通过 webhook 把新发现的事件推送给 Agent 应用,事件被直接注入 Agent 对话。
演示中,一次汤加地区的 4.6 级地震事件进入对话,附带 USGS 的详细信息与链接,Agent 随即给出分析。而每隔数小时,Agent 会基于该时段内累积的地震(演示中一个四小时窗口收到 6 次)生成汇总简报,标出诸如 5.1 级、构成显著地震集群的重点事件,最终可通过邮件或网页呈现。
架构亮点:既事件驱动,又完全无服务器
这套系统最值得关注的是它同时做到了 event-driven 与 serverless。
通常 MCP 服务器和 Agent 都需要一个常驻进程持续运行,但一天只有几十次地震,让进程 24 小时空转是一种浪费。作者的做法是把整套系统改造成无服务器架构:MCP 服务器每隔约 5 分钟被唤醒一次,拉取 USGS API,识别出从未见过的新地震,查出订阅这些事件的客户,再把事件发往对应的 webhook URL。
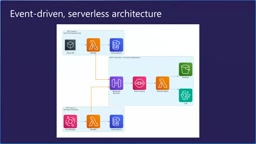
除此之外还有一个作为消息调度器的 MCP 服务器,用来配置简报触发器——比如某客户每 4 小时、另一客户每 8 小时收到一次简报,到点就往 webhook receiver 发送。
唤醒 Agent 的流程也颇具巧思:所有来自 webhook 的内容先进入一个队列,队列再唤醒 Agent;Agent 从冷存储(这里用的是 S3)中「水合」出会话历史,把新事件(可能是简报请求,也可能是一次地震)追加到对话中,跑完一轮 LLM 循环后即关闭。每一轮对话都只是一次函数调用,彻底无服务器。
安全与并发也有相应设计:webhook 携带 HMAC 签名,用订阅时约定的共享密钥验证真伪;同时对每个客户加锁,避免同一客户的 Agent 被并发执行导致对话顺序错乱。生成的简报最终通过专门的 API 存储。
无服务器(Serverless)架构在此语境中特指 Agent 的运行单元不以常驻进程形式存在,而是按需被唤醒、执行完毕后即销毁,计费和资源占用仅发生在实际运行期间。其核心挑战在于状态管理:传统对话式 Agent 依赖进程内存维护会话上下文,而无服务器 Agent 在两次唤醒之间没有运行中的进程,必须将会话历史持久化到外部存储(如 S3、数据库),每次激活时重新「水合」(hydrate)到内存。文章中演示的架构通过队列解耦事件接收与 Agent 执行,队列承担了削峰和顺序保障的职责;加锁机制则防止同一客户的多个事件并发触发多个函数实例、造成会话状态竞争。这一模式与现有的 AWS Lambda + SQS 或类似云原生方案高度契合,说明事件驱动的 Agent 不一定需要专用的常驻服务,完全可以叠加在成熟的无服务器基础设施之上。
一个仍在实验阶段的方向
作者反复强调,Triggers and Events 目前仍是实验性扩展,示例中的 GitHub 订阅等场景是设想而非现实,演示代码也并非生产级系统,仅供参考与启发。MCP 社区每周五设有讨论组,完整提案与可部署的演示代码均已公开,欢迎开发者参与,评估这三种投递模式是否契合自己的系统。
对于正在构建 Agent 的开发者而言,这一扩展的意义在于:它有望把「如何让外部事件进入 Agent」这件长期需要各自造轮子的事情标准化,从而让事件驱动、乃至无服务器的 Agent 架构变得触手可及。
相关推荐
硬件涨价时代,用二手迷你PC搭建低成本Homelab
显卡内存硬盘全线涨价,树莓派也不再便宜。本文介绍如何用约 115 美元的二手 Intel NUC 主板搭建低成本 Homelab,并手把手部署支持硬件转码的 Jellyfin 媒体服务器。
用 Firebase AI Logic 打造实时语音烹饪助手
详解如何用 Firebase AI Logic 结合 Gemini Live API 与函数调用,在 Android 应用中构建实时语音烹饪助手,涵盖权限声明、模型初始化、工具调用与 Firestore 数据落地及上线安全建议。
端侧AI实战:用离线模型打造无剧透读书问答App
Google开发者节目实录:如何用Firebase AI Logic混合推理,将读书问答App从云端Gemini改造为端侧离线AI。涵盖on-device模型下载、Firestore索引、Antigravity编程助手实战与真实debug踩坑经验。