免费模型端点:为什么需要契约测试台而非排行榜截图

用契约测试台而非排行榜,验证免费模型端点能否稳定返回代码所需的数据形状。
文章指出,免费模型端点在重复调用中会出现格式漂移、超时、token 计量异常等不稳定行为,而排行榜无法回答「这个端点能否反复返回我的代码需要的形状」。为此作者提出「契约测试台」方法:先定义 JSON、Schema、截断、token 计量、超时、错误契约和流式七类承诺,再用小型冻结的 JSONL 探针集、固定 temperature 与 max_tokens、每用例三次尝试、两个时间窗口和固定种子打乱顺序来运行,最后按失败分类报告计数而非复合分数。文章给出基于 Python 标准库的可改用模板和决策表,并强调免费报价是商业条款而非技术保证,免费端点不应作为需要 SLA 的生产依赖。
把一个小型内部工具接到免费模型端点上,第一次调用返回干净的 JSON,第二次把同样的对象裹在 Markdown 代码块里,第三次 30 秒超时,第四次对 40 个 token 的答案报告了 900 个 completion token。演示看起来仍然正常,但你的 CI 任务已经挂了。
这个落差正是免费端点需要「契约测试台」的原因。你问的不是这个模型是否最聪明,而是这个端点能否反复地、在你可承受的时间和 token 预算内,返回你代码需要的数据形状。这是两个不同的问题,只有第二个才能保护一次构建。
MonkeyCode 是一个开源项目,其当前推广宣传免费模型访问、免费服务器选项和 1000 万免费 token。这三项都应被视为有时限的商业条款而非技术保证——依赖它们之前请核实当前报价。本文作为 MonkeyCode 产品推广的一部分而准备。
在这个工作流里,免费访问更适合作为探针目标,而不是质量证明。即使换成另一个端点,下面的测试台依然有用。
先写契约,再写提示词
排行榜问的是哪个模型赢,契约测试台问的是哪些承诺能在重复中存活。从你的代码已经做出的承诺开始。
| 契约 | 探针 | 通过证据 | 失败分类 |
|---|---|---|---|
| JSON 对象 | 要求返回一个含两个键的对象 | 整个响应可解析,无需剥代码块 | format_drift |
| Schema | 固定键集和值 | 键完全匹配 | schema_miss |
| 截断 | 小 max_tokens 搭配长请求 | finish_reason 存在且合理 | truncation_ambiguity |
| Token 计量 | 已知短提示词 | 0 < completion_tokens <= max_tokens | accounting_anomaly |
| 超时 | 客户端强制超时 | 请求在预算内结束 | timeout |
| 错误契约 | 畸形请求 | 非 2xx 且响应体结构化 | error_contract |
| 流式(如使用) | 流式响应 | 最终事件到达 | stream_hang |
这张表刻意狭窄。它不测试推理、事实性或代码质量——那些需要另一套数据集。它测试的是:这个端点对某一个客户端来说,是否是一个稳定的依赖。
契约测试(contract testing) 源于微服务与 API 集成领域,指在不关心服务内部实现的前提下,验证「提供方」是否满足「消费方」所依赖的接口承诺。传统契约测试通常用 Pact 等工具在服务间比对请求/响应模式;在 LLM 场景中,被验证的承诺从 HTTP 状态码和字段类型,扩展到输出格式、token 计量、截断语义和流式终止等模型特有行为。与单元测试不同,契约测试刻意不追求覆盖率,而是锁定少数对调用方至关重要的形状约束,因此适合作为 CI 中的快速门槛。
finish_reason 是 OpenAI 兼容 chat-completions API 返回的字段,用于说明生成为何停止。常见取值包括 stop(命中停止序列或自然结束)、length(达到 max_tokens 上限被截断)、content_filter(被安全策略拦截)和 tool_calls(模型请求调用工具)。它是判断「截断」类契约的关键证据:若 finish_reason 为 length 而客户端仍把内容当作完整答案,就属于原文所说的 truncation_ambiguity。
构建小型、冻结的探针集
从四个用例开始,在做出团队决策前至少扩展到 20 个。形状比数量更重要。
使用四组用例:严格 JSON 抽取(含与不含代码块指令);截断压力(答案无法塞进 token 预算);Unicode 与空白(传输层会以出人意料的方式归一化文本);畸形请求对照(在主运行之外单独发送)。
把用例存为 JSONL,包含 id、group、prompt、expect 字段。对文件做哈希,把哈希写进笔记。如果 fixture 变了,旧数字就是另一个实验。不要把密钥、客户文本或生产提示词放进 fixture。免费服务可能记录请求,把每个探针都视为公开。
JSONL(JSON Lines) 是一种每行一个独立 JSON 对象的文本格式,便于流式读取、追加和逐行 diff。在测试台中,每个用例一行、字段包含 id、group、prompt、expect,使 fixture 可以被哈希、版本化和逐条审查。相比单个大 JSON 数组,JSONL 在部分写入或合并冲突时更容易定位问题,也便于把结果与 fixture 分开存放。
带控制地运行
控制是测试台与截图的区别所在。
- 端点接受时把
temperature设为 0;若被忽略,记录这一事实。 - 整个运行固定
max_tokens、客户端超时和客户端版本。 - 每个用例跑三次尝试,测量内部不重试,重试记为新的尝试。
- 在至少相隔两小时的两个窗口重复。免费容量不是平稳的。
- 用固定种子打乱用例顺序,别让一个慢请求毒化后续所有样本。
- 记录状态、延迟、用量、finish reason 和原始响应体哈希,不要记录 API key。
- 发送一个畸形请求。返回 200 是契约失败,而不是「有个性的成功」。
用 12 次尝试算出的 p95 延迟只是一个范围检查,不是 SLA 估计。这没关系,你要找的是失败分类和严重不稳定,而不是精确容量数字。
一个可改用的测试框架
下面的模板只用 Python 标准库。它是未执行的模板:假设 chat-completions 形状的 payload 和一个 BASE_URL。换 API 时替换 call_endpoint,保留记录形状和评分逻辑。
import hashlib
import json
import os
import random
import time
import urllib.error
import urllib.request
from pathlib import Path

BASE_URL = os.environ['BASE_URL'].rstrip('/')
API_KEY = os.environ['API_KEY']
MODEL = os.environ.get('MODEL', 'default')
TIMEOUT_S = 25.0
MAX_TOKENS = 64

CASES = [
    {'id': 'json-01', 'group': 'strict_json',
     'prompt': 'Return only a JSON object with keys ok and count. count must be 2.',
     'kind': 'json'},
    {'id': 'json-02', 'group': 'strict_json',
     'prompt': 'Return only a JSON object with keys ok and count. count must be 2. Do not use a code fence.',
     'kind': 'json'},
    {'id': 'long-01', 'group': 'truncation',
     'prompt': 'Write a 1000-word explanation of HTTP caching.', 'kind': 'text'},
    {'id': 'unicode-01', 'group': 'unicode',
     'prompt': 'Return the exact text: café / 第二行 / end', 'kind': 'text'},
]

# call_endpoint / score / main 与原文一致,此处省略完整实现
保存为 bench.py,用 BASE_URL='https://your-endpoint.example' API_KEY='...' python bench.py 运行。畸形请求对照单独跑:把 payload 改成非法 JSON,断言状态是 4xx 且响应体可解析,不要把那个结果并进通过计数。
读计数,而不是复合分数
单一分数会掩盖你真正需要修的那个失败。报告一组分开的数字:
| 指标 | 如何报告 | 为何重要 |
|---|---|---|
| 严格 JSON | 按组报 passed / attempts | 直接展示格式漂移 |
| 超时 | count / attempts | 暴露客户端与容量失败 |
| Token 异常 | count | 捕捉不可能的用量计量 |
| 延迟 | p50 与 p95,外加最大值 | 展示预算风险而不藏住离群值 |
| 错误契约 | valid 4xx / malformed requests | 展示失败是否机器可读 |
| 原始证据 | fixture 哈希与响应体哈希 | 让另一个人能复现这次运行 |
分母小时用计数。「9/12 严格 JSON 通过,3 次 format_drift」是有用的,「75% 质量」则不是。后一句话邀请了一个测试台无法支撑的比较。
p50 与 p95 延迟 是分位数指标:p50(中位数)表示一半请求快于该值,p95 表示 95% 的请求快于该值。相比均值,分位数更能暴露长尾——少数 30 秒超时会把均值拉高,却不会掩盖 p95 的恶化。原文强调用 12 次尝试算出的 p95 只是范围检查,因为 p95 在如此小的样本上本身就不稳定;它适合发现「严重不稳定」,而不适合当作容量 SLA。
为什么这些数字不是营销
营销数字压缩了时间、样本量和失败细节,只报告一个分数、一个日期、一个模型标签。它易读,也易被误用。契约测试台报告 fixture 哈希、客户端版本、分母、失败直方图和时间窗口。这些细节很无聊,但正是它们让另一个开发者能复现或证伪你的结果。
不要把测试台变成排名。如果你测两个端点,保持 fixture 和客户端固定,分开报告每个失败分类,并说明做了多少次尝试。如果免费报价变了,你的旧数字是一个历史观察,而不是当前能力声明。这就是证据与截图的区别:截图展示一个好时刻,测试台展示那个时刻发生的条件。
决策表
| 工作负载 | 最低证据 | 何时不要用免费端点 |
|---|---|---|
| 一次性原型 | 12 次尝试、畸形对照、分类失败 | 按当前条款不能发送该数据 |
| CI 任务 | 两个窗口 30+ 次尝试、p95 低于任务超时、回退路径 | 超时会阻塞每次合并 |
| 内部工具 | 契约通过计数加错误预算监控 | 你需要硬性延迟承诺 |
| 生产依赖 | 契约测试台加回退、监控和数据政策 | 你需要免费报价不提供的 SLA |
这张表是门槛,不是保证。通过意味着这个端点值得再测一次,不意味着模型正确。
局限与谁该跳过
这个测试台不测量推理质量、事实性或代码正确性,不会告诉你哪个模型写出更好的补丁——那需要单独的评估。样本很小,12 或 30 次尝试能揭示严重不稳定,但无法证明稳态容量。免费报价也有时限,1000 万 token 和免费服务器选项是商业条款而非协议保证,可能无通知变更。
除非当前条款明确允许,不要把密钥、受监管数据或客户内容发到免费端点。不要把此工作流当作唯一的生产控制。需要确定性延迟、严格数据驻留或合同 SLA 的团队,不应把免费端点当作生产依赖。
免费服务器适合放在哪里
把免费服务器选项当作一次性探针运行器:fixture、结果 JSONL 和摘要存在你自己控制的存储里。如果服务器重置,你损失的应是一次运行,而不是证据。运行期注入 API key,别放进 fixture、仓库或结果日志。把运行器当牲口,别当数据库。
有用的输出不是关于某个模型的口号,而是这样一句话:在 fixture 哈希 abc123、客户端版本 0.4.1 下,两个窗口内 12 次严格 JSON 尝试中 7 次通过、5 次以格式漂移失败。这句话能活过演示、交接和一位怀疑的评审者。
如果想找一个低风险的起点,项目当前的免费访问和免费服务器报价足够跑一次。核实当前条款,保留原始计数,让测试台决定下一步。
相关推荐
OpenAI新模型Bel曝光:10万亿参数,或成AGI基座
Reddit爆料称OpenAI新模型Bel即将问世,总参数超10万亿,或作为GPT-6之后的基础模型甚至AGI门槛基座。本文拆解爆料关键信息并评估可信度。
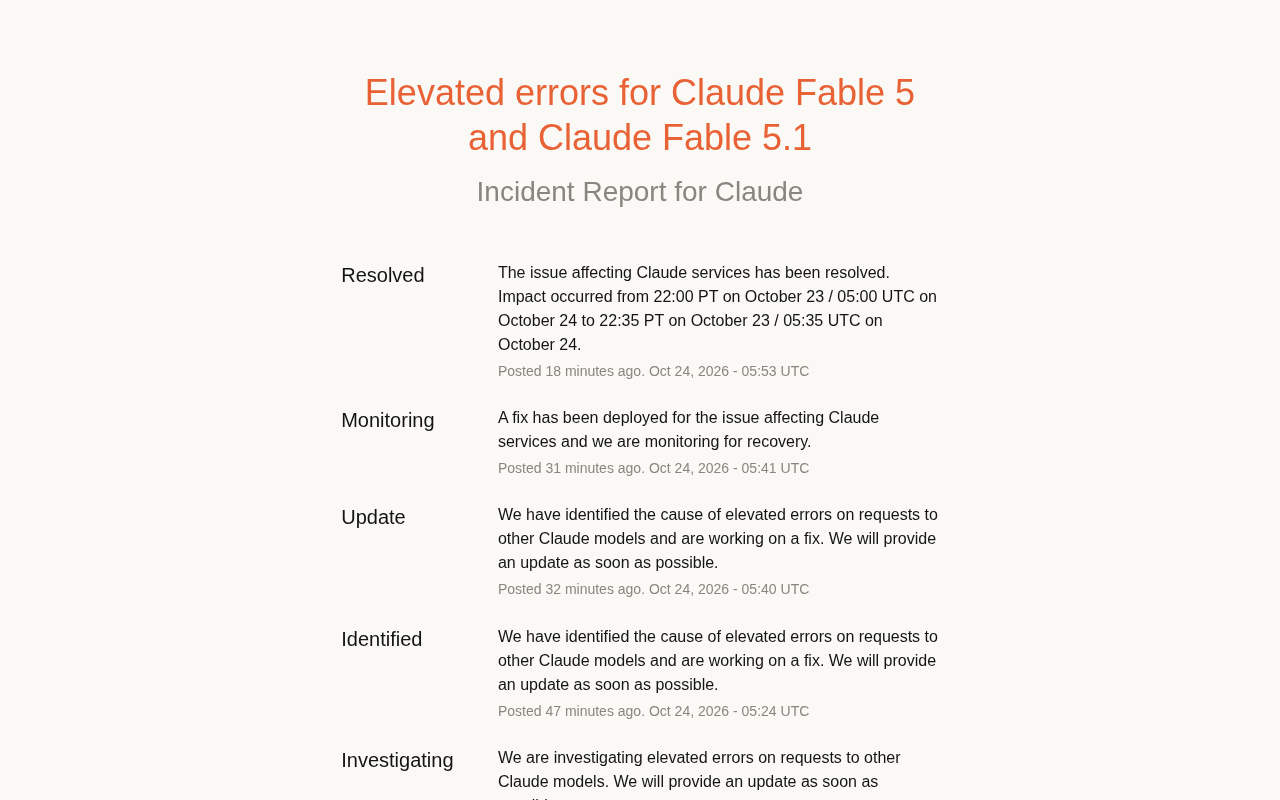
Claude Fable 5/5.1报错事件:30分钟故障复盘
Claude Fable 5与Fable 5.1出现错误率升高的服务故障,官方状态页显示影响约35分钟,从Investigating到Resolved仅用37分钟。本文还原故障时间线,分析对其他Claude模型的波及范围,并给出开发者重试、多模型路由与监控告警的应对建议。
Kimi K3.1开源模型实测:3万亿参数挑战闭源巨头
Kimi K3.1 开源权重模型深度实测:3万亿参数MoE架构、100万token上下文,3D渲染惊艳但空间推理与事实准确性存短板。基准逼近Opus 5.5,每任务成本仅2.11美元,开源前沿的真实水位全解析。