Milvus 2.6 实战:从向量原理到高性能 RAG 问答

B站技术课系统讲解 Milvus 2.6 架构、部署方式与高性能 RAG 实战优化要点。
文章基于 B 站一节技术公开课,围绕 Milvus 2.6 与高性能 RAG 实战展开。首先说明向量数据库在 RAG 中的基础设施地位,类比 MySQL 之于 Java 开发,用于解决海量高维向量的毫秒级相似度检索。随后梳理向量、向量化、余弦相似度、Embedding 等核心概念,并解析 Milvus 2.6 的云原生架构:Stream、Query、Data 节点与 Coordinate 协调器实现存算分离,依赖 ETCD、Kafka/Pulsar 与对象存储。部署方面介绍了 Python 轻量版与单机部署的硬件门槛。最后指出高性能 RAG 需关注分层存储、驱逐策略、预热与索引优化,并给出从 Java 架构转向 AI 架构的由底向上学习路径。
在 AI 大模型应用落地的过程中,向量数据库正扮演着越来越关键的角色。如果把大模型比作 Java 开发中的业务代码,那么向量数据库就像 MySQL——它是整个智能问答系统离不开的基础设施。来自 B 站的一节技术公开课上,拥有超过 13 年 Java 开发经验的讲师围绕 Milvus 2.6 版本与高性能 RAG 实战展开了系统讲解,内容涵盖向量原理、架构选型、部署方式以及面试与项目中的关键难点。
为什么 RAG 项目绕不开向量数据库
传统关系型数据库如 MySQL 擅长精确匹配和范围查询,最多再加上 LIKE 模糊匹配。但面对海量图片、文档或语义文本时,这类查询方式几乎失效。向量数据库要解决的是相似度检索问题:在几十亿条高维向量中,以毫秒级速度找到与目标最接近的那一条。
讲师用一个形象的例子说明了这种能力:给你一大堆图片,并告诉你其中有一张猫的图片,要求你在极短时间内从数十亿张图片中把它找出来。这正是 Milvus 这类向量数据库为高维向量检索而生的原因,也是 RAG 系统能够先检索、再生成的基础。
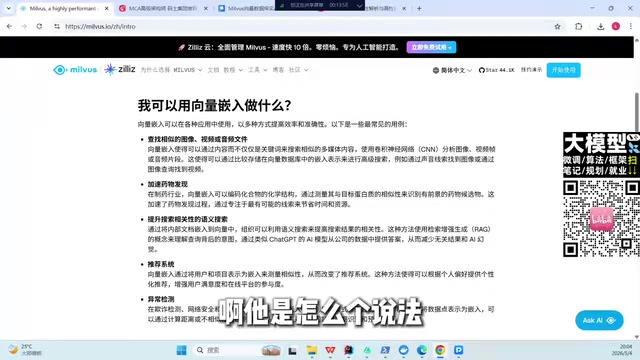
在同类产品中,Milvus 被官方定义为全球最受欢迎的开源向量数据库,这一点从其在 GitHub 上大几万的 star 热度也能得到印证。对于开发者来说,选择开源方案意味着更低的成本和更深入理解原理的空间,而深入学习 Milvus 的架构与调优,也是走向 AI 架构岗位的必经之路。
RAG(Retrieval-Augmented Generation,检索增强生成) 是一种将信息检索与大模型生成相结合的技术架构。其基本流程是:用户提问后,系统先将问题向量化,在向量数据库中检索出最相关的若干知识片段,再把这些片段作为上下文与问题一起送入大模型,由模型基于真实资料组织答案。相比直接让大模型“凭记忆”回答,RAG 能显著降低幻觉、支持私有知识库更新,且无需重新训练模型。因此,向量数据库承担的是“外挂长期记忆”的角色,其检索质量直接决定最终回答的上限。
Embedding(嵌入) 是向量化的一种具体形式,指通过预训练模型(如 BGE、OpenAI Embedding 等)把文本映射为固定维度的稠密向量,使语义相近的内容在向量空间中距离更近。Embedding 模型的选择、维度大小与是否归一化,都会影响后续相似度检索的召回效果,是 RAG 工程中需要与向量数据库协同调优的关键环节。
向量检索的核心概念
要真正用好 Milvus,必须先理解几个关键概念:什么是向量、什么是向量化、什么是余弦相似度、什么是向量存储,以及 RAG 项目中的 Embedding 与向量存储如何配合。
简单来说,向量化就是把文本、图片等非结构化数据转换成高维数值数组,而相似度计算则通过余弦相似度等度量方式判断两个向量在语义上的接近程度。RAG 系统正是利用这一机制,先从知识库中检索出与用户问题语义最相关的片段,再交给大模型生成答案,从而显著降低幻觉、提升回答的准确性。
理解这些原理之后,才能进一步讨论分层存储、驱逐策略、预热等进阶话题。这些概念在面试和实际项目中都属于容易被追问的难点,也是区分“会用”和“用好”的分水岭。
余弦相似度 通过计算两个向量夹角的余弦值来衡量方向上的接近程度,取值范围为 -1 到 1,值越接近 1 表示语义越相似。它对向量长度不敏感,适合衡量文本语义的相似性;与之并列的还有欧氏距离(L2)和内积(IP),不同度量方式适用于不同场景,Milvus 在创建集合时需要显式指定度量类型,且索引类型需与度量方式匹配。
高维向量检索 面临“维度灾难”问题:精确的暴力扫描在十亿级数据下无法满足毫秒级响应,因此实际系统普遍采用近似最近邻(ANN)算法,如 IVF、HNSW、DiskANN 等。这些索引以少量召回精度换取数量级的速度提升,也是后文讨论索引优化与预热机制的技术前提。
Milvus 2.6 的云原生架构
为什么选择 2.6 版本而不是旧版本?答案藏在它的架构演进里。Milvus 2.6 采用完全云原生的设计,可以清晰看到多种节点角色:Stream 流式节点、Query 查询节点、Data 数据节点,以及负责整体协调的 Coordinate 协调器。不同操作会路由到不同节点处理,从而实现存算分离与弹性扩展。
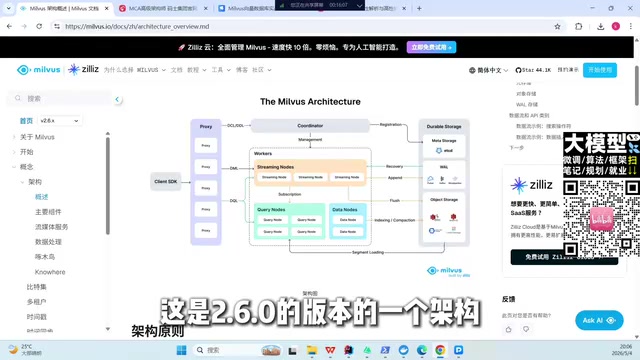
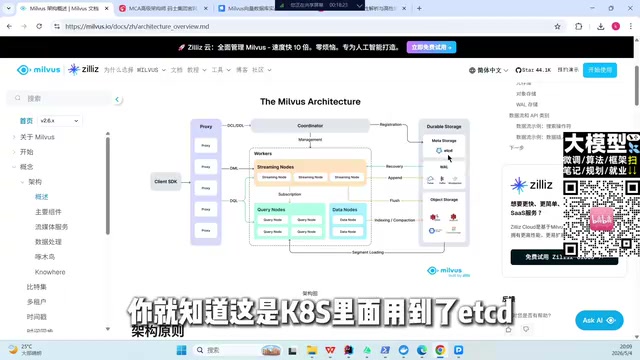
在依赖组件方面,Milvus 集成了 ETCD 做元数据管理,使用 Kafka、Pulsar 等消息中间件处理日志流,对象存储则支持亚马逊对象存储、MinIO 以及各类云存储。这种设计让它既能单机部署,也能平滑扩展到云端,覆盖从个人实验到企业级生产的多种场景。
值得一提的是 Milvus 与商业版 Zilliz 的关系。可以把 Milvus 理解为 Linux 系统,而 Zilliz Cloud 则是基于 Milvus 构建的商业在线云服务,类似红帽与 CentOS 的关系。商业版免去了运维的麻烦,速度也更快,但开源版本对于个人开发者和自建团队来说已经足够。
存算分离 是 Milvus 2.x 架构的核心设计原则:数据持久化在对象存储中,而 Query、Data、Stream 等节点只负责计算与调度,彼此通过消息队列传递日志流。这样做的直接好处是各类型节点可以独立扩缩容——查询压力大就扩 Query 节点,写入量大就扩 Data 节点,而无需整体迁移数据。
ETCD 在 Milvus 中承担元数据管理与服务发现职责,保存集合 schema、节点状态、协调器选主等信息;消息中间件(Kafka/Pulsar 或轻量版使用的 Woodpecker)则保证日志流的持久化与多消费者订阅。理解这两类依赖组件,有助于在部署排障时快速定位问题出在元数据层还是消息层。
从轻量到单机的部署路径
Milvus 提供了多种上手方式。最简单的是 Python 轻量版:直接安装 pymilvus 库,在 Python 代码中启动本地实例,然后创建 Milvus 客户端连接即可,适合快速验证想法和学习原理。
如果需要更接近生产的体验,可以选择单机部署。需要注意的是,单机版对硬件有一定要求:内存推荐至少 8G,CPU 建议英特尔第二代酷睿或更高版本,并支持相应指令集,硬盘则强烈建议使用固态硬盘。讲师特别强调,非固态硬盘基本跑不好 Milvus,这一点在选型时容易被忽略。
高性能 RAG 需要关注哪些优化点
搭建一个能跑的 RAG 问答系统并不难,难的是让它高性能、可维护。课程中提到,结合 Milvus 做 RAG 系统时,需要重点优化水位线、预热字段与索引等环节。分层存储与驱逐策略决定了数据在不同存储层之间的流转效率,而预热机制则影响查询的响应速度。
这些优化点并非孤立存在,而是与 Milvus 的架构设计紧密相关。只有理解了 Stream、Query、Data 各节点的职责,才能判断瓶颈出在哪里,进而有针对性地调整参数与索引策略。
分层存储 指 Milvus 将数据按热度分为内存中的热数据与对象存储中的冷数据,查询时按需加载;驱逐策略 则决定何时把冷数据从内存中换出,以控制内存占用。二者配合可在保证查询性能的同时大幅降低硬件成本。
预热(Warm-up) 是指对新建或刚加载的索引提前触发加载与缓存,避免首个查询因冷启动而出现高延迟。结合水位线(Watermark)监控,可以判断写入与索引构建是否滞后,从而在数据持续写入的 RAG 场景中维持稳定的检索响应。这些机制共同构成了向量数据库从“能跑”到“跑得好”的关键调优手段。
AI 大模型热潮下的能力布局
在谈到就业市场时,讲师给出了一组方向性判断:大模型持续火热,但想找到相关工作,需要补齐多智能体、RAG 优化、模型微调与核心算法等能力。向量数据库作为基础设施,是这些能力中的第一块基石。
从 Java 架构转型到 AI 架构,路径其实有迹可循:先掌握像 Milvus 这样的基础组件,再深入 RAG 系统的优化与工程实践,最后向上延伸到多智能体与模型微调。这种由底向上的学习路线,比盲目追逐热点更容易形成竞争力。
对于开发者而言,Milvus 2.6 不只是一个新版本号,它代表了向量数据库在云原生方向上的成熟,也意味着 RAG 应用有了更稳固的底座。理解向量原理、吃透架构细节、动手跑通一个问答项目,是当前阶段最务实的三步。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。