MiniCPM5-2B实测:2B小模型跑出SWE-bench 46.4分
OpenBMB开源的MiniCPM5-2B以20亿参数实现SWE-bench 46.4分,可本地离线运行且免费商用。
OpenBMB推出的MiniCPM5-2B是一款仅有20亿参数的端侧大模型,在代码修复基准SWE-bench上取得46.4分,不仅在2B量级断层领先,甚至超越多款4B模型。其能力来源于强化学习结合OPD蒸馏的训练路线——将16个专家模型(含5个agent专家)的能力浓缩进单一小模型,并同步开源约50万条agent训练数据和8万余条强化学习样本。模型采用LLaMA结构,可通过llama.cpp在个人电脑上离线运行,无需API密钥,数据不经任何云端,许可协议为Apache 2.0可免费商用。这一组合预示着AI算力重心正从云端向端侧终端迁移,"开源、免费、本地、SOTA"首次在同一模型上同时成立。
一个只有20亿参数的模型,正在改写端侧AI的能力上限。OpenBMB推出的MiniCPM5-2B在SWE-bench上拿下46.4分,不仅压过了同级别的2B模型,甚至击败了参数量是它两倍的4B级对手。更关键的是,它开源、免费、可商用,还能直接在个人电脑上离线运行。
2B参数为何能打过更大的模型
MiniCPM5-2B的核心卖点,是用极小的参数量撬动了远超预期的性能。据B站UP主的实测介绍,这个模型在SWE-bench(一个衡量代码修复真实能力的基准)上取得46.4分,这个成绩放在2B量级里几乎是断层领先,甚至能与4B级模型正面对抗。
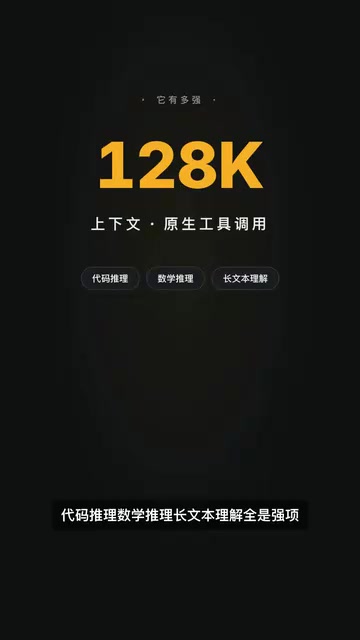
它的能力覆盖面并不窄:128K原生上下文、工具调用、代码推理、数学推理、长文本理解,这些通常被认为是大模型才具备的特性,都被压缩进了这个小身体里。
对于习惯了「参数越大越强」直觉的用户来说,这种表现有些反常。但它背后其实是一套明确的工程思路——用训练方法弥补参数规模的不足。
SWE-bench是一个由普林斯顿大学提出的代码能力评测基准,它从GitHub上真实的软件仓库中抽取issue,要求模型根据问题描述自动生成代码补丁来修复bug。与简单的代码补全题目不同,SWE-bench考察的是模型理解真实工程上下文、定位代码库中相关文件、并输出可通过测试的完整修复方案的综合能力。正因为任务场景贴近实际工程,业界普遍把SWE-bench分数视为衡量"编程Agent实用性"的重要参考,而非单纯的代码生成指标。46.4分意味着模型能够成功修复接近一半的真实软件缺陷,这在2B量级上极为罕见。
能力从何而来:专家蒸馏加强化学习
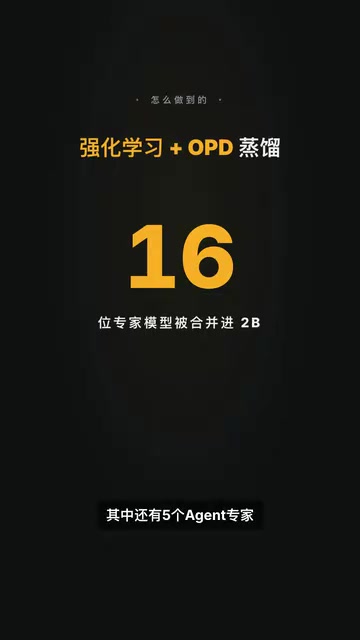
MiniCPM5-2B的实现路径值得拆解。OpenBMB采用了强化学习结合OPD(模型能力迁移/蒸馏)的方式,把16个专家模型的能力汇流合并进这一个2B模型中,其中还包含5个专门的agent专家。
换句话说,这个小模型并不是从零训练出全部能力,而是通过蒸馏与强化学习,把多个专精模型的长处「浓缩」到一起。这也解释了为什么它能在代码、数学、工具调用等多个方向同时表现出色。
更难得的是训练数据的开放程度。据介绍,这次连训练数据都一并开源,包括约50万条agent样本和8万多条强化学习样本。对研究者和复现者而言,数据开源比模型权重开源意义更大,它意味着这套方法论具备被验证和迭代的可能。
知识蒸馏(Knowledge Distillation)是一种将大模型(教师模型)的能力迁移到小模型(学生模型)的训练技术,最早由Hinton等人在2015年系统化提出。传统蒸馏通常是一对一的——一个大教师指导一个小学生。MiniCPM5-2B采用的OPD(Omni-domain Policy Distillation,全域策略蒸馏)则更为激进:同时引入16个在不同领域各有专精的教师模型,让小模型在单次训练中融合多条能力主线。强化学习部分则通过奖励信号让模型在工具调用、多步推理等任务上持续自我优化。两者结合,使得最终模型的"实际能力密度"——即单位参数能完成的任务范围——显著高于同等参数量的普通训练模型。
本地部署:无需API密钥,数据不出本机
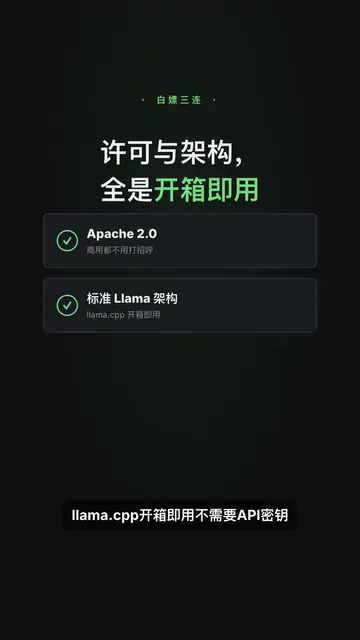
真正让MiniCPM5-2B具备实用价值的,是它的部署门槛。模型采用标准的LLaMA结构,可以通过llama.cpp开箱即用,不需要API密钥,也不需要联网——你自己的电脑就是它的运行环境。
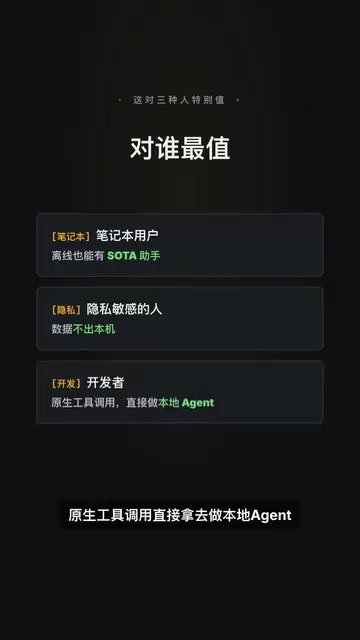
这套组合对三类人群格外友好:
- 笔记本用户:即便离线,也能拥有一个接近SOTA水平的本地助手;
- 隐私敏感用户:所有数据都在本机处理,不上传任何云端;
- 开发者:原生的工具调用能力,可以直接拿去搭建本地agent应用。
许可协议是Apache 2.0,商用无需额外申请,这在开源模型里属于最宽松的一档。
llama.cpp是由Georgi Gerganov开发的开源推理框架,专为在CPU和消费级GPU上高效运行大语言模型而设计。它的核心技术是量化压缩:将模型权重从32位或16位浮点数压缩为4位甚至更低精度的整数,在显著降低内存占用的同时,尽量保留模型的推理质量。以MiniCPM5-2B为例,原始模型权重约4GB,经Q4量化后可压缩至1.5GB左右,普通笔记本电脑的内存完全可以承载,无需独立显卡。LLaMA结构的兼容性则保证了模型可以直接被llama.cpp识别和加载,无需额外的格式转换,这也是OpenBMB选择该架构的重要工程考量。
端侧AI的信号意义
比模型本身更值得关注的,是它释放出的趋势信号。当一个2B模型能够胜任过去需要8B模型才能完成的任务,AI的算力重心正在从云端机房,逐步向每个人的终端设备迁移。
「开源、免费、本地、SOTA」这四个词过去很难同时成立,而MiniCPM5-2B让它们第一次真正落在了同一个模型上。这意味着端侧AI不再只是「阉割版云端模型」的代名词,而是可以承载严肃生产任务的独立方案。
当然,这类小模型仍有边界。46.4分的SWE-bench成绩虽然亮眼,但与顶级云端大模型相比仍有差距,复杂长链条推理、超大规模知识问答等场景,本地小模型未必能完全替代云端。它的价值更多在于「够用、私密、随身」,而非「全面超越」。
如何上手
对想尝鲜的用户,路径很简单:到ModelScope上把模型拉下来,配合llama.cpp即可在本地跑起来。整个过程不涉及联网和密钥配置,适合快速验证。
对开发者来说,更有想象空间的是它的原生工具调用能力——这为搭建完全本地化、数据不出机的AI agent提供了现成基座。随着这类模型能力持续提升,本地agent很可能成为下一个值得投入的方向。
相关推荐
Cursor 3.0 完整入门指南:从零上手 AI 编程 IDE
Cursor 3.0 完整入门教程:从下载安装、创建项目到并行子代理、云端开发、技能与自动化等高级功能。零基础也能上手这款 AI 编程 IDE,掌握模型选择、设计模式与 Git 版本控制的实用技巧。
Codex+Playwright封装测试Skill:UI自动化不再手敲命令
把 Playwright 封装成 Codex Skill,让 AI Agent 通过自然语言完成 UI 自动化测试。本文详解安装加载、Sauce Demo 实战、PO 分层模板,以及 MCP 与 CLI+Skill 的选型对照。
用Obsidian+AI智能体复刻2999元「得到大脑」全功能
用免费的Obsidian笔记软件搭配AI智能体,如何复刻年费2999元的得到大脑专家版?本文拆解发芽、点评、拷问、风格打磨、审稿、排版等核心功能的skills实现逻辑,助你搭建数据本地化、自由扩展的个人AI知识管理系统。