模型挤牙膏时代,AI平台才是真正的生产力变量

模型升级的边际效应正在递减
Opus 4.8 发布后,社交媒体上又掀起一波"模型大战升级"的讨论热潮。但冷静下来想一个问题:从 4.6 到 4.7 再到 4.8,普通用户真的能感受到生产力的显著跃升吗?
答案恐怕是——很难。
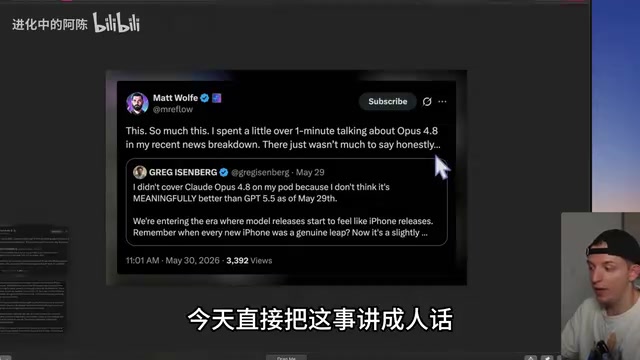
正如B站UP主阿晨所指出的,模型当然在进步,但这种进步对终端用户的体感已经越来越弱。这就像智能手机从 iPhone 14 到 iPhone 15,芯片跑分确实更高了,但你日常刷视频、发消息的体验几乎没有区别。AI 模型正在进入类似的"挤牙膏"阶段——纸面参数在涨,但用户的实际生产力增益却趋于平缓。
从技术角度看,这种现象有其深层原因。边际效应递减是经济学中的经典概念,在AI领域表现为:当模型参数量从千亿级向万亿级攀升时,每增加一个数量级的计算资源,带来的性能提升幅度却在缩小。这种现象在学术界被称为Scaling Law的"天花板效应"。OpenAI的研究员Ilya Sutskever早在2023年就暗示,单纯堆参数的路径可能正在接近物理极限。行业内部的共识是:从GPT-3到GPT-4的跃升是革命性的,但从GPT-4到后续版本的提升更多体现在特定任务的精细化而非通用能力的质变。
这意味着一个重要的行业拐点:往后真正拉开体验差距的,未必是谁家的模型更先进,而是谁能让用户少当"人肉监工"。
真干活时,稳定性比聊天体验重要100倍
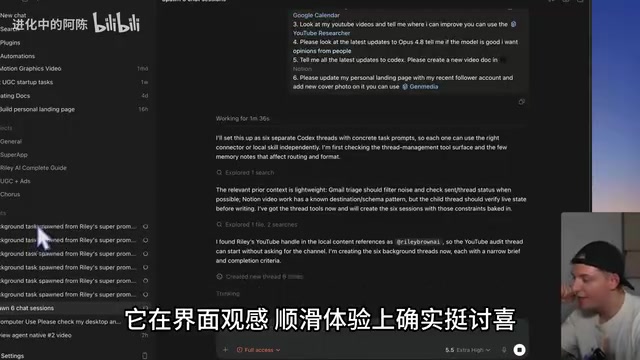
有一个判断特别犀利:有些任务你敢放心交给 GPT 5.5 去跑,但绝不会交给 Opus 4.8。
这不是说 Opus 4.8 一无是处。在界面观感、对话顺滑度上,它确实做得很讨喜。但一旦进入真实的工作场景——写代码、跑长任务、盯终端、查日志——这些真刀真枪的环节,稳定性和任务深度就比"好不好聊"重要太多了。
这揭示了当前 AI 工具评价体系中一个被忽视的维度:我们过于关注模型的"聪明程度",却忽略了在生产环境中,可靠性、一致性和任务完成度才是决定性因素。一个能稳定完成 80% 任务的系统,远比一个时灵时不灵的"天才"模型更有实用价值。这在软件工程中有个对应概念叫"五个九"(99.999%可用性),企业级系统宁可牺牲一部分峰值性能,也要确保服务的稳定可预测。AI工具正在面临同样的取舍。
Codex 的真正野心:重构整个工作流
这一轮最值得关注的变化,不在模型本身,而在 Codex 这类 AI Agent 平台的进化。
要理解这种进化的意义,需要先厘清AI Agent与传统聊天机器人的本质区别。AI Agent(智能体)是区别于传统聊天机器人的新范式。传统大模型是"问一答一"的被动响应模式,而Agent具备感知环境、制定计划、调用工具、执行动作的完整闭环能力。其核心技术栈通常包括:任务规划模块(将复杂目标拆解为子任务)、工具调用接口(连接外部API和应用)、记忆系统(维护长期上下文)以及反思机制(自我评估和纠错)。Codex作为Agent平台,本质上是在大语言模型之上构建了一整套任务执行引擎,使AI从"思考者"变为"执行者"。
Codex 的最新更新不再只是给你一个聊天框,而是把三样东西揉到了一起:
- 能自动干活的 AI 助手
- 内置浏览器
- 日常办公的操作区
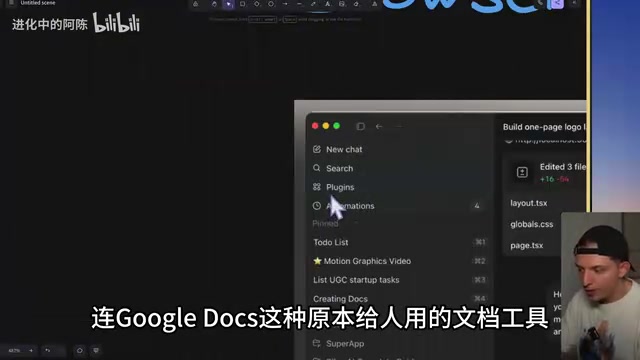
一个很有说服力的例子是:连 Google Docs 这种原本纯粹为人类设计的文档工具,底层都开始长出能自动执行任务的能力。这意味着应用本身可以直接与你的 AI 助手协同工作——你不再需要退出当前界面,手动把结果搬运到另一个工具里继续操作。
更进一步,Codex 这轮更新还包含了几项关键能力:
- 操控 Windows 电脑:AI 可以直接在你的桌面环境中执行操作
- 跨设备协同:手机可以遥控同一个工作区继续任务
- 任务并行拆解:大任务自动拆分成多条线同时执行
这些能力单看都像小补丁,但合在一起就是一次工作流重构——它等于把一整段"人工接力"直接从流程中抠掉了。
低代码平台的尴尬处境
当 Codex 这类平台能力持续增强,最先感受到压力的会是谁?
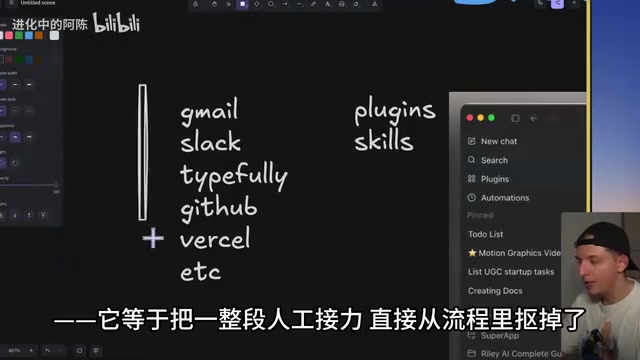
答案是 Appable、Lovable 这类帮你"一键做应用"的低代码平台。低代码/无代码平台在2020-2023年间经历了高速增长期,Gartner曾预测到2025年70%的新应用将使用低代码技术开发。这类平台的核心价值在于将编程抽象为可视化拖拽操作,让非技术人员也能构建应用。然而,这些平台的商业模式建立在"技术门槛差"之上——当AI Agent能直接用自然语言生成并部署应用时,这个门槛差就被大幅压缩了。
它们面临的尴尬在于:
- 以前,用户为整套外壳和打包服务付费,这是合理的价值交换
- 现在,越来越多的任务在 Codex 里一句指令就能跑起来
- 更要命的是,OpenAI 还在补贴自家模型调用,这些平台的成本优势正在被一点点蚕食
这并不意味着低代码平台会立刻消亡,但它们必须重新思考自己的价值定位。如果核心卖点只是"降低使用门槛"和"打包部署",那么当 AI Agent 平台把这些能力内化之后,留给中间层的生存空间会越来越窄。这类似于当年网页模板公司在WordPress生态成熟后面临的生存困境——平台一旦吞噬了中间层的核心功能,中间层要么向上走做更深的垂直场景,要么就会被逐步边缘化。
真正昂贵的不是模型,而是人工损耗
回到最核心的判断:这一轮 AI 竞争中,最贵的损耗往往出在人工搬运、人工兜底、人工纠错上,根本不在模型那一点点纸面差距。
想想你日常使用 AI 工具的场景:
- 在不同窗口之间来回复制粘贴
- 手动检查 AI 输出的结果是否正确
- 自己盯着账单和报错信息
- 把一个工具的输出格式化后喂给另一个工具
这些"脏活"消耗的时间和精力,远超模型本身的能力差异带来的影响。谁先把这些人工环节拿走,谁就比"单纯更强一点的模型"值钱 100 倍。
写在最后
我们正在经历 AI 行业的一个关键转折:从"模型为王"到"平台为王"的范式转移。
这种范式转移在科技史上有清晰的先例。PC时代,CPU性能竞争(Intel vs AMD)最终让位于操作系统和生态之争——Windows凭借软件生态而非硬件参数确立了统治地位。移动时代,芯片跑分的重要性同样被iOS/Android的平台生态所覆盖——消费者选择手机时,App Store的丰富度往往比处理器型号更具决策权重。AI行业正在重演这一规律:当底层模型能力趋于同质化,上层的平台整合能力、开发者生态和用户工作流的深度绑定将成为新的竞争焦点。微软通过Copilot深度嵌入Office全家桶,就是这一趋势的典型案例。
这不是说模型不重要了,而是说模型能力的提升已经进入了收益递减的阶段。真正能改变用户体验的,是围绕模型构建的平台能力——任务编排、工具集成、自动化执行、跨设备协同。
对于普通用户而言,与其纠结于选择哪个模型,不如关注哪个平台能真正帮你减少"人肉监工"的时间。对于开发者和创业者而言,纯粹的模型包装已经不是好生意,构建不可替代的工作流整合能力才是护城河所在。
AI 的"iPhone 时刻"或许不在于某个模型的发布,而在于某个平台让你第一次真正感受到——AI 不只是在聊天,而是在替你干活。
相关推荐

Anthropic IPO文件解读:807亿亏损多为账面数字
Anthropic递交S-1文件启动IPO,半年营收163亿美元却净亏损807亿美元。本文拆解其中724亿美元公允价值变动、900%净收入留存率的统计口径,以及模型「敲诈」风险披露的真实来源。

Anthropic IPO投资指南:估值、风险与买入策略
Anthropic IPO深度解读:拆解S-1文件中的营收增速、算力成本、6200亿美元基础设施承诺与博通循环融资风险,用SVR估值法测算2万亿美元估值是否合理,并给出IPO买入纪律与风险清单。

Anthropic冲刺IPO:Claude如何赚钱,以及那个“坑”
Anthropic提交IPO文件,代码A-N-T。拆解Claude的商业模式:按token售卖智能、每美元算力收入从40美分升至2美元以上、Q2首个运营利润,以及长期算力承诺与按需收入之间的结构性风险。