n8n 自动化实战:自动化与 AI 智能体的本质区别
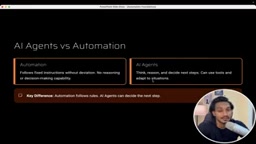
自动化遵循固定规则,AI 智能体能理解意图并自主决策,两者有本质区别。
本文基于 n8n 自动化课程内容,厘清了「自动化」与「AI 智能体」的核心差异:自动化只能按预设规则逐步执行,无推理能力;AI 智能体则借助大语言模型理解语境、做出判断并调用工具完成复杂任务。文章以客服退款邮件为例具体说明:纯自动化会机械触发退款流程,而 AI 智能体能读懂用户「想退款但又喜欢产品」的矛盾情绪,主动提供优惠方案、更新 CRM 并跟进后续,形成完整的智能服务链条。在 n8n 中,几乎任何节点都可接入 Gemini、GPT、Claude 等模型驱动智能体,赋予工作流真正的决策能力。理解这条分界线,是从搭建简单流程走向构建复杂智能系统的必要前提。
AI 智能体(AI Agent)正成为自动化领域最热门的话题之一。很多刚接触 n8n 这类工作流工具的人常把「自动化」和「AI 智能体」混为一谈,但两者在底层逻辑上有根本差异。这篇文章基于一门 n8n 自动化课程的讲解内容,梳理清楚它们各自的能力边界,并用一个真实的客服场景说明为什么在某些任务上必须引入 AI 智能体。
自动化与 AI 智能体的核心差异
用最简洁的话概括:自动化是「遵循规则」,AI 智能体是「做出决策」。
自动化的本质是执行预先设定好的固定指令。你规定一条工作流,它就一步步照做,没有推理能力,也没有决策空间。它能识别上下文中的关键词或结构化字段,但无法理解言外之意,更谈不上判断该走哪条路径——除非这条路径早就被写进了流程里。
AI 智能体则不同。它具备推理和决策能力,能够根据当前情境自主判断下一步该做什么。更关键的是,AI 智能体可以调用工具(tools)、适应变化的场景,而不是死板地执行一套脚本。这种灵活性正是它相对传统自动化最大的价值所在。
简单总结两者的分界线:
- 自动化:遵循规则,无推理、无决策,依赖固定指令
- AI 智能体:能理解上下文、做决策、调用工具、适应情境
一个客服退款场景说明问题
理论说起来抽象,课程里给出的例子很能说明问题。
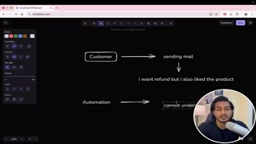
假设一位客户购买了产品后发邮件给公司,内容是:「我想退款,但其实我也挺喜欢这个产品。」这封邮件里藏着矛盾的情绪——既提出了退款诉求,又表达了对产品的认可。
如果用纯自动化来处理这封邮件会怎样?自动化系统无法理解「喜欢产品」这层情绪,它只会捕捉到「退款」这个关键信号。只要工作流里设定了退款流程,它就会机械地启动退款,完全忽略客户态度中可以挽回的部分。它处理的是上下文中的显性字段,而不是人的真实意图。
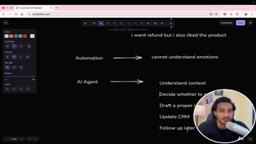
换成 AI 智能体,情况完全不同。它能读懂整段信息的完整语境——客户想退款,但同时喜欢这个产品。基于这个判断,智能体可以决定是否真的需要退款,并起草一封更得体的回复:既然你喜欢这个产品,不如保留它,我们可以给你一些优惠或其他补偿。
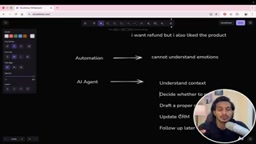
这还没完。AI 智能体处理完后,还能把这次交互的结果更新到 CRM 系统里,记录客户的反馈,并在之后主动跟进:退款是否到账、产品使用是否有问题。整个链条从理解、决策、回复到记录和后续跟进,都由智能体根据实际情况自主完成。
这个场景实际上触及了自然语言处理中一个经典难题:情感与意图的分离。传统的关键词匹配或规则引擎只能处理字面信号(如「退款」),而真实用户表达往往包含隐含意图、矛盾情绪乃至反讽语气。大语言模型通过在海量人类文本上预训练,习得了对语义和情感的整体理解能力,因此能够将「想退款」与「但我挺喜欢这个产品」视为需要综合权衡的两个信号,而非简单触发单一流程。在实际业务中,这种能力可以显著降低误处理率——不该退的款不退、该挽回的客户被挽回,直接影响企业的退款成本与用户留存率。
AI 智能体为何「聪明」
AI 智能体之所以能做到这些,是因为它在应用「智能」去理解正在发生的事情。它不是在匹配关键词,而是在理解意图、权衡选择、生成合适的行动。
在 n8n 这类工具里,构建 AI 智能体最强大的一点是:几乎任何环节都可以连接到 AI 模型。 无论是 Gemini、GPT、Claude,还是其他大量可选的 AI 模型,都能接入工作流来驱动智能体。这带来了极高的灵活性,也意味着你可以根据任务需求选择最合适的模型。
从技术层面看,AI 智能体的「聪明」来源于大语言模型(LLM)的推理能力与工具调用机制的结合。LLM 负责理解自然语言输入、生成推理链路并决定下一步行动;工具调用(Function Calling / Tool Use)则让模型能够在推理过程中主动触发外部操作,例如查询数据库、调用 API、发送邮件或更新 CRM 记录。这种「感知→推理→行动」的循环在技术文献中通常被称为 ReAct(Reasoning + Acting)范式。在 n8n 的实现里,每一个可被智能体调用的外部能力都被封装成「工具节点」,智能体根据当前对话上下文自行决定是否调用、调用哪个、传入什么参数——这正是它与传统自动化「由人提前规定每一步」的根本区别。
从理论到实践的衔接
需要提醒的是,以上这些都还停留在概念层面。真正把这样的工作流搭建出来时,事情会变得「认真」起来——你会开始构建相当复杂的流程。要真正掌握自动化与 AI 智能体的差异,必须动手把它实现一遍。
但在那之前,这些基础概念是绕不开的前提。当你落地实现时,脑子里得清楚每一步到底意味着什么:什么时候用固定规则的自动化就够了,什么时候必须引入能做决策的 AI 智能体。理解了这条分界线,后续构建复杂工作流时才不会迷失方向。
这是整套 n8n 学习路径中必须掌握的基本功,也是从「跑通一个简单流程」走向「构建真正智能系统」的分水岭。
相关推荐

Heretic 2.0 发布:从去审查到通用模型修改工具
Heretic 2.0 正式发布,新增任意秩消融(ARA)算法与插件系统,从去审查专用工具进化为可抑制废话、降低谄媚、调整情感对齐的通用模型修改平台。37k GitHub 星标,Hugging Face 衍生模型超 8500 个。
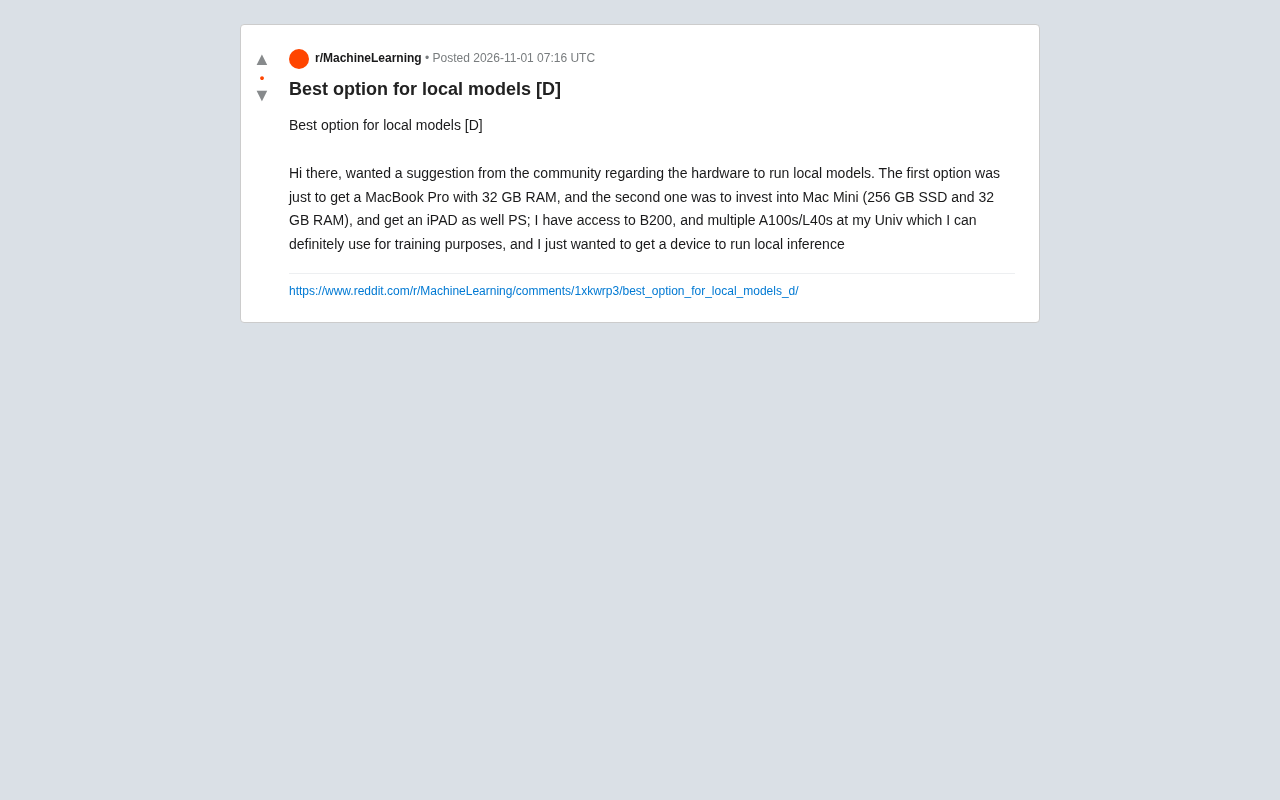
本地大模型硬件怎么选?MacBook Pro vs Mac Mini+iPad深度对比
Reddit社区热议本地大模型硬件选择:32GB MacBook Pro与Mac Mini+iPad组合如何取舍?本文从便携性、性价比、内存需求等角度深度分析,帮你找到最适合本地推理的设备方案。

AI Agent失败溯源:如何定位错误决策的根因?
Reddit讨论聚焦AI Agent失败溯源难题:如何定位导致Agent做出错误决策的根因?分析LangSmith、LangFuse等可观测性工具的局限,探讨手动分析与自建分析系统的实践组合,为Agent可靠性提升提供思路。