Ollama v0.35.1-rc0 更新:模型能力声明机制详解

Ollama v0.35.1-rc0 引入显式能力声明机制,以明确的能力契约取代脆弱的架构元数据推断,并为 MLX 运行时支持铺路。
Ollama v0.35.1-rc0 的核心改动是在 Modelfile 中引入 CAPABILITY 显式声明字段,让模型主动标注自身支持的功能特性,取代此前依赖架构名称和渲染器元数据进行启发式推断的做法。这一机制在 GGUF、safetensors 创建、模型继承及 Modelfile 导出等全流程中完整保留,确保能力信息端到端一致。调度层面,System One 请求的处理从模糊的架构匹配改为要求模型显式具备 decision 能力,提升了运行时行为的可预测性。本次版本还有意保留了 GGUF-only 的评分限制,为后续 MLX 原生运行时的整合预留接口,体现了拆分推进、逐步稳定的工程节奏。该版本为 rc0 预览版,面向测试用户,生产环境建议等待正式稳定版。
Ollama 发布了 v0.35.1-rc0 预览版本,核心变化围绕 PR #18708 展开——为模型创建流程引入了显式的能力声明(explicit model capabilities)机制。这项改动看似是一个底层工程细节,但对于本地大模型运行生态而言,它关系到调度逻辑的准确性与模型元数据管理的规范化。
本次更新的核心变化
这个版本的主线改动可以概括为一句话:让模型自己声明它具备哪些能力,而不是靠框架去猜测。
具体来说,更新为 Modelfile 增加了 CAPABILITY 声明字段,同时在 create 请求中加入了可追加(additive)的 capabilities 字段。这意味着开发者在构建模型时,可以明确标注该模型支持哪些功能特性,而不再依赖框架通过架构元数据去反向推断。
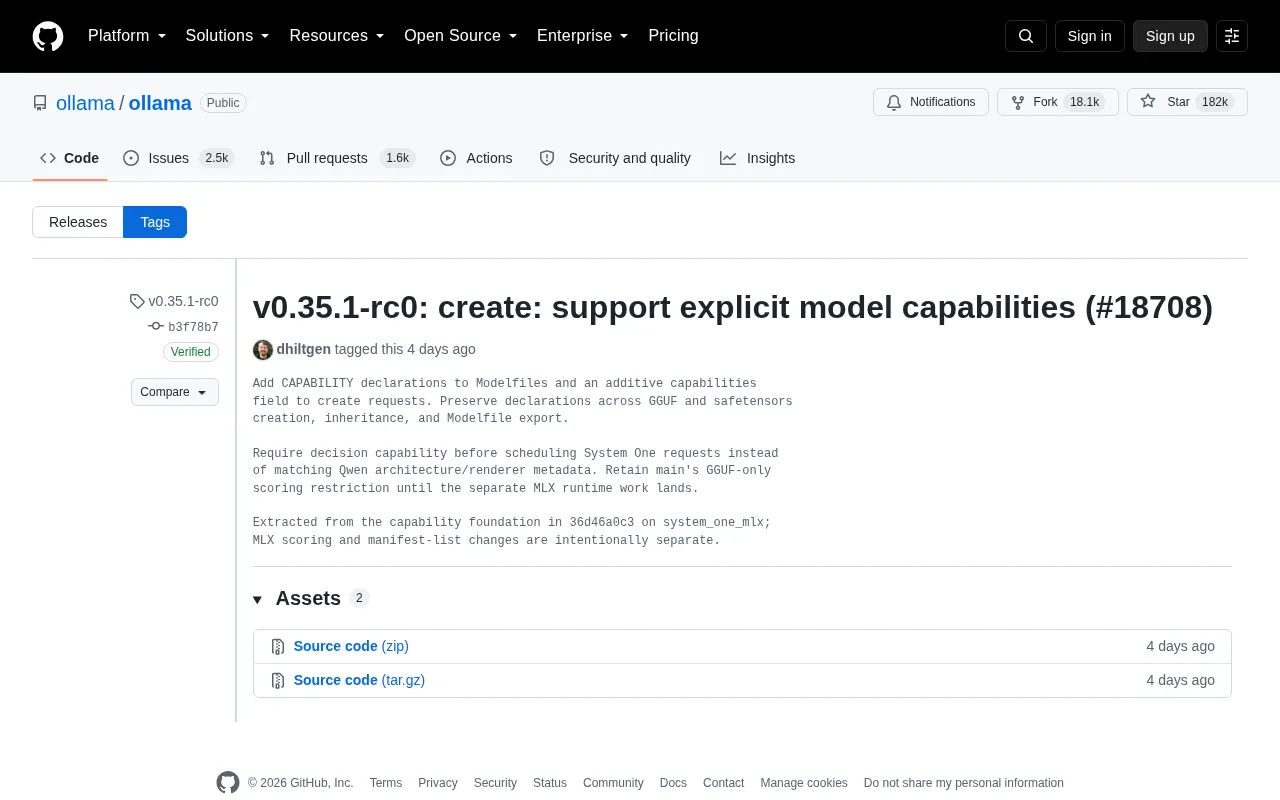
更重要的是,这些能力声明会在多个环节被完整保留:无论是 GGUF 还是 safetensors 格式的模型创建、模型继承(inheritance),还是 Modelfile 的导出过程,声明信息都不会丢失。这种端到端的一致性对于模型分发和复用场景至关重要。
为什么要用显式声明替代元数据匹配
在此前的实现中,Ollama 判断一个模型是否具备某种能力,往往要依赖对模型架构或渲染器元数据的匹配。更新说明里特别提到一个典型场景:调度 System One 请求时,原先是通过匹配 Qwen 架构及其 renderer 元数据来决策的。
这种做法的问题在于脆弱且不够通用。架构名称、渲染器标识这类隐式信号本质上是启发式的猜测,一旦出现新架构或变体,匹配逻辑就可能失效或产生误判。
新版本改为要求模型必须显式具备 decision 能力,才能被调度去处理 System One 请求。换句话说,调度决策从"模糊的架构识别"转向"明确的能力契约"。这对运行时行为的可预测性是一次实打实的提升。
GGUF(GPT-Generated Unified Format)是 llama.cpp 项目定义的模型文件格式,将模型权重与架构元数据打包在单一文件中;safetensors 则是 Hugging Face 推出的安全张量存储格式,侧重安全性与加载速度。两种格式在元数据字段的定义上并不统一,这正是此前基于"架构识别"进行能力推断容易出错的根本原因——同一种能力在不同格式的元数据中可能有不同的字段名或根本不存在对应字段。显式 CAPABILITY 声明将能力描述从格式层抽离出来,成为独立于底层存储格式的语义契约,从而消除了跨格式匹配时的歧义。
渐进式演进与 MLX 的伏笔
值得关注的是这次改动的节奏感。发布说明明确表示,本次仍保留了 main 分支中针对 GGUF-only 的评分(scoring)限制,直到独立的 MLX 运行时工作落地之后再做调整。
从提交记录看,这部分能力基础其实是从 system_one_mlx 分支上的 36d46a0c3 提交中提取出来的,而 MLX 评分逻辑与 manifest-list 相关的改动则被有意拆分出去单独推进。
这种拆分策略体现了成熟的工程治理思路:先把通用的能力声明机制稳定下来,为后续的 MLX 运行时支持铺好地基,避免一次性引入过多耦合改动。对于关注 Apple Silicon 本地推理的用户而言,这也是一个明确的信号——MLX 运行时的原生支持正在路上。
MLX 是苹果公司开源的机器学习框架,专为 Apple Silicon(M 系列芯片)设计,底层充分利用了统一内存架构(Unified Memory Architecture)的特性,使 CPU 与 GPU 可以零拷贝共享同一块内存。相比通用推理框架,MLX 在 Mac 本地推理场景下能带来更低的内存占用和更高的吞吐效率。Ollama 目前主要依赖 llama.cpp 的 GGUF 格式进行量化推理,MLX 运行时的引入意味着 Ollama 将支持另一条原生的苹果平台推理路径,两者的评分(scoring)与调度逻辑存在差异,因此需要在能力声明机制稳定后再整合,以避免跨运行时的行为不一致。
对开发者意味着什么
对于日常使用 Ollama 的开发者,这个 rc 版本带来的直接影响有几点。
第一,Modelfile 的表达能力更强了。你可以在自定义模型时显式声明其能力,让下游调用方和框架准确知道模型能做什么。
第二,能力声明在继承链上的保留,意味着基于已有模型做二次构建时,不用担心关键元数据在层层封装中丢失,这对团队内部维护模型库是个好消息。
第三,作为 rc0(release candidate)版本,它面向的是愿意尝鲜、帮忙验证的用户。生产环境建议等待正式稳定版发布后再升级。
小结
Ollama v0.35.1-rc0 本身不是一个面向终端用户的"功能大更新",而是一次偏底层的架构优化。它用显式能力声明替换了脆弱的元数据匹配,统一了跨格式、跨继承的能力保留逻辑,并为未来的 MLX 运行时支持预留了接口。
对于本地大模型生态来说,这类基础设施层面的打磨虽然不显眼,却往往决定了框架的长期可维护性与扩展能力。关注 Ollama 的用户不妨留意后续正式版,以及 MLX 运行时相关工作的落地进展。
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。
PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。