普通拼写错误如何击穿LLM安全探针:Latent Undertow研究解读
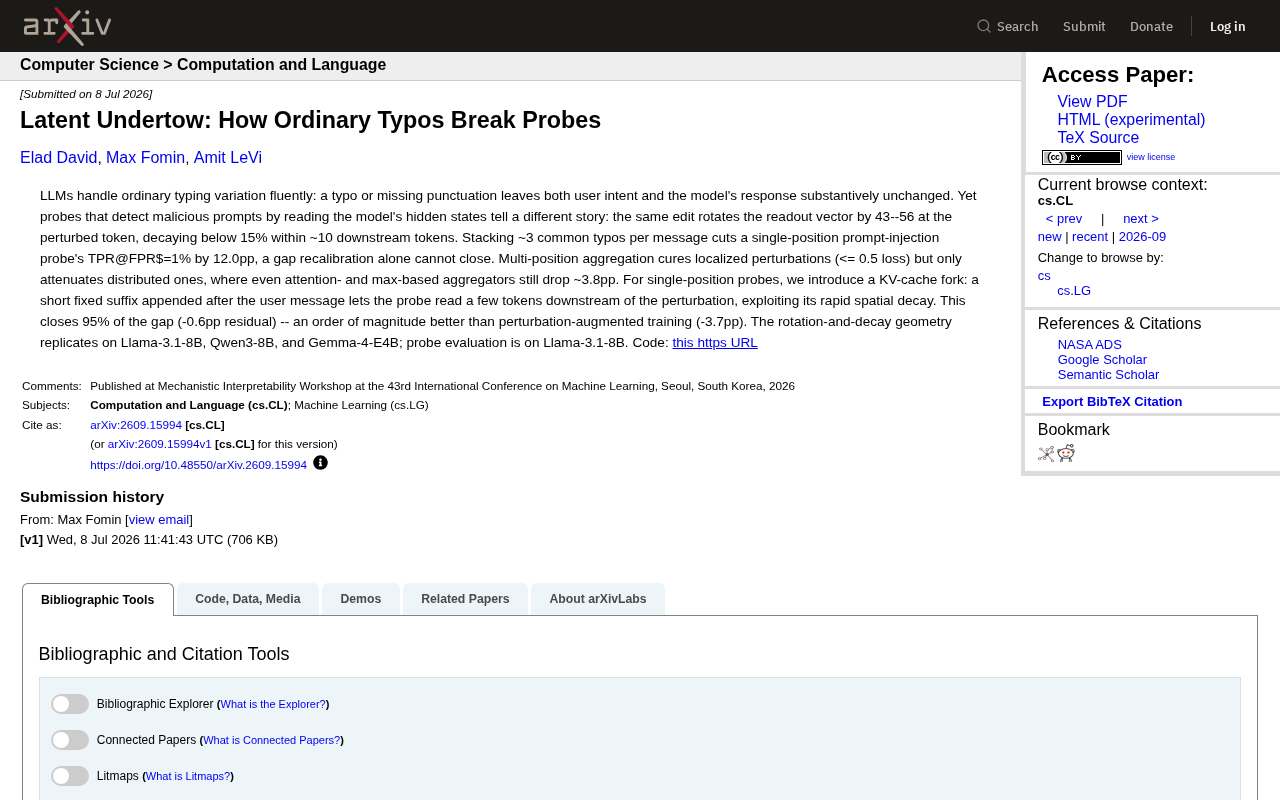
拼写错误可让LLM安全探针严重误判,KV缓存分叉方案可弥补95%性能缺口
《Latent Undertow》研究发现,普通拼写错误会使LLM安全探针读取的隐藏向量发生43至56度的旋转,足以导致提示注入检测严重失效,而这一扰动效应会在约10个下游token内迅速衰减至15%以下。仅叠加3个常见typo,探针的TPR@FPR=1%即下降12个百分点,且无法靠重新校准弥补。多位置聚合能缓解局部扰动,但对分散在多处的分布式扰动仍有约3.8个百分点的损失。研究提出的KV-cache分叉方案巧妙利用了"快速空间衰减"特性,通过在用户消息后追加固定短后缀、在下游位置读取探针状态,以近乎零开销弥补了95%的性能缺口,效果优于扰动增强训练一个数量级。该规律在Llama-3.1-8B、Qwen3-8B、Gemma-4-E4B三个主流模型上均可复现,表明这是当前Transformer架构的共性问题。
一个被忽视的安全盲区
大语言模型(LLM)对日常输入中的拼写变化表现得相当宽容——一个错别字、少了个标点,通常既不会改变用户的真实意图,也不会实质影响模型的回答。但一项名为《Latent Undertow》的最新研究揭示了一个反直觉的现象:这些无害的小改动,却足以让读取模型隐藏状态的安全探针(probe)发生严重误判。
所谓探针,是一种通过读取模型内部隐藏层向量来检测恶意提示(如提示注入攻击)的防御手段。它不依赖模型输出,而是直接"透视"模型内部的表征。这类方法近年来被视为对抗提示注入的重要防线,但这项研究表明,它们对输入扰动的鲁棒性远比想象中脆弱。
提示注入攻击(prompt injection)是指攻击者通过在输入中嵌入恶意指令,试图劫持或欺骗LLM执行非预期行为的一类攻击。与传统SQL注入类似,攻击者利用模型对指令与数据边界的模糊处理,将伪装成普通内容的恶意指令"注入"到模型的处理流程中。安全探针(probe)作为一种防御手段,其核心思想是:恶意提示在模型内部会激活特定的隐藏状态模式,通过训练一个轻量级的线性分类器来识别这些模式,就能在模型生成输出之前拦截攻击。这种方法的优势在于独立于模型输出,理论上难以被单纯的语言层面混淆所欺骗——然而《Latent Undertow》的研究正是对这一"独立性"假设发起了挑战。
旋转与衰减:扰动的几何特征
研究的核心发现可以概括为"旋转-衰减"(rotation-and-decay)几何规律。当输入中出现一个拼写错误时,探针在被扰动token位置读出的向量会发生43到56度的旋转——这是一个相当大的偏移。但有意思的是,这种偏移会快速衰减:在下游约10个token之后,扰动带来的影响就降到15%以下。
换句话说,扰动在模型的潜在空间中像水面的一道"暗流"(正对应论文标题Latent Undertow),它在局部制造剧烈波动,却在传播过程中迅速平息。这一几何特征并非个例,研究在 Llama-3.1-8B、Qwen3-8B 和 Gemma-4-E4B 三个不同模型上都复现了同样的现象,说明它是当前主流架构的共性问题,而非某个模型的偶然缺陷。
理解"旋转"这一几何描述需要一些背景。LLM的隐藏层将每个token表示为高维空间中的一个向量,探针本质上是在这个高维空间中划定一个决策超平面,用来区分"恶意"与"正常"表征。当输入token发生变化(如拼写错误),模型在该位置生成的向量方向就会发生偏移,即"旋转"。43至56度的旋转意味着原始向量与扰动后向量的余弦相似度约在0.6至0.7之间——对于线性探针而言,这足以将一个本应落在决策边界"恶意"一侧的向量推入"正常"区域,导致漏检。而"衰减"现象则源于Transformer的自注意力机制:随着序列向后延伸,模型通过多头注意力对上下文进行整合,局部扰动的影响会被后续token的表征"稀释",从而快速回归到近似原始的方向。
攻击成本极低,防御却难以简单弥补
这个漏洞的现实威胁在于攻击成本极低。研究显示,只需在一条消息中叠加约3个常见拼写错误,单位置提示注入探针在 FPR=1% 条件下的真阳性率(TPR)就会下降12个百分点。这意味着攻击者无需精心构造对抗样本,仅靠几个看似无意的typo就能显著削弱检测能力。
更棘手的是,这个性能缺口无法仅靠重新校准(recalibration)来弥补。研究还比较了扰动增强训练(perturbation-augmented training)这一常规思路,发现它只能把缺口缩小到-3.7个百分点,效果有限。
多位置聚合:治标不治本
一种自然的改进思路是多位置聚合(multi-position aggregation),即让探针综合多个token位置的信息,而非只看单点。研究发现,这种方法对局部扰动效果显著(损失小于等于0.5个百分点),基本可以"治愈"集中在单点的扰动。
但面对分布式扰动(distributed perturbations),即扰动散布在多个位置时,多位置聚合只能起到削弱作用。即便使用基于注意力(attention-based)或最大值(max-based)的聚合器,性能仍会下降约3.8个百分点。
KV-cache分叉:一个巧妙的工程方案
研究最有价值的贡献,是针对单位置探针提出的 KV-cache fork(KV缓存分叉)方法。它的思路直接利用了前面发现的"快速空间衰减"特性:既然扰动的影响在下游几个token就迅速消退,那就在用户消息后追加一段固定的短后缀,让探针读取扰动位置下游几个token的状态,从而避开扰动最剧烈的区域。
这一方法效果惊人——它弥补了95%的性能缺口,残差仅为-0.6个百分点,比扰动增强训练(-3.7pp)的效果好了一个数量级。这也印证了一个重要观点:理解漏洞背后的几何机制,往往比盲目做数据增强更能对症下药。
KV-cache(键值缓存)是Transformer推理中的标准加速技术:模型在逐token生成时,会将已处理过的每一层的Key和Value矩阵缓存下来,避免重复计算。KV-cache分叉正是利用了这一机制——在用户消息末尾追加一段固定后缀(如换行符或特殊标记)时,模型会在缓存基础上继续计算后缀对应位置的隐藏状态,而这些位置的表征已经通过注意力机制"消化"了上游扰动的影响。由于额外的后缀token数量很少,其计算开销近乎可以忽略,不需要修改模型权重,也不需要重新训练探针,是一种近乎零成本的工程补丁。这种方案的优雅之处在于:它不是在对抗扰动,而是顺势利用了模型自身的信息整合机制来"自愈"扰动带来的局部噪声。
对AI安全实践的启示
这项研究提醒我们,基于隐藏状态的探针虽然强大,但其鲁棒性存在被低估的风险。攻击者可以用几乎零成本的自然扰动绕过检测,而这类扰动在人眼看来完全无害,很难被内容审核发现。
对于正在部署提示注入防御的团队而言,几点实践价值值得关注:其一,不应假设探针天然对输入噪声鲁棒,需要专门评估拼写扰动下的表现;其二,KV-cache分叉这类利用模型内部几何规律的轻量方案,可能比重新训练更高效;其三,分布式扰动仍是尚未完全解决的开放难题。研究团队已在 GitHub(eladd-ai/latent-undertow)开源了代码,为后续研究和落地验证提供了基础。
相关推荐
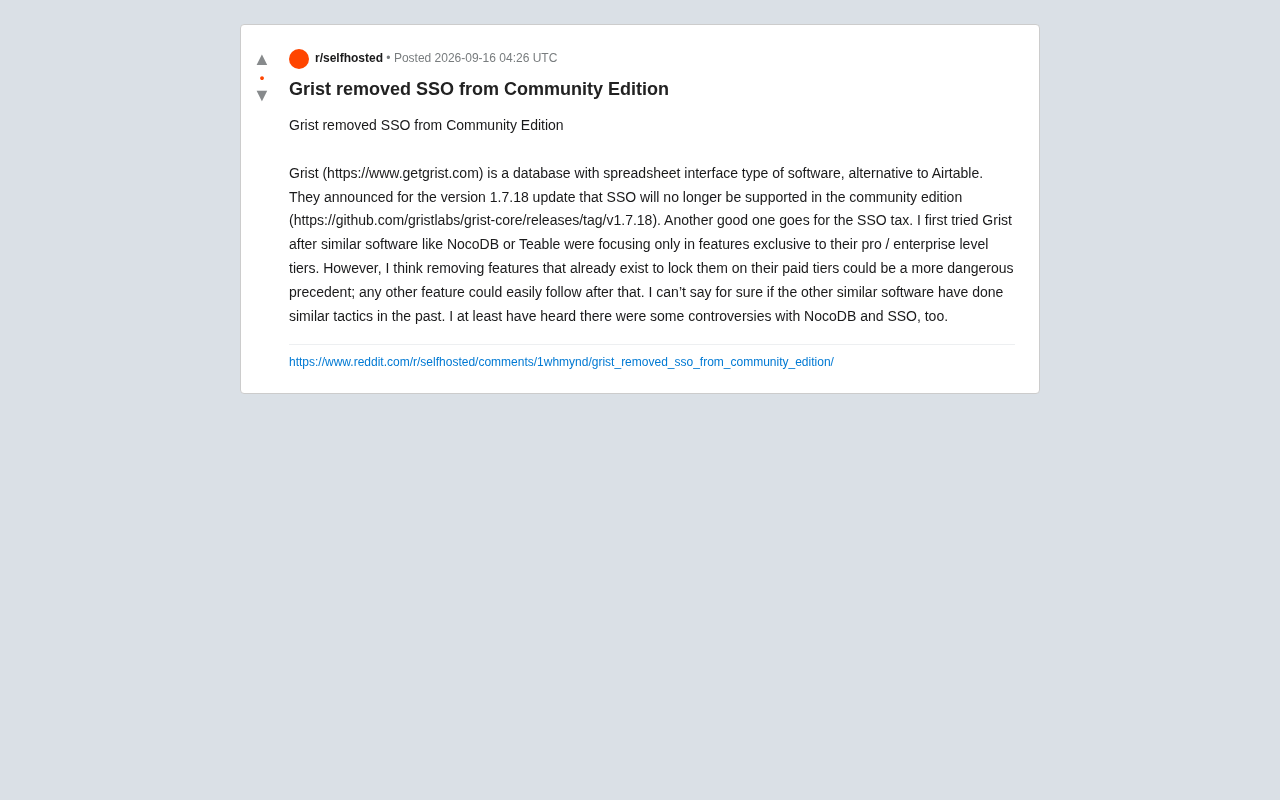
Grist移除社区版SSO功能:开源软件的"SSO税"争议再起
Grist在v1.7.18版本更新中移除了社区版的SSO单点登录功能,将其锁定至付费层级,引发"SSO税"争议。本文分析该事件、开源软件商业化困境及对自托管用户的启示。
Claude挑战循环真相:Wayfinder技能修复AI一次构建应用
解析Claude挑战循环(Challenge Loop)的运作原理与两大致命缺陷,以及如何用Matt Pocock的Wayfinder技能生成可验证规格文件,让AI代理一次性构建真实项目而非仅限游戏演示。
Claude Code 令牌耗尽?7个隐藏消耗点审计与修复指南
Claude Code 总是提前撞上令牌限制?本文拆解 Token 复合增长的底层机制,梳理从 /clear 到定时任务的七个隐藏消耗点,并澄清短提示、压缩、截图等无效省钱建议,附实用自查命令与审计方法。