企业级AI Agent实战:用智能体做事件根因富集

以「事件富集」为例,拆解企业如何在能力与信任之间找到AI Agent落地的最优解。
文章围绕「信任」这一核心命题,以IT运维中的事件富集场景为具体切入点,阐述企业落地AI Agent的务实路径。作者借YouTube博主Niran的用例说明:Agent的价值不在于自主修复系统,而在于面对「延迟」这类高不确定性故障时,跨多系统收集证据并完成推理富集,将最终决策权留给人。架构上,文章对比了大Agent与多小Agent的权衡,主张按系统拆分职责以降低爆炸半径与误报率;在访问控制上,引入身份网关通过令牌和授权精确限定每个Agent的权限边界;在工具设计上,强调MCP服务器应围绕任务意图暴露只读工具而非镜像API。整体框架给出了一套兼顾价值与可控性的企业级Agent设计原则。
当企业开始部署AI Agent时,真正的分水岭不在于「智能体能做什么」,而在于「你敢信任智能体做什么」。YouTube博主Niran在其系列vlog中提出的这个观点,直指企业落地AI Agent的核心矛盾——能力与信任的权衡。
本文基于他分享的一个具体用例:事件富集(Incident Enrichment),拆解如何在低风险、高价值的场景中让Agent真正发挥作用,而不是停留在「问VCF系统你有几台虚拟机」这类玩具级演示。
别把Agent当自动化,也别放它独自救火
Niran打了一个很贴切的比喻:用AI就像给自己穿上外骨骼。老板让你写文档,你不会直接让AI写完发给老板,而是自己起草、再让AI润色加工。Agent在企业里的定位也类似——增强人的能力,而非替代人做决策。
他特别强调了两点容易混淆的边界:
第一,Agent不等于自动化。 自动化擅长高度可重复的流程;而Agent真正的价值在于那些变量多、难以标准化、需要推理判断的场景。如果一个流程本身就能脚本化,就不该交给Agent。
第二,不要盲目信任Agent去修复系统。 Niran坦言,他不会放一个Agent进网络里直接改系统。真正该让Agent做的,是帮助人更快地定位问题、辅助根因分析(RCA),从而缩短故障的识别与解决时间——这才是实实在在的业务价值。
为什么选「延迟」类事件作为切入点
用例的主角是一个关键业务应用(比如结账系统),因为这类系统直接关联业务产出,保障其可用性价值极高。
Niran刻意选择了「延迟(latency)」这类事件,而不是「组件宕机」。原因很直接:宕机容易定位——你能看到什么挂了;而延迟是「无定形」的,可能来自计算、网络、存储、运行时等任何一环,排查起来极其恼人。正是这种高不确定性,才最能体现Agent的推理价值。
针对延迟问题,他锁定了三个可能的根因系统:
- VCF:涵盖计算、网络、存储、虚拟化的私有云基础设施
- Kubernetes:应用部分组件的运行时
- 负载均衡器(LB):用户和系统访问应用的入口
核心架构:一个响应Agent + 多个诊断Agent
整个设计的中枢是事件响应Agent(Incident Response Agent)。当事件产生时,先给它喂入结构化的上下文与拓扑信息,让它准确理解被监控系统的构成。随后它会自问:该调查哪些系统?
这里出现了第一个关键抉择——要不要让一个大Agent访问所有系统?
大Agent vs 多个小Agent
Niran给出了两条反对「一个大Agent」的理由:
- 爆炸半径(blast radius)过大:单个Agent握有所有系统访问权,一旦出问题波及面更广。
- 跨系统幻觉导致误报:如果一个Agent同时处理多系统信息,发生误判、幻觉或理解偏差的概率上升,容易产生大量false positive。
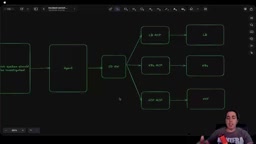
他的解法是拆分为三个诊断Agent:LB诊断Agent、Kubernetes诊断Agent、VCF诊断Agent。每个Agent上下文更小、职责更单一,既降低误报率,也缩小了信任敞口。
MCP服务器的设计原则
每个诊断Agent通过各自的MCP服务器访问目标系统。Niran提醒了一个重要的工程实践:不要把MCP做成API schema的镜像,否则会把API的所有「丑陋」直接暴露出来。正确做法是围绕「你要做什么」来设计工具,比如:
- LB MCP:get VIP、inspect pool 等
- VCF MCP:inspect VM、inspect host、get storage 等
- Kubernetes MCP:get pods、list events 等
注意这些工具全部是只读/查询类(收集数据、延迟、CPU信息),而非修改或变更系统——这正是「低风险」的来源。
MCP(Model Context Protocol)是Anthropic于2024年底推出的开放协议,旨在标准化AI模型与外部工具、数据源之间的连接方式。你可以把它理解为AI领域的「USB-C接口」——无论底层系统是数据库、API还是本地文件,只要包装成MCP服务器,Agent就能用统一的方式调用。MCP服务器对外暴露的核心单元是「工具(Tool)」,每个工具对应一个具体操作,Agent通过工具名称和参数描述来理解「能做什么」并决定「何时调用」。这正是Niran强调「不要直接镜像API schema」的原因:原始API往往有几十上百个端点,充斥着内部命名习惯和历史包袱,直接暴露会让Agent在大量无关工具中迷失;而按业务意图精心设计的少量只读工具,则能显著提升Agent的推理准确率,同时天然限制了误操作的可能性。
事件富集(Incident Enrichment)是IT运维(ITOps/AIOps)领域的成熟概念,指在原始告警或事件工单的基础上,自动补充相关上下文信息——例如受影响的系统拓扑、历史变更记录、关联指标、潜在根因——使其变成一张「信息密度更高」的工单,从而缩短一线工程师的平均诊断时间(MTTD)。传统富集依赖规则引擎或固定脚本,只能处理已知模式;而基于Agent的富集能够在多系统证据之间进行跨域推理,对「延迟」这类症状模糊、根因多样的问题尤为有效。衡量其业务价值的核心指标通常是MTTD(平均检测时间)和MTTR(平均修复时间)的缩短幅度,因为每分钟的故障时间在关键业务系统上都直接对应营收损失。
用身份网关把「信任」抽象出来
如何控制这些Agent的访问权?Niran引入了一个身份网关(Identity Gateway)(他提到可用AgentMinder这类工具)。
网关的作用是把「信任」从Agent本身抽象出去:通过令牌(token)精确控制每个Agent能访问哪些MCP、能执行哪些意图(intent),用授权(grant)管理权限。这样即便某个Agent行为异常,也被严格限制在许可范围内。
他还强调了分层安全的必要性——比如要防止VCF Agent绕过AgentMinder直接访问系统,光靠身份网关一层是不够的。
「爆炸半径(Blast Radius)」这一概念借用自安全工程领域,原指一次安全事故或系统故障所能波及的最大范围。在AI Agent语境下,它描述的是:当一个Agent行为异常(幻觉、误判、被恶意提示注入)时,可能造成的最坏破坏边界。单个大Agent若同时持有对所有系统的读写权,其爆炸半径就等于所有被接入系统的总和;而拆分为多个职责单一的小Agent并配合身份网关的细粒度授权,则能把每次潜在事故的爆炸半径压缩到单一系统甚至单一操作类型。这与微服务架构中「故障隔离」的设计哲学一脉相承——不假设组件永远正确运行,而是在架构层面限制单点失效的传播范围。对企业AI治理而言,这也是向审计和合规团队证明「可控性」的重要依据。
富集后的事件长什么样
整个流程跑起来是这样:事件响应Agent唤醒相关诊断Agent → 各Agent查询自己的系统并返回诊断证据 → 响应Agent汇总推理 → 生成富集后的事件更新。
示例诊断证据:
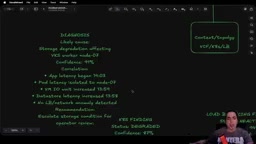
- Kubernetes Agent:状态轻度降级,置信度87%,发现3个受影响Pod均运行在worker 7上;评估无控制面问题或资源争用,疑似基础设施依赖问题。
- LB Agent:负载均衡器健康、连接池正常,不太可能是问题源头。
- VCF Agent:I/O上升、数据存储延迟升高,评估存储降级最可能是基础设施根因。
最终响应Agent给出综合结论:「最可能原因是存储降级,影响VKS worker节点07,置信度91%」,并附上指标关联与推理依据。
关键在于——Agent本身不执行任何修复动作,它只负责调用其他Agent、通过MCP收集证据、做推理,然后把结果回填给事件系统。
想象一下:工单里不再只是「关键应用checkout延迟降级」这样一句话,而是带着受影响节点、置信度、根因推测的完整富集信息。当人工介入时,定位速度将大幅提升。
没有标准答案的架构权衡
Niran在结尾坦诚,这只是一个用例、一种提议的架构,并非万能方案。他留下了两个值得企业自行思考的开放问题:
- 用大Agent做很多事,还是用小Agent各司其职?
- MCP服务器应该集成大量工具,还是精简工具集?
答案取决于你对「信任」和「确定性结果」的要求程度。这本质上是一场架构权衡,而非技术优劣之争。
对企业而言,事件富集这个用例的启示很清晰:先找低风险、高价值、高变异性的既有流程,让Agent做证据收集与推理富集,把最终决策权留给人。这或许才是当下企业级AI Agent最务实的落地姿势。
相关推荐
5步构建机器人仿真SimReady资产:前沿AI模型实战指南
NVIDIA分享借助前沿AI模型构建机器人仿真SimReady资产的5步工作流,涵盖CAD转OpenUSD、材质配置、碰撞体生成与物理属性标注,助力机器人仿真开发高效落地。
Restock:能在Slack里用Stripe买办公用品的AI采购代理
Restock 是基于 Managed Deep Agents 构建的开源示例 AI 代理,能在 Slack 里理解采购需求、通过 Zinc 搜索真实商品、用 Stripe Link 完成付款。它展示了 AI 代理安全执行真实交易的「人在环中」范式,并提供免下单的排练模式供试用。
生物医学影像的真正瓶颈:数据,而非模型
生物医学影像AI的真正瓶颈不在模型而在数据。本文分析医院海量影像数据背后的可获取性、标注成本、隐私合规与标准化难题,探讨数据基础设施为何比模型更难突破。