潜空间预测超越重建:触觉预训练新范式
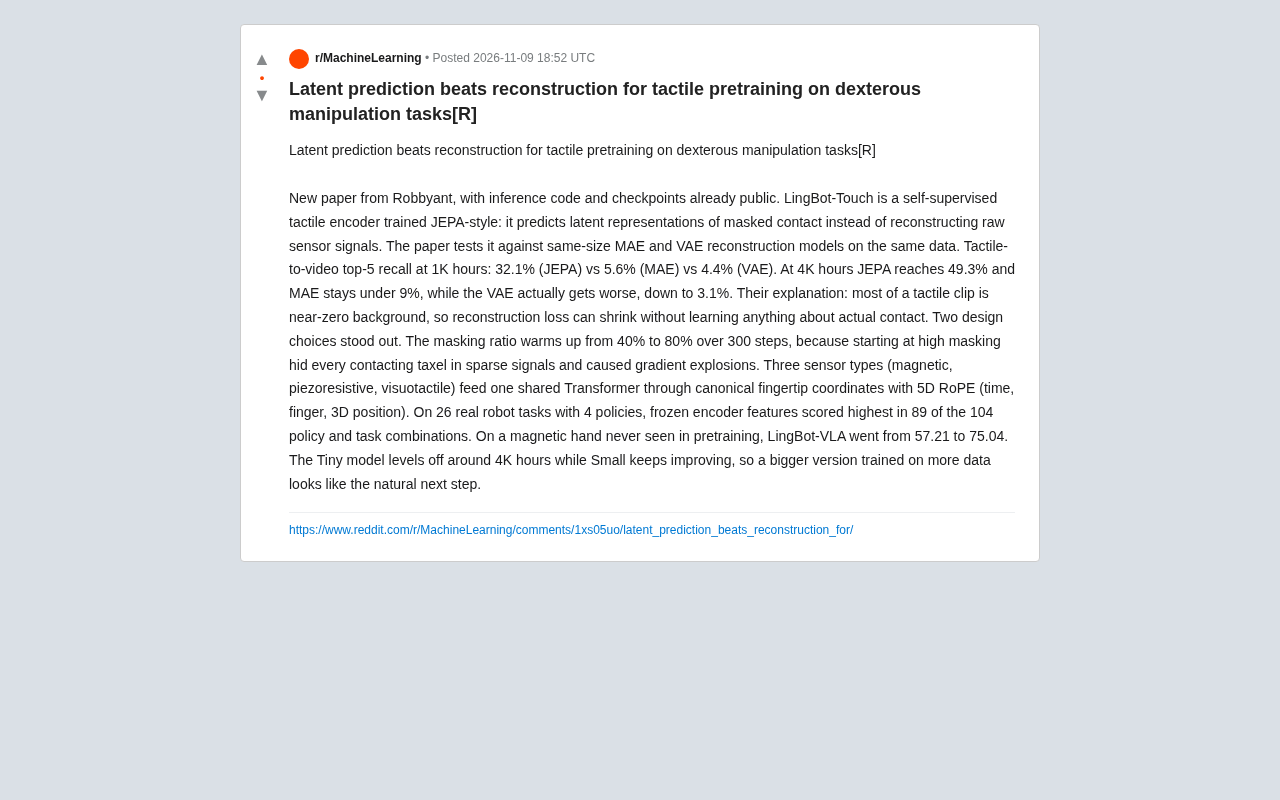
LingBot-Touch 用 JEPA 潜在预测替代重建做触觉预训练,召回率远超 MAE/VAE。
Robbyant 团队的 LingBot-Touch 提出一种 JEPA 式自监督触觉编码器:不重建被遮蔽的原始传感器信号,而是预测其潜在表示。在触觉到视频 top-5 召回任务上,1K 小时数据时 JEPA 达 32.1%,MAE 仅 5.6%、VAE 为 4.4%;扩到 4K 小时后 JEPA 升至 49.3%,重建类方法仍低于 9% 甚至退化。作者指出原因是触觉片段大部分为近零背景,重建损失可在不学接触特征的情况下降低。工程上采用掩码比例从 40% 预热到 80%,并用规范化指尖坐标加 5D RoPE 让三类传感器共享一个 Transformer。真机上冻结特征在 104 个组合中 89 个最优,未见过的磁式手上 LingBot-VLA 从 57.21 提升到 75.04。
触觉传感长期被视为机器人操作中最难利用的模态之一。传感器信号稀疏、噪声大,大部分时间处于近零背景状态,直接套用视觉领域的自监督方法往往收效甚微。Robbyant 团队的新论文 LingBot-Touch 给出了一个反直觉但数据扎实的答案:在触觉预训练中,预测被遮蔽接触的潜在表示,比重建原始传感器信号有效得多。论文的推理代码与检查点已经公开。
JEPA 思路迁移到触觉:为什么不重建
LingBot-Touch 的核心是一个自监督触觉编码器,训练方式借鉴了 JEPA(Joint Embedding Predictive Architecture)——模型不重建被遮蔽的原始信号,而是预测其潜在表示。论文将其与同尺寸的 MAE(掩码自编码)和 VAE(变分自编码)重建模型在相同数据上做了对照。
结果差距悬殊。在触觉到视频的 top-5 召回任务上,使用 1K 小时数据时,JEPA 达到 32.1%,MAE 仅 5.6%,VAE 为 4.4%。数据量扩大到 4K 小时后,JEPA 升至 49.3%,MAE 仍不足 9%,而 VAE 反而退化到 3.1%。
作者对这种现象的解释值得注意:一段触觉片段中绝大部分是近零背景,重建损失可以在完全不学习真实接触特征的情况下持续下降。也就是说,重建目标在稀疏触觉信号上给出了错误的优化方向,模型"偷懒"就能把损失做低。潜在预测则迫使模型关注接触本身的结构,而非背景的像素级还原。
JEPA(Joint Embedding Predictive Architecture) 由 Yann LeCun 提出,核心思想是在潜在空间而非像素/信号空间做预测:给定一部分输入的编码,预测另一部分输入的编码。与 MAE 重建被遮蔽的像素、VAE 重建输入的分布不同,JEPA 的预测目标本身就是网络学到的表示,因此模型不必浪费容量去建模难以预测的低层细节(如背景纹理)。在视觉中这被认为能学到更语义化的特征;LingBot-Touch 把这一逻辑搬到触觉,正是看中其对"无信息背景"的天然鲁棒性。
MAE(掩码自编码) 是 He 等人提出的视觉自监督方法:随机遮蔽大部分图像块,用轻量解码器重建被遮蔽的原始像素,损失为像素级 MSE。VAE(变分自编码) 则通过编码到潜变量分布再解码重建,优化证据下界。两者在触觉上的共同问题在于,重建目标直接作用于原始传感器读数,而触觉读数大部分时间接近零,模型只需输出"零"即可大幅降低损失,接触事件反而被忽略。
两个关键设计:掩码预热与多传感器统一编码
论文中有两个工程设计细节,直接决定了训练能否稳定收敛。
掩码比例预热。 训练从 40% 掩码比例开始,在 300 步内逐步升至 80%。直接以高掩码起步会怎样?在稀疏触觉信号中,高掩码很容易把所有正在接触的 taxel 全部遮住,模型失去可学习的信号,进而引发梯度爆炸。逐步预热让模型先建立基本的表示能力,再逐步提高难度。
三类传感器共享一个 Transformer。 磁式、压阻式和视触觉三种传感器数据,通过规范化的指尖坐标与 5D RoPE(时间、手指、三维位置)输入同一个共享 Transformer。这种做法让不同物理原理的触觉信号在统一的空间-时间编码框架下对齐,为跨传感器迁移打下基础。
taxel 是 tactile pixel 的缩写,指触觉传感器阵列中的单个传感单元,类似图像中的像素。一个指尖触觉阵列通常包含数十到数百个 taxel,每个 taxel 在每一时刻输出一个接触强度值。由于手指并非时刻接触物体,大部分 taxel 在大部分时间读数接近零,这正是文中"近零背景"的来源。高掩码比例下,若被遮蔽的恰好是少数正在接触的 taxel,模型几乎拿不到有效监督信号,梯度估计方差急剧增大,从而引发文中提到的梯度爆炸。
5D RoPE 是在旋转位置编码(RoPE)基础上的多维扩展。标准 RoPE 为一维序列位置编码旋转相位,使注意力分数自然携带相对位置信息;5D RoPE 则把时间、手指编号以及指尖的三维空间坐标分别编码进不同频率的旋转分量,让共享 Transformer 在同一注意力机制中同时感知"何时""哪根手指""在何处"。配合规范化的指尖坐标(把不同手型、不同传感器布局映射到统一坐标系),磁式、压阻式、视触觉三类物理原理迥异的信号得以在同一空间-时间框架下对齐,这是跨传感器迁移能够成立的结构性前提。
真机验证:冻结特征在多数任务中胜出
预训练编码器的价值最终要在真实机器人任务上检验。论文在 26 个真实机器人任务、4 种策略上进行了评估,冻结编码器特征在 104 个策略与任务组合中有 89 个取得最高分。
更具说服力的是跨传感器迁移实验:在一只预训练中从未见过的磁式灵巧手上,LingBot-VLA 的得分从 57.21 提升到 75.04。这说明编码器学到的不是某一类传感器的表面统计特征,而是可迁移的接触表示。
模型规模方面,Tiny 版本在约 4K 小时数据后性能趋于平缓,Small 版本则持续提升。作者据此判断,更大规模模型配合更多数据是自然的下一步。这也暗示触觉预训练可能仍处于数据与容量的 scaling 早期阶段。
对触觉自监督研究的启示
这项工作与视觉领域近期的争论形成呼应:重建式预训练是否真的是最优的自监督目标?在触觉模态上,答案似乎更明确地偏向"否"。稀疏信号的特殊统计特性——大量近零背景加少量关键接触——放大了重建目标的缺陷,也让潜在预测的优势更加突出。
对实践者而言,可直接复用的经验包括:掩码策略需针对信号稀疏度设计,不能照搬视觉配方;多传感器统一编码值得优先考虑,跨本体迁移的收益已经过真机验证;评估时应关注冻结特征的下游表现,而非预训练损失本身。代码与检查点已公开,这些设计选择可以被社区直接检验和复现。
相关推荐
实测Shopify AI Toolkit:给AI生成的Shopify代码加上官方校验
实测Shopify官方AI Toolkit:将Shopify文档、API schema和代码校验接入Claude Code等编程助手,拦截AI捏造字段的错误。了解安装步骤、离线校验能力与遥测默认开启的注意事项。
Claude调度AI编程团队:Agent Orchestrator实战解析
Agent Orchestrator开源项目让Claude Code调度Codex、Gemini、Cursor等多个AI并行编程,通过Git Worktree隔离、CI自动纠错和移动端通知实现AI团队协作。本文解析其核心机制、成本结构与适用场景。
谷歌新AI编程击败Claude,成本仅三分之一
谷歌Gemini 4 Carbon在CursorBench 4.0上以60.4%超越Claude Fable 5.2 Max的60%,单任务成本仅9.22美元,约为后者32.79美元的三分之一。本文解析这场编程AI性能与价格的对决,以及Slash Swarm多智能体新功能。