强化学习智能体如何"察觉"世界是假的:物理规则错误让检测率从50%跃升至73%
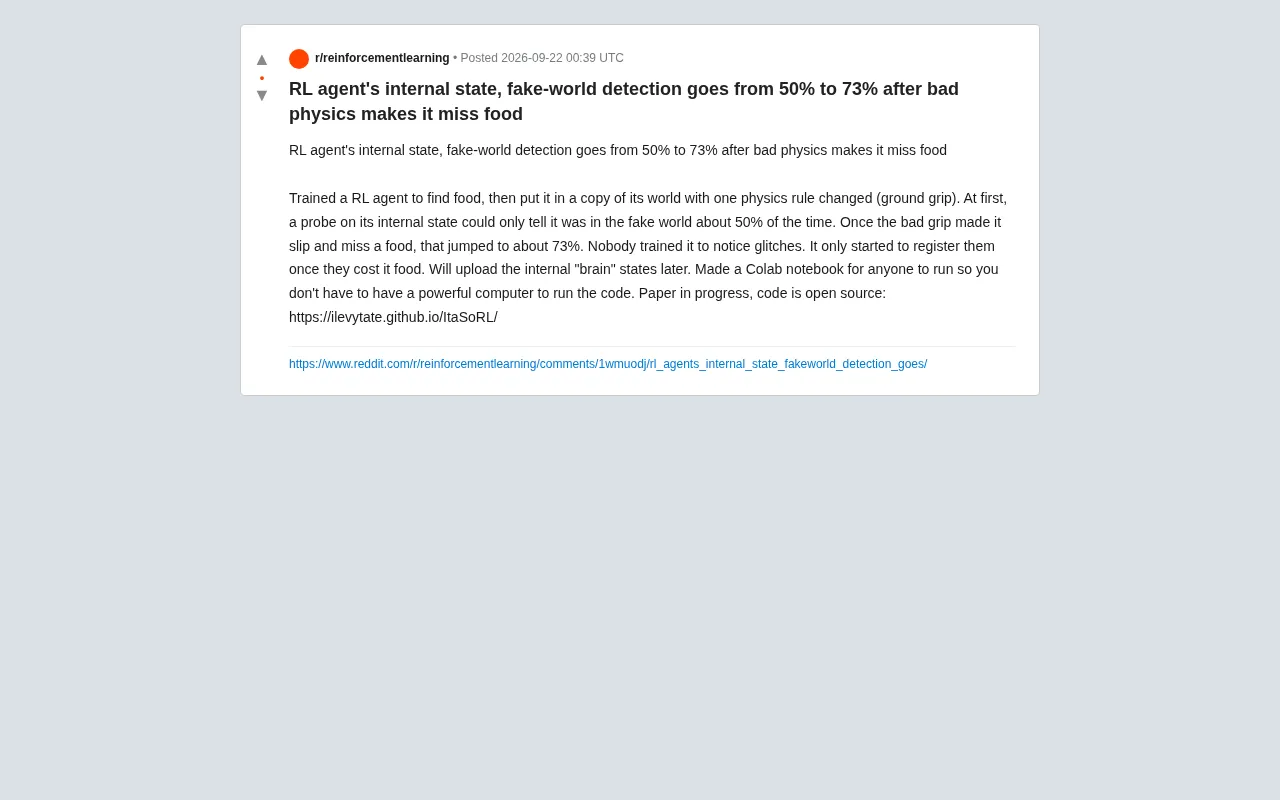
RL智能体只有在物理规则改动真正导致奖励损失后,才会在内部状态中"登记"环境异常。
研究者将一个训练完成的觅食RL智能体放入仅修改了地面抓地力的"假世界",并用探针技术读取其内部表征,观察它能否"感知"到环境被篡改。初始阶段探针准确率约50%,接近随机;但当错误抓地力让智能体实际错过食物后,准确率跃升至约73%。没有人专门训练它识别异常,这种觉察完全由奖励损失驱动,高度体现了RL目标导向的本质。该实验为AI可解释性、内部世界模型与分布外行为研究提供了一个低成本、可复现的实验范式,代码已开源并附有Colab notebook,但论文仍在撰写中,结论需在更严格的统计条件下验证。
一位研究者在 Reddit 上分享了一个颇具启发性的实验:训练一个以觅食为目标的强化学习(RL)智能体,随后把它放进一个与原始世界几乎相同、只改动了一条物理规则(地面抓地力)的"假世界"里。结果发现,智能体的内部状态在遭遇物理错误、真正因此"吃不到食物"之后,才开始明显"意识到"自己身处一个被篡改的环境。这个现象为讨论 AI 的内部表征与环境感知提供了一个有趣的样本。
实验设计:改一条物理规则,看智能体如何反应
实验的核心逻辑相当简洁。研究者先在正常物理规则下训练一个 RL 智能体,让它学会在环境中寻找食物。训练完成后,把它转移到一个"副本世界"——这个世界与训练环境唯一的区别是地面抓地力(ground grip)被修改了。
关键在于,研究者并没有专门训练智能体去"识别世界是否为假"。他们的做法是在智能体的内部状态上挂载一个探针(probe),通过读取内部表征来判断智能体是否"知道"自己处于假世界。
初始阶段,这个探针的判断准确率只有大约 50%——换句话说,几乎等同于随机猜测。智能体虽然身处一个物理规则被改动的环境,但它的内部状态并没有对此产生可被读出的区分信号。
从50%到73%:错误带来代价,才触发"觉察"
转折发生在物理错误真正造成后果的那一刻。当被改动的抓地力让智能体打滑、并因此错过了一次食物之后,探针对"假世界"的检测准确率从约 50% 跳升到了约 73%。
研究者强调了一个耐人寻味的细节:没有人训练它去注意这些故障(glitches)。智能体只有在故障实实在在地让它损失了食物之后,才开始在内部状态中"登记"这些异常。
这背后的逻辑与强化学习的本质高度一致。RL 智能体的行为完全由奖励信号驱动——它关心的是能否获得食物,而不是抽象意义上的"世界是否真实"。物理规则的偏差在没有影响到奖励之前,对它而言几乎是"不可见"的;一旦这种偏差直接导致奖励损失,环境的异常才在内部表征中被编码出来。
为什么这个结果值得关注
这个小实验触及了当前 AI 可解释性(interpretability)研究中的一个重要议题:智能体的内部表征究竟编码了什么,又是在什么条件下编码的。
从探针技术的角度看,用一个线性或轻量级探针去读取模型内部激活、判断某个概念是否被表征,是可解释性研究的常见手段。这里的实验把探针目标设定为"当前是否处于假世界",并观察到检测能力随着任务结果的变化而变化,这提示我们:模型的内部世界模型(world model)并非静态,而是与其目标和实际经历紧密耦合。
换个角度说,智能体对"环境异常"的敏感度,本质上是被奖励结构塑造出来的。它不会主动去表征那些与目标无关的差异。这对于研究 AI 在分布外(out-of-distribution)或被篡改环境中的行为,以及探讨 AI 是否会"察觉"自己身处测试或沙盒环境,都提供了一个可操作的实验范式。
探针技术(probing)是可解释性研究中的一种常用工具,其基本思路是:在已训练的神经网络的某一中间层提取激活向量,然后用一个简单的分类器(通常是线性模型)来预测某个外部概念是否被编码在这些激活中。如果线性探针能以显著高于随机的准确率完成分类,则认为该概念在模型内部存在某种可读出的表征。这种方法的优势在于它不需要修改原始模型,只需"旁听"内部状态。但它也有内在局限:探针准确率的高低反映的是信息的线性可分离程度,而非模型是否"有意"表征了该概念。因此,当本文中探针从50%跃升至73%时,更准确的解读是:奖励损失使内部激活在"真实世界"与"假世界"两种情境下变得更易被线性分开,而不能直接等同于智能体产生了主动的环境觉察。
开源与可复现:普通人也能跑起来
值得肯定的是,作者把这个实验做成了开放、可复现的形式。据原帖介绍,代码已开源,项目地址为 ItaSoRL(https://ilevytate.github.io/ItaSoRL/)。作者还制作了一个 Colab notebook,让没有强大算力的人也能直接在云端运行这段代码,降低了复现门槛。
此外,作者表示论文仍在撰写中(paper in progress),并计划后续上传智能体的内部"大脑"状态数据,供社区进一步分析。
需要理性看待的边界
这毕竟是一个来自个人研究者、尚处于论文撰写阶段的初步实验,几个方面值得保持谨慎。
其一,样本与设定较为简化:只改动了单一物理规则(抓地力),检测准确率的数字(50%、73%)也需要在更严格的统计条件、更多随机种子和对照下才能确认其稳健性。
其二,"检测率提升"是否等同于智能体"意识到"世界是假的,这里存在解释上的空间。探针能读出区分信号,更准确的表述是内部表征在遭遇奖励损失后变得更可分离,而非智能体产生了某种主观的"察觉"。
其三,在论文正式发布、完整方法与数据公开之前,这一结果更适合作为一个引发讨论的实验现象,而不是定论。尽管如此,它以极低的复现成本呈现了一个清晰的因果链条——奖励损失如何反过来塑造内部表征——这本身就具有启发价值。
内部世界模型(world model)这一概念在 RL 研究中有特定含义:它指智能体通过与环境交互隐式或显式地学习到的环境动力学表征,用于预测行动结果、辅助规划。在无模型(model-free)RL 中,世界模型通常以隐式形式存在于神经网络权重中,而非独立的可查询模块。本实验揭示了一个重要特性:这种隐式世界模型并非对环境的完整、客观的表征,而是以奖励为中心"剪裁"的——只有与奖励获取相关的环境信息才会被充分编码。这与分布外泛化(OOD generalization)研究中的一个核心担忧直接相关:当环境发生变化时,智能体的内部模型可能对那些"还未造成损失"的偏差保持沉默,直到真正吃亏后才更新表征,这在安全关键场景中可能构成风险。
相关推荐
Metapunk三大新技能:构建AI软件开发闭环
Metapunk新版本新增Implement Spec、PR和Retro三大技能,补齐AI软件开发闭环。本文解析各技能功能与工作流,帮助提升AI Agent开发效率与代码质量。
6个黑暗中的恐怖故事:TED-Ed用动画讲透人性寓言
TED-Ed 精选六则恐怖故事合集,涵盖《猴爪》、日本阿岩传说、死神教父、贝奥武夫、爱伦·坡《红死魔的面具》与无耳芳一。本文解析这些动画短片如何用跨文化寓言讲述欲望、背叛与死亡的代价,以及它们为何适合作为课堂讨论素材。
Python调用Ollama轻量模型实战指南
从安装Ollama、拉取0.8B轻量模型到用Python跑通调用的完整实操指南,含服务启动、模型名匹配、首次加载延迟等易踩坑细节,单次调用实测0.23秒。