权重空间编程:LLM直接改写神经网络权重的新范式

权重空间编程主张让LLM直接推理和修改神经网络权重,绕开梯度下降,以提升效率与可解释性。
文章介绍了一种名为“权重空间编程”的新方向,即让大语言模型直接读取、推理并修改神经网络的权重,而不依赖损失函数、梯度下降或训练循环。该方向的核心主张是神经网络权重将由刻意推理权重的LLM原生优化,实现优化主体的转移。其价值体现在两层:工程上可能降低成本并提升效果,更重要的是可解释性——LLM能够解释其他网络如何工作、为何做出某些行为。但来源仅为观点性阐述,未说明LLM如何读取海量浮点权重、如何保证修改后网络有效等实现细节,且用LLM解释权重可能引入新的不透明层。尽管如此,将权重视为可推理、可编辑对象的视角具有启发性,暗示模型优化与理解可能走向统一。
什么是权重空间编程?
训练神经网络的传统路径几乎固定:定义损失函数、跑梯度下降、循环迭代,最终得到一组权重和偏置。但一个名为「权重空间编程」(Weight-Space Programming)的新方向正在打破这个流程——不再只是训练网络产出权重,而是让大语言模型直接读取、推理并修改这些权重。
据该YouTube来源的阐述,这一过程不依赖损失函数,不走梯度下降,也不需要训练循环,LLM 只需「看着权重」,就能对它们进行推理、修改,甚至从零生成。这相当于把模型权重视为一种可被语言模型理解和编辑的对象,而非只能通过数值优化间接调整的黑箱参数。
梯度下降与损失函数:传统神经网络训练的核心机制。损失函数衡量模型预测与真实标签之间的差距,梯度下降则沿着损失函数的梯度方向逐步调整权重,使损失最小化。这一过程需要反复前向传播和反向传播,计算量大且依赖大量标注数据。权重空间编程之所以强调“不靠梯度”,是因为它试图绕开这一数值优化循环,转而用语言模型的推理能力直接对权重进行语义层面的编辑,这要求LLM能够理解权重张量中蕴含的模式,而非仅将其视为无结构的浮点数集合。
权重作为可编辑对象:在传统视角下,权重是训练结束后固化的数值矩阵,人类难以直接解读或修改。权重空间编程将权重视为一种“文本”或“程序”,LLM可以像阅读代码一样阅读权重,并像修改代码一样修改权重。这背后隐含的假设是,权重空间中存在可供语言模型捕捉的规律性结构,例如特定的神经元激活模式对应某种概念。若该假设成立,则模型优化将从黑箱搜索转变为白盒编辑,但如何将高维浮点权重编码为LLM可处理的序列,仍是未解的技术难题。
核心主张:权重将由LLM原生优化
该来源给出了一个相当大胆的判断:神经网络权重很快就会由「刻意对权重进行推理的LLM」来原生优化。这句话的关键词是「刻意推理」——不是用LLM做超参数搜索或架构建议这类外围辅助,而是让LLM直接介入权重本身的优化决策。
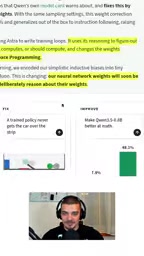
这一主张的颠覆性在于优化主体的转移。传统流程里,人是设计者,优化器是执行者,权重是结果;而在权重空间编程的设想中,LLM 同时扮演理解者和修改者,权重成为可对话的对象。来源并未展开具体的技术实现路径,但明确了「不靠梯度」这一前提,意味着它与现有训练范式存在本质区别。
为什么值得关注:效率与可解释性
该来源指出这一方向有两层意义。第一层是成本与效果:用这种方式优化神经网络可能更便宜,效果也可能更好。这属于工程层面的吸引力,但来源并未给出具体数据支撑,更多是一种方向性判断。
第二层被来源明确称为「更重要的」——可解释性。如果一个大语言模型能够告诉你另一个神经网络或另一个大语言模型是如何工作的、如何推理的、为什么做出某些行为,这将是游戏规则的改变。原因很直接:我们终于有机会真正理解这些AI模型内部发生了什么。
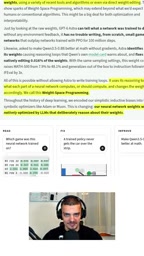
可解释性长期是深度学习的软肋。权重空间编程提供了一个新思路:与其用探针、注意力可视化等外部工具去猜测权重的含义,不如让具备推理能力的LLM直接读取权重并给出解释。来源承认这听起来像「AI话术」,但坚持认为这确实是颠覆性的。
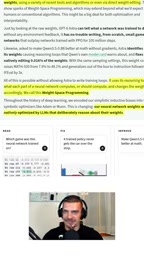
可解释性研究:当前深度学习可解释性主要依赖外部归因方法,如显著性图、注意力可视化、探针分类器等。这些方法只能提供局部或间接的解释,无法完整刻画网络内部的因果机制。权重空间编程提出了一种“内生解释”路径:让具备推理能力的LLM直接分析权重本身,从而生成关于网络行为的自然语言描述。这种思路与机械可解释性(mechanistic interpretability)有交集,后者试图逆向工程神经网络的内部电路,但权重空间编程更强调用LLM作为解释主体,而非人工设计分析工具。其潜在优势是解释的覆盖面和灵活性,风险则是LLM可能生成看似合理但实际错误的解释,即幻觉问题在解释场景中的放大。
冷静看待:愿景与落地之间的距离
补充一点,该来源是一段观点性很强的阐述,而非技术报告。它没有说明LLM如何读取权重(权重是海量浮点数,如何进入语言模型的上下文)、如何保证修改后的网络仍然有效、以及「从零创建权重」在什么规模上可行。这些恰恰是权重空间编程从概念走向实践必须回答的问题。
另一个值得追问的点是:如果LLM本身就难以完全解释,那么用LLM去解释另一个网络的权重,是否会引入新的不透明层?来源将可解释性列为最大价值,但这一逻辑链条的严密性仍有待验证。
不过,把权重视为可推理、可编辑的对象,这个视角本身具有启发性。它暗示了模型优化与模型理解可能走向统一:同一个推理过程,既在改权重,也在解释权重。对于关注AI编程与AI应用演进的读者,这是一个值得持续跟踪的方向。
相关推荐
Starlink Mini 2 发布:便携卫星上网再进化
Starlink Mini 2 在 Hacker News 引发热议,帖子获 285 点、291 条评论。本文梳理便携卫星终端的迭代方向、社区讨论焦点及实际使用场景。
PewDiePie自搜趣谈:退休、自研AI模型Ajax与Linux日常
PewDiePie发布自搜视频,回应退休传闻,透露自研AI模型Ajax已达60 tokens/s、仍处BF16训练阶段,并分享Arch Linux日常、OpenAI封禁经历与对YouTube生态的疲惫感。
PewDiePie自曝失败:两年喂乌鸦计划为何翻车?
PewDiePie分享两年失败经历:试图与日本乌鸦交朋友,从喂花生到拯救倒吊乌鸦,最终被一位日本爸爸“抢走”荣耀。视频展现了与野生动物互动的真实挑战,以及创作者坦诚失败的一面。