权重没改也能恢复被编辑知识?提示空间审计新方法

Memento 用提示空间机制恢复被编辑模型 80% 的事实,揭示知识可能只是被压制。
论文提出 Memento 提示空间机制,在不修改模型权重的前提下恢复被知识编辑压制的事实。它学习一个可复用的恢复信号,支持连续前缀与离散文本提示两种形式,在三个模型和五种编辑技术上恢复了 80.07% 的留出事实,相对基线提升 9.58%。在未编辑模型上,该机制还将平均事实召回率相对标准推理提升 53.9%,说明大模型的事实知识与推理可访问性之间存在普遍差距。研究为模型审计提供了黑盒友好的新维度,可与权重空间方法互补,但恢复信号的分布外泛化性与未恢复知识的状态仍待探索。
大模型的知识编辑技术能高效更新事实性知识,但一个关键问题始终悬而未决:被编辑掉的知识是真的从模型中消失了,还是只是被压制了?近期一篇论文提出了名为 Memento 的提示空间机制,在不修改模型权重的前提下,恢复了被编辑事实的绝大部分。这项研究不仅为模型审计提供了新工具,也揭示了大模型事实知识与可访问性之间的鸿沟。
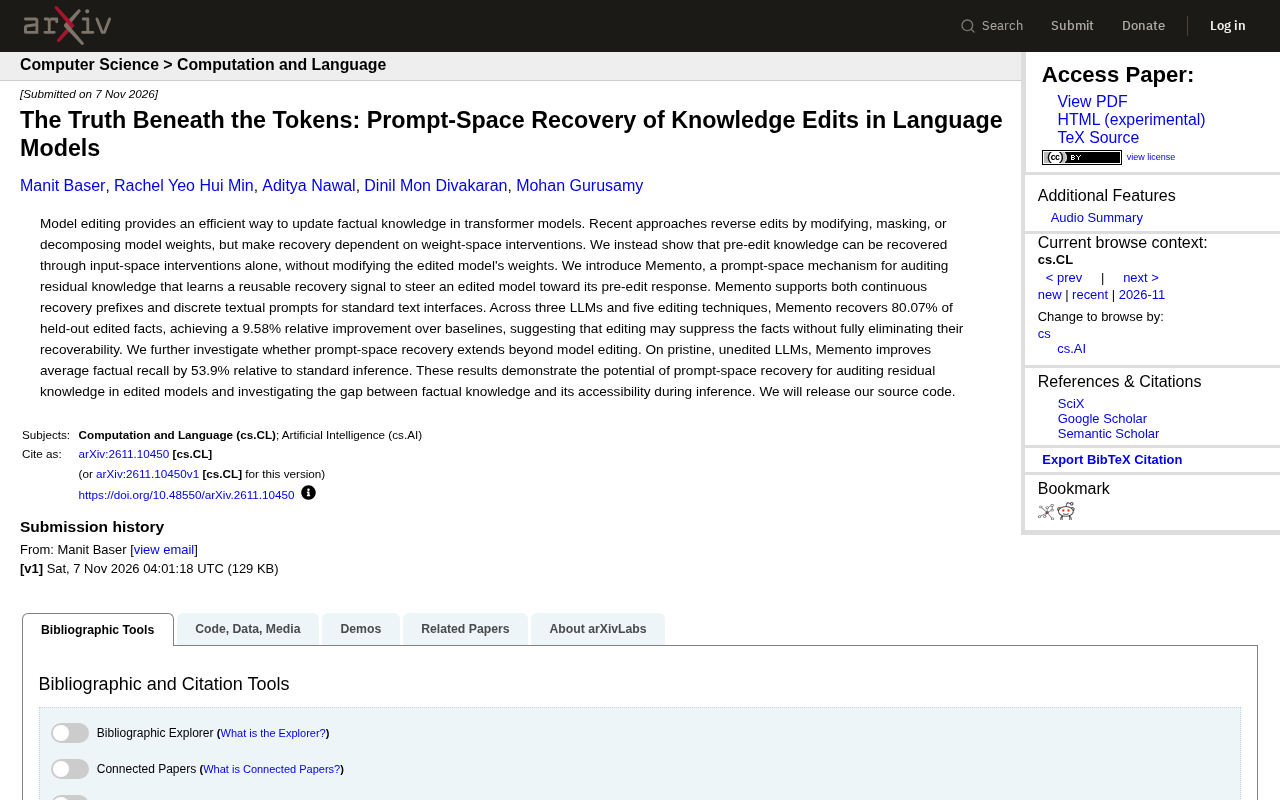
知识编辑的隐忧:改权重不等于删知识
模型编辑的目标是让 Transformer 模型快速更新特定事实,而无需重新训练。主流方法包括直接修改权重、掩码或分解权重等,这些干预都发生在权重空间。当需要撤销编辑或审计模型残留知识时,现有方法高度依赖对权重的再次干预,这在实际部署中往往不可行——权重修改可能带来副作用,且不适用于黑盒模型。
论文作者提出了一个根本性的反问:能否仅通过输入空间的干预,就恢复编辑前的知识?如果可行,说明编辑操作可能只是压制了事实,而非彻底消除其可恢复性。这一思路将知识编辑的审计从权重空间转向提示空间,降低了审计门槛。
知识编辑(Knowledge Editing) 是让预训练语言模型在不重新训练的前提下,快速修正或更新特定事实的技术方向。主流方法大致分为三类:一是参数修改型,如直接定位并改写前馈层中的键值记忆(ROME 等方法);二是元学习型,训练一个超网络来预测权重更新(如 MEND);三是外部记忆型,保留原权重并附加可检索的外部模块。这些方法的共同点是干预都发生在权重或模型结构层面,因此评估编辑是否成功通常只看编辑后的输出是否正确。Memento 所质疑的正是这种评估范式:输出正确不等于原知识已被删除,模型可能只是学会了在特定触发条件下抑制旧答案。这一区分对模型审计至关重要,因为“抑制”意味着旧知识仍可能通过其他输入路径被重新激活。
Memento:学习一个可复用的恢复信号
Memento 的核心是一个提示空间机制,它学习一个可复用的恢复信号,用来引导被编辑模型回归编辑前的回答。该机制支持两种形式:连续恢复前缀和离散文本提示。前者适用于需要精细控制的场景,后者则能直接用于标准文本接口,无需访问模型内部状态。
这种设计的巧妙之处在于,恢复信号是学习得到的,而非针对每个事实手工设计。这意味着同一套机制可以泛化到不同的事实和编辑技术。作者在三个大语言模型和五种编辑技术上验证了 Memento,结果显示它恢复了 80.07% 的留出编辑事实,相对基线提升 9.58%。这一数据表明,被编辑的事实有相当比例仍然潜藏在模型中,只是常规推理无法触及。
提示空间(Prompt Space) 指不改变模型参数、仅通过构造输入来影响模型行为的干预方式,典型代表包括软提示(soft prompt)、前缀调优(prefix tuning)和离散提示工程。与权重空间干预相比,提示空间的优势是无需访问或修改模型内部参数,因而对黑盒模型和闭源 API 同样适用。连续恢复前缀是一段可学习的向量序列,拼接在输入嵌入之前,能提供比自然语言更精细的控制信号;离散文本提示则是可直接阅读和复用的自然语言字符串,牺牲部分效果换取接口兼容性。Memento 让恢复信号在大量“编辑前—编辑后”事实对上学习,从而得到一个与具体事实无关的通用触发器,这正是它能跨事实、跨编辑技术泛化的原因。
超越模型编辑:提示空间恢复的普适性
研究进一步追问:提示空间恢复是否只对编辑过的模型有效?作者在未编辑的原始模型上测试了 Memento,发现相比标准推理,平均事实召回率提升了 53.9%。这个结果指向一个更普遍的结论:大模型的事实知识与其在推理时的可访问性之间存在显著差距,而提示空间的干预可以缩小这一差距。
换句话说,模型"知道"的比它"说出"的更多。Memento 提供了一种探查这种潜在知识的手段,对于理解模型内部表征与输出行为的关系具有方法论意义。
事实召回率(Fact Recall) 在此处指模型对一组事实性问答给出正确答案的比例,是衡量模型知识覆盖度的常用指标。标准推理通常采用直接提问或少样本提示,模型需要在一次前向传播中从参数记忆里检索出答案。当模型“知道却答不出”时,往往是因为检索路径未被激活,而非知识缺失。这一现象与知识探测(probing)研究中的发现相呼应:模型内部表征所编码的信息量,通常大于其生成输出所展现的信息量。Memento 在未编辑模型上带来的召回率提升,说明提示空间干预可以充当一种“检索线索”,把潜藏在参数中的事实引导到输出端,这为区分“知识缺失”与“知识不可访问”提供了可操作的实验手段。
对模型审计与可信部署的意义
这项研究的影响可能超出学术范畴。对于需要审计模型知识状态的场景——比如确认敏感信息是否真的被移除、评估编辑的持久性——Memento 提供了一种无需修改权重的黑盒友好方案。它提醒从业者,权重空间的编辑效果需要从输入空间进行交叉验证,仅凭编辑后的输出正常就断定知识已被删除可能过于乐观。
作者表示将开源代码,这将降低复现和后续研究的门槛。提示空间恢复作为一个新的审计维度,有望与权重空间方法形成互补,推动更可靠的知识编辑评估标准。
局限与待解问题
论文未详细讨论恢复信号在分布外事实上的泛化能力,也未说明对恶意编辑的对抗性场景是否同样有效。此外,80.07% 的恢复率意味着仍有部分事实未能恢复,这部分知识是否真正被消除,还是需要更强的恢复策略,仍有待探索。提示空间恢复的计算开销和实际部署成本也需进一步评估。
相关推荐

Hermes Agent零基础教程:自进化AI智能体实战
Hermes Agent零基础教程:详解这个GitHub两月获41.7K星的开源自进化AI智能体,从Harness Engineering核心理念、学习循环、三层记忆系统到WSL安装与实战配置,小白也能轻松上手。
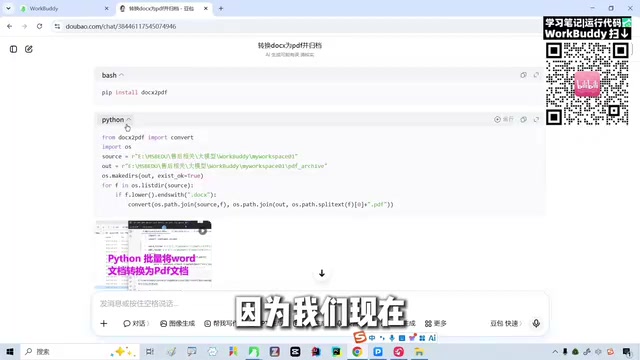
AI Agent落地实战:用WorkBuddy打造智能办公助理
本文通过实战案例演示如何用腾讯WorkBuddy完成文件批量转换与归档,对比聊天大模型与AI Agent的能力差异,分析WorkBuddy的积分体系、适用场景与产品定位,为办公自动化选型提供参考。
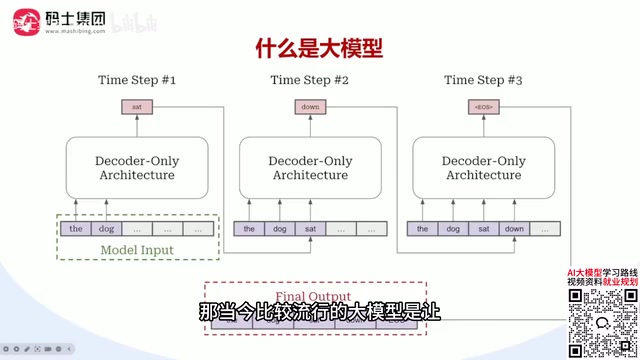
从单卡瓶颈到千亿参数:大模型分布式并行6大关键问题
基于B站教程梳理大模型分布式并行核心知识:从decoder-only架构的逐token生成与X乘W计算本质出发,解析单卡瓶颈下数据并行、张量并行、流水线并行等6个关键问题,适合私有化部署与模型训练场景的学习者建立系统认知。