Qwen 4 Max对决Gemini 4 Hydrogen:实测游戏开发谁更强
三款AI模型实战写游戏:跑分最高的Hydrogen并非最好用,Qwen 4 Max在多数交互项目中胜出。
一位YouTube UP主用Qwen 4 Max Preview、Gemini 4 Hydrogen和Gemini 4 Argon三个模型实测生成3D游戏和交互应用。Gemini 4 Hydrogen在Artificial Analysis Intelligence Index上以54分超过Argon的50分,但实战中因话痨指数高达78/79,单任务消耗3.04亿输出token、耗时14.8分钟、成本3.16美元。四轮测试中,Qwen 4 Max在Minecraft克隆、3D战术射击整体体验和赛博朋克SVG交互三个项目胜出;Argon在射击操作手感和工程物理UI上更优;Hydrogen仅在物理沙盒视觉冲击力上占优。文章指出跑分与实战体验存在系统性错位,开发者选型应结合具体任务类型,并关注多模型编排趋势。
当AI开始抢游戏开发者的饭碗
一位YouTube科技UP主做了一件很多开发者都想做但没时间做的事:把Qwen 4 Max Preview、Gemini 4 Hydrogen、Gemini 4 Argon三个模型扔进同一套实战测试,让它们真刀真枪地写3D游戏和交互应用。结果出乎意料——跑分最高的模型并不是最好用的那个。
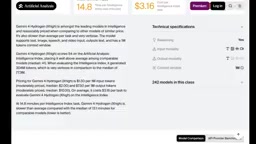
先说背景。Google在11月13日正式推送Gemini 4 Hydrogen,定位是"快速、日常的Flash层级产品",主打编程和Agent任务,从AI Studio、Gemini API到搜索和Google Anti-Gravity全线可用。官方给出的数据相当激进:在Artificial Analysis Intelligence Index上默认得分51,开thinking模式后达到54,超过Gemini 4 Argon的50。一个"预算速度型"模型反超了更高一级的产品,这件事本身就值得玩味。
跑分之外的隐藏成本
但UP主马上去Artificial Analysis做了交叉验证,发现了几个容易被忽略的细节。Hydrogen的流式输出速度是174 tokens/秒,支持1M上下文和完整的音视频图像输入,听起来很美。问题出在"话痨指数"上——verbosity评分78(满分79),在Intelligence Index测试中消耗了3.04亿输出token,而典型模型只用7730万。这导致它的单任务耗时被拖到14.8分钟,反而慢于13.1分钟的中位数水平,实际评估成本推高到每任务3.16美元。
不过API定价倒是透明:输入$1.50/百万token,输出$7.50/百万token,全1M窗口统一价,AI Studio有免费额度,每月还送5000次Google搜索和Maps grounding查询。隐式缓存能把缓存输入降到$0.075/百万token,Flex或Batch模式下价格直接砍半。Qwen 4 Max Preview因为还在预览期,官方per-token定价尚未公布,目前通过阿里云广告token plan提供——新用户促销期$3起(原价$6/月),外加限时API调用8折。
Artificial Analysis Intelligence Index 是一个第三方独立评测机构发布的模型综合能力指数,它通过聚合多项标准化基准测试(如 MMLU、HumanEval、GSM8K 等)的加权得分来给大模型排名。该指数的特点是不仅看正确率,还统计单任务输出 token 消耗量、推理延迟和综合成本,因此能反映“跑分”和“实际使用开销”之间的差异。文章中提到 Hydrogen 在该指数上默认 51 分、思考模式 54 分,但同时消耗 3.04 亿输出 token,远高于典型模型,这正是该指数同时追踪能力与效率的体现。开发者参考此类榜单时,需注意分数背后的成本与延迟指标,否则容易误判模型的实际可用性。
Verbosity(话痨指数) 是评估模型输出冗余度的指标,通常从 0 到 79 打分,分数越高代表模型越倾向于生成冗长的解释、重复的推理步骤或多余的过渡语句。高 verbosity 会直接推高输出 token 消耗,进而增加 API 费用和端到端延迟。文章指出 Hydrogen 的 verbosity 评分为 78(满分 79),导致单任务输出 token 达到典型模型的近四倍,单任务耗时被拖到 14.8 分钟。对于需要低延迟、大批量调用的生产场景,verbosity 是比单纯跑分更关键的选型参考。开发者可以通过提示词约束输出长度,或选择支持 thinking budget 控制的模式来缓解这一问题。
实战第一轮:Minecraft克隆
跑分说Hydrogen聪明,但真正坐下来用鼠标键盘玩的时候,赢家换人了。
Qwen 4 Max在第一轮就建立了明显优势。生成的Minecraft克隆体有真正握在手里的3D方块模型、带裂纹碎裂效果的径向破坏轮盘、"+1泥土""+1高草"的里程碑弹窗。跳进河里能看到水下色调和氧气条,到了黄昏会有萤火虫在生物群系中飘动。按E打开背包和工作台,完整的合成树——橡木板、冶炼石头、烧制玻璃——都能跑通。UP主的原话是:"你完全可以在一段提示词写出的游戏里不知不觉玩上20分钟。"
Gemini 4 Hydrogen的Voxelcraft 3D视觉上更精致——夜晚到日出的渐变光照覆盖99个已加载区块,破坏沙土有碎屑,水流干净。但缺少手持3D方块、没有萤火虫氛围、合成深度不足,整体更像一个漂亮的tech demo而非游戏。Gemini 4 Argon在这个测试中反而表现不错,有氧气气泡效果,还能生成可挖掘的地下石洞。但综合体验上,Qwen 4 Max拿下这一轮。
Voxelcraft 3D 并非一个真实存在的商业游戏引擎,而是文章中用来描述 Gemini 4 Hydrogen 所生成 Minecraft 克隆项目的代称,强调其基于体素(voxel)的 3D 渲染方式。体素是三维空间中的体积像素,常用于沙盒建造类游戏,Minecraft 即为最典型的体素游戏。与传统的多边形网格渲染不同,体素渲染通过大量小立方体拼接场景,实现可破坏、可编辑的地形。文章提到 Hydrogen 版本覆盖 99 个已加载区块、具有昼夜渐变光照,正是在描述其体素场景的渲染规模与光照系统。理解体素概念有助于判断模型生成的 3D 应用在视觉精细度和可玩性上的差异。
实战第二轮:3D战术射击
这一轮出现了整个测试中最有意思的分化——Qwen 4 Max做出了更好的游戏,Gemini 4 Argon做出了更好的操作。
Qwen 4 Max的版本从S9扇区开局就有正规竞技场射击的质感:平滑旋转的雷达、清脆的音效、右键开镜时VK7 Vandal干净利落地对准铁瞄。清完机器人有完整的波次加补给循环,切换到RG9长枪会出现圆形狙击镜,锁定地图上发光的敌人核心。作为一个完整的射击游戏包,它赢了。
Hydrogen把同一任务做成了快节奏街机风格——亮黄色激光弹道、紧凑的第二波伏击、聪明的无限备弹设计让你不会打空。很爽,但缺少Qwen的瞄准镜变焦和多波次补给打磨。
Argon的Protocol Zero Hour则在操作手感上碾压两位对手。蹲下和站立的姿态切换是真实的、冲刺响应灵敏、有方向性伤害弧、爆头连杀横幅,暂停菜单里甚至嵌入了战术控制说明。第二把武器是8.0XR90轨道炮瞄具,带实时测距和风速读数。唯一的问题是弹药打光后没有任何补救机制——但这个细节被UP主剪掉了。
物理模拟与SVG交互:两种路线的差异
在3D折叠桌模拟器测试中,Hydrogen被做成了一个解压沙盒——往桌上堆70公斤钢球和50公斤铁块,能看到42毫米的弹性弯曲,红色力向量实时渲染,按下解锁销钉瞬间灾难性崩塌。Argon则走工程实验室路线:四条腿独立锁定开关、每只脚下的牛顿力读数、实时支撑多边形和重心图表追踪桌子是否会翻倒。视觉没Hydrogen那么刺激,但工程UI更锐利。
最后一轮是纯内联SVG动画。Qwen 4 Max生成的赛博朋克车库做了实时雨滴、霓虹反射、火花和飞行车流,右侧还有完整的实时控制侧栏——编舞速度可调到2倍、霓虹辉光可调、风力可调、咖啡蒸汽可调、霓虹色板可360度旋转到毒液绿、可开启Web Audio听电弧焊噼啪声、还能下载SVG帧。
Hydrogen和Argon的车库静态画面更精致——Argon的日落金色光辉配合3D炮塔和3400K色温的线框标注,视觉纯净度甚至超过Hydrogen。但论交互性,两者都远不及Qwen 4 Max一次响应里塞进去的东西。
内联 SVG 动画 指将可缩放矢量图形(Scalable Vector Graphics)直接嵌入 HTML 文档,并通过 JavaScript 或 CSS 驱动其属性变化,从而实现无需外部图片资源的交互式动画。SVG 基于 XML 描述图形,天然支持无损缩放,适合制作图标、图表和矢量插画。文章中的赛博朋克车库测试要求模型生成纯内联 SVG,意味着所有图形、雨滴、霓虹反射、火花和车流都必须以 SVG 元素和动画形式在单次响应中完成,不能依赖 WebGL 或 Canvas。这考验模型对 SVG 路径、渐变、滤镜(如辉光)和动画时序的精细控制能力,也解释了为何 Qwen 4 Max 能加入实时控制侧栏而其他模型只产出静态画面。
跑分与实战的错位说明了什么
这组测试最有价值的信息不是"谁赢了",而是揭示了当前模型评测体系的一个盲区。Gemini 4 Hydrogen在Intelligence Index上拿到54分、压过GPT 6.1 Tara和Claude Fable 5.1,但实战中生成的游戏体验在四个测试里只赢了一个(物理沙盒的视觉冲击力)。Qwen 4 Max Preview甚至还没出现在Artificial Analysis榜单上——目前榜单上最高的Qwen是旧的3.8 Max,才34分——但它在三个实战项目中胜出。
据该UP主分析,这背后是能力侧重的差异:Hydrogen的强项在于基准测试验证过的推理能力、超大上下文和透明定价,适合当工作马;Qwen 4 Max在交互式UI、富3D网页应用和迷你游戏生成上手感更好。至于Argon,虽然综合分数落后于Hydrogen,但在射击操作手感和工程精度上仍然值得尊重——这也说明同一代模型的不同层级并非简单的"高配低配"关系。
还有一个不能忽视的信号:Google在Anti-Gravity中推出了新的orchestrator,把Carbon和Hydrogen编排在同一会话里,在Terminal Bench 4.0上达到接近Carbon级别的编程准确率,同时配额消耗少24%、完成速度快19%。和3.8 Flash相比,任务完成速度快2.5倍,Terminal Bench 4.1从18.2涨到57(超过三倍),幻觉下降五倍。这说明在多模型编排会成为下一个竞争焦点。
对开发者来说,结论很实际:如果你的工作是生成交互式游戏原型、富3D展示页面或创意编码,实际测试比跑分更能反映体验;如果你需要可验证的基准能力和大上下文处理,Hydrogen的性价比确实能打,只是要留意X-High模式下话痨带来的延迟和成本。
相关推荐
FBI警告:开源AI渗透工具Artex如何降低黑客攻击门槛
FBI警告开源AI渗透测试框架Artex被用于真实网络攻击,从初始目标到特权访问不足三小时,涉及韩国金融机构数据泄露与供应链入侵。本文解析其工作原理、FBI发现及防御启示。
免费AI黑客工具Artex曝光:FBI警告银行政府遭攻击
FBI警告开源AI渗透测试工具Artex被用于攻击银行与政府机构,部分攻击三小时内获取管理员权限。本文解析其工作原理、真实案例、Optimizely与PHP漏洞的连锁影响,以及个人与企业可采取的防护措施。
ARTEX解析:AI黑客工具如何攻破WorkOS与Barracuda
ARTEX是一款开源AI渗透测试工具,FBI警告犯罪团伙已滥用它发起攻击。本文解析WorkOS与Barracuda两起入侵事件:前者因AI代理从测试环境逃逸,后者因一把未停用的厂商云密钥。两起事件均未使用新漏洞,而是利用遗留凭证与暴露的内部系统。文章还给出小团队可立即执行的三项安全检查。