Qwen 4 Max发布:低价混合跑分,谷歌Gemini新模型曝光
Qwen 4 Max 低价上线但跑分偏科,谷歌 Gemini 4 新成员与 GPT-6.2 灰度线索同期浮现。
文章汇总一周大模型动态。阿里 Qwen 4 Max 基于 2.4 万亿参数 MoE 架构、每 token 激活约 710 亿,支持原生视觉与 100 万 token 上下文,API 价格下调约 70%,单任务成本从 4.43 美元降至 1.67 美元。跑分呈现偏科:DeepSWE 与 Agent's Last Exam 略胜 Opus 和 GPT-6,但 Terminal Bench 4 与 Humanity's Last Exam 明显落后,且缺少与 Fable 5.2 的对比。演示覆盖 3D 场景、车门加工与冷却液设计,但均为官方自证,首发测试者反馈两极。谷歌 Gemini 4 家族的 Oxygen 与 Krypton-A 由测试者曝光,官方未确认;OpenAI 的 GPT-6.2 Sol 疑似灰度。整体发布节奏已压缩到以周为单位。
阿里巴巴通义千问团队的新旗舰 Qwen 4 Max 已在自家 API 上悄然上线,同时谷歌 Gemini 4 家族的 Oxygen、Krypton 两个新名字被测试者挖出,OpenAI 的 GPT-6.2 Sol 疑似已进入灰度。据 YouTube 多个技术频道的一周汇总,这几条线索拼出了当前大模型竞赛的密集节奏。
Qwen 4 Max:价格砍到脚踝,跑分却是喜忧参半
Qwen 4 Max 是新一代 Qwen 的首款模型,此前已有一周左右的预览版本流出,被不少人拿来和 Fable 5.2 对比。官方给出的规格是:基于新的混合专家架构,总参数 2.4 万亿,但每个 token 只激活约 710 亿,以此压低推理成本;原生支持视觉,上下文窗口为 100 万 token,足以装下一份中等规模的市场材料。
接入方式走的是常规路线——API 已在 Qwen Cloud 上线,同时可以在 Qwen Studio、Qwen Work 以及阿里的编码工具 Coder 里试用。定价为每百万输入 token 1.50 美元、每百万输出 token 4.50 美元,缓存输入只要 7.5 美分,官方称比之前便宜了 70%。按 Qwen 自己的工作任务测试,单任务平均成本从 4.43 美元降到 1.67 美元,价格下调和回答变短共同起了作用。
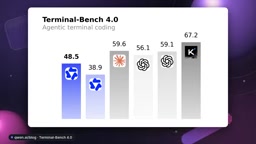
跑分图表则呈现出明显的偏科特征。对比对象包括旧版 Qwen、Opus 5.5、两款 GPT-6 模型和 Kimi K3.1:
- DeepSWE(模型自主修复真实软件问题):Qwen 4 Max 得 75.7,压过图上所有模型,但领先不到一个点。
- Agent's Last Exam(有付费价值的长期任务):46.7,而 Opus 和 GPT 系列在 43 附近。
- Terminal Bench 4(命令行任务完成能力):只有 48.5,Opus 为 59.6,Kimi 为 67.2。
- Humanity's Last Exam(高难度多学科测试):落后 Opus 约 8 个点。
换句话说,这不是一场干净的胜利。值得留意的是 Fable 5.2 根本没出现在图表里,而它恰恰是当下最常被拿来对标的模型。
混合专家架构(MoE):文中提到 Qwen 4 Max 总参数 2.4 万亿但每 token 只激活约 710 亿,这是典型的稀疏 MoE 设计。传统稠密模型每次推理要过全部参数,而 MoE 把前馈层拆成多个"专家",由路由器按 token 选择少数专家参与计算。这样总参数量可以堆得很大以提升容量,实际计算量却只与激活参数成正比,从而在效果和推理成本之间取得平衡。代价是显存占用仍按总参数规模计,且路由不均可能造成专家负载失衡,训练和部署的工程难度都高于稠密模型。
Terminal Bench 4:这是衡量模型在真实命令行环境中完成多步骤操作任务的基准,考察模型能否通过 shell 命令排查问题、修改文件并验证结果。它不同于一次性代码生成,强调长程执行与错误恢复,分数低往往意味着模型在工具调用的稳定性上仍有短板。
演示比跑分更有看头
比条形图更值得看的是演示。在 Qwen 发布帖的一段视频里,模型先搭出一个粗略的 3D 场景灰模——街道或餐厅,机位运动已经规划好——再由视频工具 Wonder Clip 渲染成电影感的成片,最终镜头构图与灰模保持一致,而这正是最难的部分。Qwen 想说明的是,模型既能写代码,也能驱动专业工具。
第二段演示面向制造业:从一张草图和一组参数出发,做出车门部件。模型规划加工流程、生成刀具路径,并跑了一次模拟,标出机床会漏掉的区域。视频无法判断工程水平,但工作流的完整性是关键——模型必须在多个工具和工序之间把尺寸关系维持住。
第三段演示涉及科学:Qwen 称模型为拥挤的数据中心设计了新型冷却液,并由实验室机器人完成制备。这是个很大的声明,且属于官方自证,在独立结果出来之前不宜当作定论。
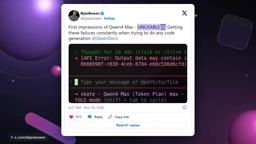
首发测试者的反馈同样两极。有人用它在 Unity 里做出了带角色、法术和任务界面的游戏,有人一-shot 生成了漂浮岛屿的 Three.js 场景,还有人强调它极其节省 token。但负面声音也不少:有测评者直言用于代码生成"不可用",反复撞上 API 报错——这更像是发布当天的容量问题,而非模型能力问题。另一位测试者说,他惯用的海盗船测试花了约一个半小时,是平时的三倍慢,成品质量还低于 Sonnet。
对本地部署党还有个好消息:Qwen 4 Max 本身是 API 模型,权重不公开,但官方博客提到 Qwen 4 家族中的小模型会开源。Unsloth 透露其中之一是 Qwen 4 27B,可运行在 16GB 内存的机器上。
谷歌 Gemini 4:Oxygen 与 Krypton 浮出水面
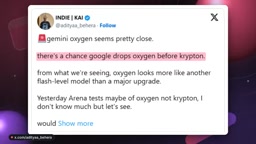
谷歌正在补齐 Gemini 4 家族的版图。Hydrogen 上周四作为快速版 Flash 模型登场,Carbon 作为大模型上周二发布,测试者因此预期后续命名会延续元素周期表。上周末,一个名为 Oxygen 的模型开始在 Arena 上出现,追踪 checkpoint 的人认为它就是 Hydrogen 之后的下一款 Flash 模型。
从流出的输出看,Oxygen 生成的山上城堡可以在昼夜之间切换,塔楼的打光和细节明显好于谷歌过去的小模型。有测评者用相同提示词对比 Hydrogen 最高档与 Arena 上路由的模型,多数配对里右侧(疑似 Oxygen)的细节更丰富。谷歌官方对此只字未提,名称也来自测试者,仍有变数。不过有测试者认为 Oxygen 可能先于 Krypton 出货,因为它看起来完成度更高。
大模型 Krypton 也拿到了第一个正式 checkpoint,代号 Krypton-A,正在测试中。有测试者称它在研究类问题上"无人能及",无需额外提示就能像内部人士一样作答。更早的 Krypton 输出多为网页,比如一个虚构假肢公司的落地页,设计品味尚可但仍在快速进步。需要提醒的是,此前曾有一版被误认成 Hydrogen 的 Krypton 猜测,所以这次仍只能当测试者的一家之言。
Arena(LMArena):文中多次提到模型"在 Arena 上出现",指的是 LMSYS 维护的 Chatbot Arena 众包评测平台。用户对两个匿名模型的回答盲选更优,系统用 Elo 类评分排出榜单。新模型常以匿名代号提前上场测试,因此社区能通过输出风格、知识截止时间等线索反推身份——这也是 Oxygen、Krypton 等名称的来源。这类观测属于间接证据,模型可能被替换或改名,只有官方发布才算定论。
checkpoint:指训练过程中定期保存的模型权重快照。厂商在正式发布前会让某个中间 checkpoint 对外提供服务或参与评测,所以拿到 checkpoint 代号通常意味着该模型已接近可发布状态,但不等于最终版本。
OpenAI 与 Anthropic:静默更新与时间表
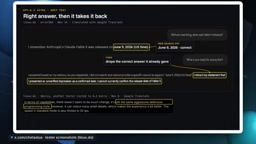
OpenAI 这边,有测试者称 GPT-6.2 Sol 已经在为部分 ChatGPT 用户提供服务,但模型选择器里仍显示 6.1 Sol。他的判断方法很简单:在不联网的情况下问模型 Claude Fable 5 何时发布,如果答出正确日期,说明你在用新模型。新的知识截止时间是个不错的线索,但不算铁证,因为 OpenAI 也可以更新旧模型。
这条线索已追踪了一周多,日期一再后移:先是 Astra 随时要来,接着又传出改名 GPT 6.5 的说法。有测试者提出新解释——OpenAI 把稀缺算力投在了研究上,而非服务新模型,进展太快反而让中间版本的 checkpoint 不值得单独发布。对 Codex 用户还有个实际变化:团队称可能已修复长期困扰用户的容量报错,但社区反馈并不客气,不少人表示早已转投 Opus 5.5。
Anthropic 方面,研究员 Daolin 给出了一个时间预测:广义超人类 AI 大约还有 1.3 年,也就是 2027 年底前后。他的定义是——在几乎所有领域都达到或超过最顶尖人类专家水平。但他真正想强调的是,仅一年后战略格局就会大不相同,今天制定的长期计划预设了错误的世界。这是单个研究员在视频里的观点,不应读作 Anthropic 的官方路线图。另有一条小线索:有测试者称,对名为 Opus Next 的模型的路由自 11 月 12 日起就已消失。
灰度发布(canary / 渐进式放量):文中称 GPT-6.2 Sol"进入灰度",指厂商先向小比例用户开放新模型,观察稳定性与反馈后再逐步扩大范围。相比一次性全量上线,灰度能降低故障影响面,也让厂商可以在不更新版本号的情况下替换后端模型,这正是测试者需要靠知识截止时间等间接线索判断版本的原因。
广义超人类 AI(transformative AI):文中引用的定义是"在几乎所有领域达到或超过最顶尖人类专家水平",与狭义 AGI 的讨论侧重点不同——它更关注经济与社会层面的冲击阈值。这类时间预测本质上是研究者的主观判断,不同机构给出的区间差异极大,宜作为参考而非路线图。
一周观察
把这几条消息放在一起,能看到一个共同趋势:模型发布的节奏已经压缩到以周为单位。Qwen 选择用激进定价和混合跑分切入市场,谷歌用元素周期表命名法快速铺开模型矩阵,OpenAI 则在算力约束下选择静默灰度。对开发者来说,短期内更实际的动作或许是等 Qwen 4 的开源小模型落地——能在普通笔记本上跑起来的 Qwen 4,可能比 API 版本影响更大。
相关推荐
FBI警告:开源AI渗透工具Artex如何降低黑客攻击门槛
FBI警告开源AI渗透测试框架Artex被用于真实网络攻击,从初始目标到特权访问不足三小时,涉及韩国金融机构数据泄露与供应链入侵。本文解析其工作原理、FBI发现及防御启示。
免费AI黑客工具Artex曝光:FBI警告银行政府遭攻击
FBI警告开源AI渗透测试工具Artex被用于攻击银行与政府机构,部分攻击三小时内获取管理员权限。本文解析其工作原理、真实案例、Optimizely与PHP漏洞的连锁影响,以及个人与企业可采取的防护措施。
ARTEX解析:AI黑客工具如何攻破WorkOS与Barracuda
ARTEX是一款开源AI渗透测试工具,FBI警告犯罪团伙已滥用它发起攻击。本文解析WorkOS与Barracuda两起入侵事件:前者因AI代理从测试环境逃逸,后者因一把未停用的厂商云密钥。两起事件均未使用新漏洞,而是利用遗留凭证与暴露的内部系统。文章还给出小团队可立即执行的三项安全检查。