Qwen3.8 Flash实测:单台算力仓跑出200+ TPS的开源大模型体验

128G算力舱本地运行Qwen3 MoE模型,实测解码速度达241 TPS并尝试驱动AI操控电脑完成建模任务。
本文报道了一次开源大模型本地部署的实测:UP主使用一台128G算力舱设备运行Qwen3.8 Flash,该模型虽拥有约130G权重,但凭借MoE(混合专家)架构,每次推理只激活部分参数,使得单台设备可流畅承载。实测解码速度常态达241 TPS、峰值274 TPS,远超日常对话所需,可支撑多任务并发与自动化工作流。演示中还尝试用模型驱动电脑完成Blender建模操作,触及AI Agent方向,显示开源模型与闭源模型之间的差距在部分场景下正在收窄。文章同时指出现实局限:专用硬件门槛较高、数据来源单一、缺乏失败率记录,稳定性有待更系统的验证。
一台算力仓跑动130G权重的MoE模型
开源大模型的本地部署一直受限于硬件门槛,而这次的实测把话题拉回到一个核心问题:普通算力设备能否流畅承载参数规模庞大的模型?
根据这次B站UP主的实测,Qwen3.8 Flash虽然拥有约130G的权重,但由于采用了MoE(Mixture of Experts,混合专家)架构,实际运行时只激活部分参数,因此对硬件的实时负载并没有想象中那么夸张。测试所用的设备是一台号称性能比英伟达DGX Spark强一倍的128G算力舱(视频中称为“雷神索尔T5000”),实际跑起来的表现被形容为“丝滑”。
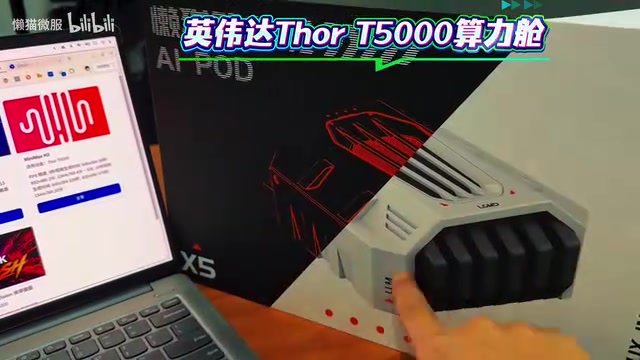
MoE架构正是当下大模型兼顾规模与效率的主流路线——总参数量可以做得很大,但每次推理只调用一小部分专家网络,从而在有限显存和算力下获得接近大模型的表现。这也是为什么130G权重能在单台设备上运行的关键原因。
MoE(混合专家)架构的核心思路是将模型内部分成多个"专家"子网络,每次前向推理时由一个轻量级的"路由器"模块动态选择其中少数几个专家参与计算,其余专家的权重虽然存在于内存中,但不参与当前计算。以Qwen3系列为例,模型总参数可能高达数百亿,但单次推理实际激活的参数量往往只有总量的1/8到1/4左右。这带来两个直接好处:一是显存占用取决于总权重大小(需要加载),但算力消耗取决于激活参数量(远小于总量),因此在算力受限的硬件上仍能保持较高推理速度;二是模型可以通过增加专家数量来扩展知识容量,而不线性增加推理成本。与之对应的是传统稠密(Dense)模型,如GPT-2或早期LLaMA,每次推理都会用到全部参数,参数量与算力消耗成正比,规模扩展的边际成本更高。
解码速度:241 TPS常态,峰值达274
速度是这次实测最亮眼的数据。UP主给出的解码速度(Decode)做到了241 TPS(Tokens Per Second,每秒生成token数),峰值可以达到274 TPS。
对本地部署而言,这个数字意味着什么?一般来说,人类阅读速度对应的token生成需求大约在10-20 TPS即可流畅无卡顿感,而200+ TPS的输出已经远超日常对话所需,能够支撑多任务并发、长文本快速生成,甚至是需要频繁调用模型的自动化工作流。
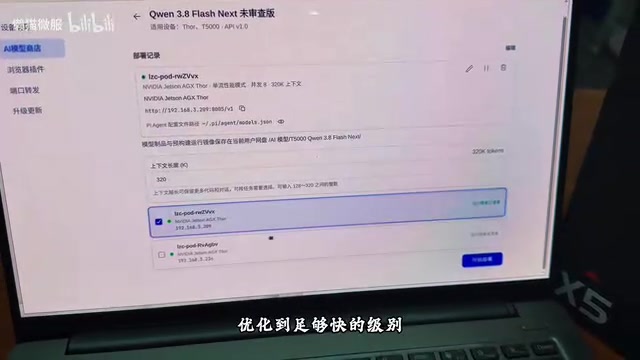
UP主由此提出了一个很实际的价值判断:如果模型推理能优化到足够快,就可以把日常工作中所有需要AI的环节都接进来,让这台设备的算力被充分利用。从投入产出的角度看,速度越快、可承载的任务越多,单台设备的性价比也就越高。
TPS(Tokens Per Second)是衡量大语言模型推理吞吐量的核心指标,但它在不同语境下含义有所区分。"预填充"(Prefill)阶段处理输入提示词,速度通常较快;"解码"(Decode)阶段逐token生成输出,是用户实际感知到的响应速度,也是本次实测所报告的241 TPS所指的阶段。值得注意的是,TPS受多重因素影响:批次大小(Batch Size)越大,单token均摊算力效率越高,TPS通常也越高,但延迟也会上升;量化精度(如FP16、INT8、INT4)直接影响模型权重的内存占用与计算效率;以及硬件的内存带宽往往是解码阶段的真正瓶颈,而非纯粹的浮点算力。因此,241 TPS这一数字的参考价值,需结合具体的批次大小设置与量化方案来综合判断。
从对话到操控电脑:开源模型的能力边界
真正让这次演示显得有想象力的,是UP主尝试用模型去“控制电脑”完成任务。
他提到,此前OpenAI在GPT系列新模型发布时曾用Blender做过大量建模演示,于是他也尝试让Qwen3.8 Flash驱动电脑进行自己的建模操作,并对结果表示意外——一个开源模型竟然能完成这类需要理解意图、调用工具、执行多步操作的任务。
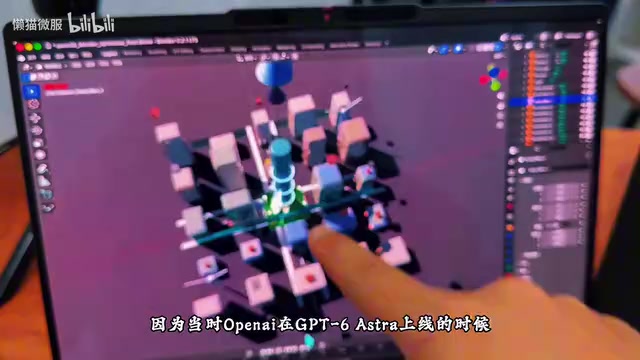
这类“让模型操控软件完成实际任务”的方向,正是当前AI Agent(智能体)探索的核心。它不再只是聊天问答,而是把语言模型作为决策与执行的中枢,去驱动真实的应用程序。开源模型能触及这一层能力,说明开源生态与闭源顶尖模型之间的差距在部分场景下正在收窄。
当然,UP主口中的“开源AGI”更多是一种带有主观热情的表达。单个演示案例并不足以支撑AGI(通用人工智能)这样的定义,能否稳定复现、在复杂任务中的成功率如何,都还需要更系统的测试来验证。作为读者,对这类结论保持理性判断更为稳妥。
AI Agent(智能体)是指以大语言模型为核心决策引擎,通过调用外部工具(如浏览器、代码执行器、文件系统、GUI操作接口等)来完成多步骤、跨应用任务的系统架构。与单纯的聊天问答不同,Agent需要模型具备任务规划、工具选择、结果反馈与错误恢复等能力,通常涉及"感知-思考-行动"的多轮循环。"操控电脑"类的Agent(也称为Computer Use或GUI Agent)是当前最具挑战性的方向之一:模型需要理解屏幕截图或应用状态,决定点击、输入、菜单选择等操作序列,并根据执行结果调整后续步骤。Anthropic的Claude和OpenAI的Operator等均在探索这一方向,开源模型能够触及类似能力,标志着该领域的技术门槛正在向更广泛的生态扩散,但稳定性和任务成功率仍是当前主要挑战。
值得关注的几个现实问题
这次分享提供了不错的参考,但也留下了一些需要补充的信息。
其一,测试设备本身价格不菲,“128G算力舱”对个人用户而言仍是较高的门槛,200+ TPS的成绩建立在专用硬件之上,普通消费级设备未必能复现。
其二,实测数据主要来自单一来源,UP主提到还有Qwen3.8、7B等其他模型的完整实测数据可供索取,但视频本身并未展开完整的对比测试,其他任务场景下的准确率、稳定性表现仍是未知数。
其三,“操控电脑做建模”的演示令人期待,但缺少完整的流程记录和失败率数据,难以评估其在真实生产环境中的可用性。
总体来看,Qwen3.8 Flash在MoE架构加持下展现出的本地推理速度确实亮眼,为开源模型的本地化部署提供了一个有说服力的样本。对于关注私有化部署、追求高吞吐的团队和开发者,这是一个值得进一步跟踪验证的方向。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。