RAG与Agentic AI可专利方向:三个实用选题思路

从一个真实的求助说起
近日,一位开发者在 Reddit 上发帖求助,希望社区帮忙寻找一个合适的项目选题。他的需求非常具体:题目应当涵盖 RAG(检索增强生成) 或 Agentic AI(智能体AI),结合 深度学习(NLP 为可选项),并且要具备可专利性,同时明确排除医疗健康领域。
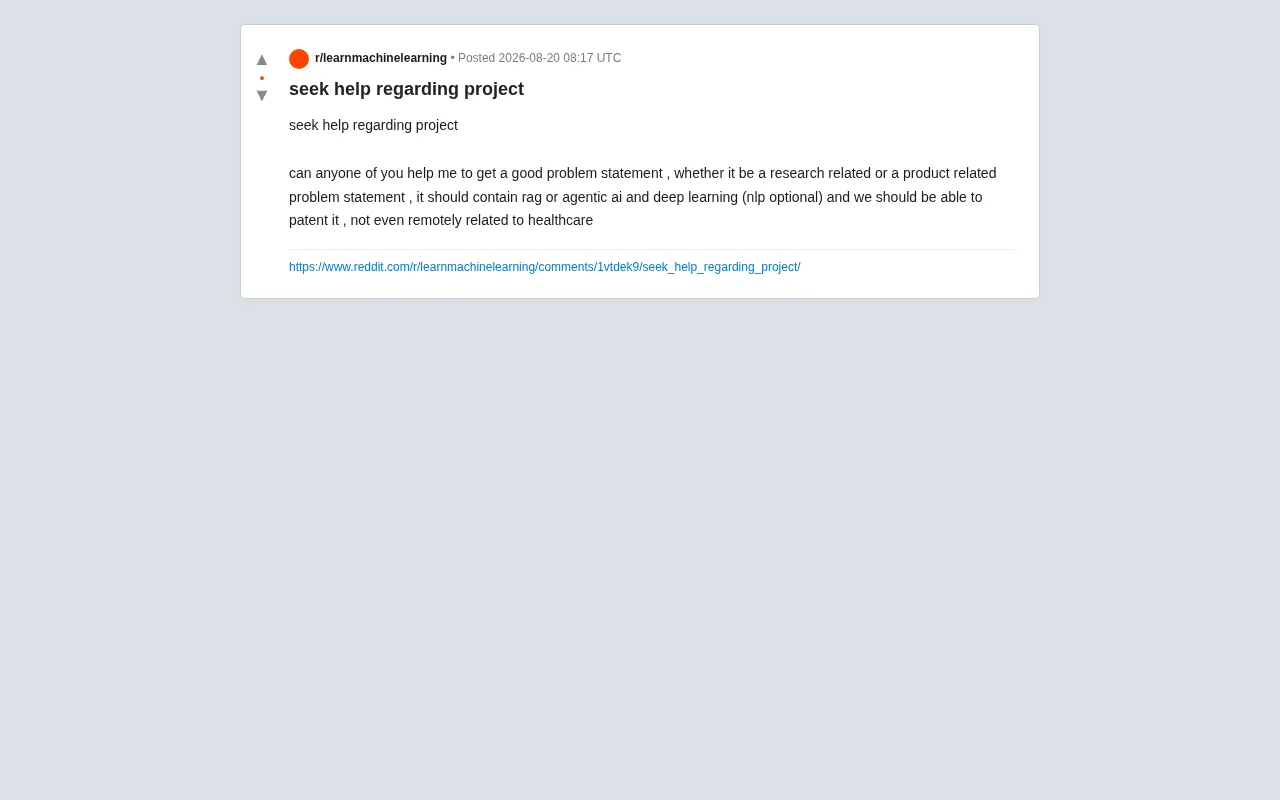
这个看似简单的求助,实际上折射出当下许多 AI 从业者和研究生面临的共性困境:技术栈选定之后,如何找到一个既有技术深度、又具备商业或学术价值、还能满足知识产权保护条件的切入点。本文将围绕这一命题,梳理 RAG 与 Agentic AI 领域的可专利选题思路框架。
理解AI专利的核心门槛:什么样的项目才能申请专利
在为 AI 项目寻找选题之前,首先要明白"可专利"意味着什么。软件与算法类专利在全球范围内的审查标准存在差异,但通常需要满足三个基本条件。
值得注意的是,这些标准在不同司法管辖区有着显著差异。美国专利商标局(USPTO)在 2014 年经历 Alice Corp. v. CLS Bank 这一里程碑案例后,对"抽象概念"的专利保护设置了更高门槛,要求申请者证明其方案包含超越抽象概念本身的"发明性概念"(inventive concept)。Alice 案确立的两步测试法(Alice Test)至今仍是美国AI专利审查的核心框架:第一步判断专利权利要求是否指向抽象概念、自然法则或自然现象;第二步判断权利要求中是否包含将抽象概念转化为可专利发明的"发明性概念"。这意味着,一项仅描述"使用神经网络对数据进行分类"的专利申请大概率会被驳回,但如果申请者能证明其网络架构在特定场景下实现了显著的性能突破或资源优化,则可能通过审查。这一判决对AI领域影响深远,迫使从业者在专利申请中必须突出具体的技术实现细节而非抽象的算法思路。
Alice案的深远影响不仅限于美国本土。该案涉及CLS Bank的一项电子托管交易系统专利,美国最高法院以9-0的一致裁定认为该专利仅是对抽象概念(中介结算)的计算机化实现,不具备可专利性。此后,美国联邦巡回上诉法院(CAFC)在后续AI相关案件中进一步细化了Alice Test的适用标准。例如在Enfish v. Microsoft (2016)案中,法院认定一种自引用数据库表结构属于对计算机功能本身的改进而非抽象概念,从而通过了Alice Test的第一步。这为AI专利申请者提供了重要参考:如果能证明发明改善了计算机系统本身的技术能力(而非仅将人类活动搬到计算机上),则更可能获得专利保护。
欧洲专利局(EPO)则明确将"计算机程序本身"排除在可专利范围之外,但如果软件方案产生了"进一步的技术效果"——例如改善了计算机系统的运行效率或解决了具体的技术问题——则可以获得保护。中国国家知识产权局(CNIPA)近年来对 AI 相关专利持较为开放的态度,2019 年修订的《专利审查指南》进一步放宽了对包含算法特征的发明专利申请的审查标准。理解这些差异,对于一开始就以"可专利性"为约束条件的选题至关重要。
新颖性与非显而易见性
专利要求技术方案是前所未见的,并且对本领域的普通技术人员而言并非显而易见。这意味着单纯调用现成的 RAG 框架(如直接组合 LangChain + 向量数据库)很难构成可专利的创新点,因为这属于常规工程组合。
这里有必要解释为什么这种组合被视为"常规"。LangChain 是目前最流行的 LLM 应用开发框架之一,由 Harrison Chase 于 2022 年创建,提供了链式调用(Chain)、智能体(Agent)、记忆(Memory)等模块化组件。向量数据库(如 Pinecone、Weaviate、Chroma、Milvus 等)则专门用于存储和检索高维向量嵌入,是 RAG 系统的核心基础设施。向量嵌入技术将文本、图像等非结构化数据转换为高维数值向量,使得语义上相似的内容在向量空间中具有较近的距离。常用的文本嵌入模型包括 OpenAI 的 text-embedding 系列、Sentence-BERT、以及开源的 BGE 系列模型。相似度搜索通常基于余弦相似度或欧氏距离等度量方式,为了在大规模数据上实现毫秒级检索,向量数据库普遍采用近似最近邻(Approximate Nearest Neighbor, ANN)算法,如 HNSW(Hierarchical Navigable Small World)和 IVF(Inverted File Index)。
HNSW 算法由 Yuri Malkov 等人于 2016 年提出,其核心思想是构建一个多层级的图结构,底层包含所有数据点,越往上层节点越稀疏,形成类似跳表的层级导航结构。搜索时从最高层开始贪心地向目标靠近,逐层下降直至底层找到最近邻。这种设计使得搜索复杂度为 O(log n) 级别,在百万至十亿级数据集上可实现毫秒级响应。IVF 则通过先将向量空间划分为多个聚类(通常使用 k-means),搜索时仅在目标向量最可能所属的少数几个聚类中进行精确搜索,从而大幅缩减搜索范围。不同的 ANN 算法在召回率、查询延迟和内存消耗之间存在不同的权衡,选择合适的算法和参数调优本身就是工程实践中的重要课题。
由于这些工具和技术已经高度标准化,直接按照官方文档的标准流程搭建一个 RAG 应用,在专利审查中很可能被视为"本领域技术人员的常规选择",无法满足非显而易见性的要求。然而,在检索精度、索引效率和存储优化等底层环节的改进,往往蕴含着真正的创新空间。
真正可专利的往往是某个具体的技术改进——例如一种新的检索排序机制、一种降低智能体幻觉的验证架构,或一种针对特定数据结构的分块与索引策略。
技术效果的可量化
专利申请通常需要证明该方案带来了可衡量的技术改进,比如降低推理延迟、减少 token 消耗、提升检索准确率等。因此在选题阶段就应当考虑:这个创新能否用实验数据支撑其优越性?
理解核心技术:RAG 与 Agentic AI 的技术背景
在进入具体选题方向之前,有必要对这两个核心技术范式做更深入的理解。
RAG(检索增强生成) 是 2020 年由 Facebook AI Research(现 Meta AI)在论文中正式提出的技术范式,其核心思想是将大语言模型的生成能力与外部知识库的检索能力相结合。传统的大语言模型在回答问题时完全依赖训练阶段记忆的参数化知识,这导致了知识截止日期、幻觉生成和领域知识不足等问题。RAG 通过在推理阶段引入一个检索模块——通常基于向量相似度搜索——从外部文档库中提取相关片段,再将这些片段作为上下文注入生成模型的提示中,从而让模型的回答有据可依。当前主流的 RAG 实现链路通常包含文档分块、向量嵌入(Embedding)、向量数据库存储、相似度检索和上下文增强生成五个环节。
值得注意的是,RAG 中的幻觉问题(Hallucination)仍是一个核心挑战。幻觉是指大语言模型生成看似合理但实际上不准确或完全虚构内容的现象。在 RAG 系统中,幻觉可能以多种形式出现:模型可能忽略检索到的上下文而依赖自身参数化知识生成答案(忠实度不足),可能错误地综合多个检索片段的信息导致"交叉污染",或者在检索结果不充分时"脑补"缺失的细节。研究表明,即使在提供了正确上下文的情况下,前沿模型仍有一定概率生成与上下文矛盾的内容。减少幻觉的技术手段包括检索结果的重排序(Re-ranking)、基于自然语言推理(NLI)的事实一致性验证、以及生成后的自我反思(Self-Reflection)机制。这些防幻觉策略的每一种具体实现方式都可能构成独立的创新点和专利机会。
Agentic AI(智能体AI) 是 2023-2024 年间迅速崛起的技术范式,它将大语言模型从被动的问答工具升级为具备自主规划、工具调用和多步推理能力的智能体。与传统的单轮提示-响应模式不同,智能体能够将复杂任务分解为子任务、调用外部 API 和工具、根据中间结果动态调整执行策略,并在多轮交互中保持状态连贯性。代表性框架包括 AutoGPT、CrewAI、LangGraph 等。Andrew Ng 在 2024 年初将 Agentic AI 列为年度最重要的技术趋势之一,认为即使使用较弱的基础模型,通过智能体架构也能在复杂任务上超越单次调用更强模型的表现。
智能体的工具调用能力很大程度上得益于 OpenAI 在 2023 年引入的 Function Calling 功能,该功能允许模型以结构化 JSON 格式输出工具调用请求,而非自由文本。这一机制使得 LLM 能够可靠地与外部 API、数据库、计算引擎等工具交互。在此基础上,ReAct(Reasoning + Acting)框架由 Yao 等人于 2022 年提出,将推理(Thought)和行动(Action)交替进行,模型先生成推理步骤解释自己的思考过程,再决定调用哪个工具以及使用什么参数,观察工具返回结果后继续推理。这种思维链(Chain-of-Thought)与工具使用的结合,已成为当前智能体架构的基础范式。
多智能体系统(Multi-Agent System, MAS)的概念实际上最早可追溯到 1980 年代的分布式人工智能研究,但在大语言模型时代获得了全新的表达形式。当前的 LLM 多智能体架构通常包含几种协作模式:层级式(一个编排智能体分配任务给下属智能体)、对等式(智能体之间平等协商)、以及竞争式(多个智能体独立生成方案后投票选择最优)。斯坦福大学 2023 年的"Generative Agents"研究展示了 25 个 LLM 驱动的智能体在虚拟小镇中自主交互的场景,微软的 AutoGen 框架则提供了灵活的多智能体对话编程接口,CrewAI 在 2024 年迅速流行,其核心设计理念是为每个智能体赋予明确的"角色"、"目标"和"背景故事"。多智能体系统当前面临的核心挑战包括通信开销、状态同步、冲突消解和成本控制,每一个挑战都对应着潜在的技术创新方向。
理解这两个范式各自的能力边界和技术瓶颈,是发现可专利创新点的前提。
三个不涉及医疗的RAG与Agentic AI可专利选题方向
结合发帖者的约束条件,以下提供几个具备可专利潜力的参考方向。
方向一:面向法律合规文档的可溯源RAG系统
法律、合同与合规领域的文档具有高度结构化、术语密集、且对答案可追溯性要求极高的特点。一个可能的创新点是构建一套带引用溯源与置信度评估的 RAG 架构——不仅生成答案,还能自动标注每个论断对应的原文条款位置,并给出可信度评分。
这里的可专利点在于:如何设计一种证据链验证机制,使得智能体在生成回答前必须通过检索片段的交叉校验。这种"生成-验证-回溯"的闭环结构,若在实现方式上有独特设计,具备申请专利的潜力。具体而言,可以设想一种架构:系统首先基于用户问题检索多个相关法律条款片段,然后由生成模块基于这些片段生成初步答案,接着由一个独立的验证模块逐句检查生成内容与源文档之间的事实一致性(例如通过自然语言推理模型判断"蕴含/矛盾/中立"关系),对于无法溯源的论断进行标记或删除,最终输出带有逐句引用标注和置信度分数的结构化回答。
自然语言推理(NLI)是 NLP 中的基础任务之一,目标是判断两个文本之间的逻辑关系:前提(Premise)是否蕴含(Entailment)假设(Hypothesis),是否与之矛盾(Contradiction),还是两者无关(Neutral)。经典的 NLI 数据集包括 SNLI(斯坦福自然语言推理数据集,约 57 万样本对)和 MultiNLI。在 RAG 溯源验证中,检索到的原文片段作为前提,生成的每句回答作为假设,NLI 模型判断每句生成内容是否被源文档所支持。近年来,基于 DeBERTa 架构微调的 NLI 模型在多个基准上达到了接近人类水平的准确率。微软的 TRUE 基准和 Google 的 SAFE 框架进一步推动了事实一致性验证方法的标准化。将 NLI 模型深度集成到 RAG 生成管道中作为实时约束机制,而非仅用于事后评估,这种架构设计本身就蕴含着独特的创新价值。
这种机制直接回应了前文提到的 RAG 幻觉问题,将其从"事后检测"推进到"生成过程中的实时约束"。
方向二:多智能体协作的代码库理解与重构工具
软件工程领域是 Agentic AI 的天然试验场。可以设计一个多智能体系统,让不同角色的智能体(如"检索智能体""依赖分析智能体""重构建议智能体")协同理解大型代码库,并给出跨文件的重构方案。
创新点可以聚焦于智能体之间的任务分解与冲突消解协议——当多个智能体给出矛盾建议时,如何通过一种仲裁机制达成一致。这类协作协议的具体实现,往往是可专利的核心。例如,"依赖分析智能体"可能建议保留某个函数以维持向后兼容性,而"重构建议智能体"则认为该函数应当被替换为更高效的实现。
仲裁机制可以借鉴分布式系统中的共识算法思想。Raft 共识算法由 Diego Ongaro 和 John Ousterhout 于 2014 年提出,旨在成为 Paxos 的更易理解的替代方案。其核心机制包括领导者选举(Leader Election)、日志复制(Log Replication)和安全性保证。在多智能体代码重构场景中,可以借鉴 Raft 的领导者机制——由一个仲裁智能体充当"领导者",收集各专业智能体的建议后做出最终决策。但与传统分布式系统不同,LLM 智能体的"投票"不是二进制的同意/拒绝,而是包含丰富语义信息的推理论证,因此需要设计更复杂的聚合机制来评估每个建议的技术可行性、风险级别和预期收益。这种从确定性共识到语义级共识的扩展,正是可专利创新的方向所在。
基于这一思路,可以设计一种基于优先级权重、影响范围评估和回滚成本计算的多因子决策框架。此外,每个智能体的"推理轨迹"(reasoning trace)如何被记录、传递和整合,也是一个具有技术深度的设计问题——这关系到系统的可解释性和可审计性,在企业级代码库管理中具有直接的商业价值。
方向三:工业级知识库的自适应分块与索引策略
RAG 系统的效果高度依赖文档的分块(chunking)策略。目前多数方案采用固定长度或简单语义分块。一个更具深度的方向是设计一种依据文档结构与查询模式动态调整分块粒度的深度学习模型。
要理解这个方向的创新空间,需要先了解当前分块方法的局限。主流的分块方法包括:固定长度分块(按字符数或 token 数切分)、基于分隔符的分块(如按段落、章节标题切分)、递归字符分块(LangChain 中的 RecursiveCharacterTextSplitter)、以及语义分块(通过计算相邻句子的嵌入相似度来判断语义边界)。每种方法都有其局限性:固定长度分块会破坏语义完整性,语义分块则计算开销较大且对嵌入模型质量高度敏感。2024 年,Greg Kamradt 提出的基于嵌入相似度断点的语义分块方法引发了广泛关注,但在面对多层级结构文档(如法律法规、技术规范)时仍然表现不佳。这为自适应分块策略的研究留出了广阔的创新空间。
通过训练一个轻量级模型预测最优分块边界,并根据历史查询反馈持续优化索引结构,这种"自适应分块"若能证明其在检索准确率上的显著提升,便同时满足了深度学习、RAG 和可专利三个条件。更具体地说,该模型可以采用序列标注(Sequence Labeling)的思路,将文档中的每个位置标注为"分块边界"或"非边界",训练数据可以通过下游检索任务的反馈自动构建:当某种分块方式导致检索结果更准确时,对应的分块边界被标注为正样本。这种端到端的、查询感知的分块优化方法,目前在公开文献和专利数据库中尚未看到成熟的实现。
从选题到落地的实操建议
对于发帖者这样的项目发起者,以下几点务实建议值得参考。
第一,先做文献与专利检索。 在确定方向后,务必通过 Google Patents、arXiv 等平台确认该思路是否已被占据。除了 Google Patents 之外,还应关注以下资源:USPTO 的 PATFT 和 AppFT 数据库可以搜索美国已授权专利和公开申请;Espacenet 是欧洲专利局提供的免费检索工具,覆盖全球超过 1.3 亿件专利文献;CNIPA 的专利检索系统则是了解中国 AI 专利布局的必备工具。在 AI 领域,建议采用 CPC 分类号(Cooperative Patent Classification)进行精准检索,AI 相关专利主要集中在 G06N(计算机系统基于特定计算模型)和 G06F 16/00(信息检索)等类别下。此外,Semantic Scholar 和 Connected Papers 等工具可以帮助追踪学术论文中的技术方案是否已被转化为专利申请。一个实用的做法是先在 arXiv 上检索相关论文,再以论文作者或机构为线索在专利数据库中交叉验证。这一步既能避免重复造轮子,也能帮你精准定位真正的创新空白。
第二,缩小范围而非贪大求全。 一个聚焦的、能被清晰界定的技术问题,远比一个宏大模糊的目标更容易做出可专利的成果。以本文提到的三个方向为例:与其泛泛地说"做一个法律 AI",不如精准定义为"设计一种基于 NLI 模型的 RAG 生成内容逐句溯源验证方法";与其说"做多智能体代码重构",不如聚焦到"一种基于优先级权重的多智能体代码修改冲突消解协议"。这种精准的问题定义不仅有利于专利权利要求的撰写,也使得研究目标更加可执行。
第三,重视实验设计。 无论是学术还是专利,可复现的实验数据都是硬通货。在选题时就应规划好评测基准(benchmark)和对比基线(baseline)。对于 RAG 相关的创新,常用的评测指标包括检索召回率(Recall)、精确率(Precision)、答案的忠实度(Faithfulness)和相关性(Relevance)。RAGAS(Retrieval Augmented Generation Assessment)是 2023 年由 Shahul Es 等人提出的一套专门针对 RAG 系统的自动化评测框架,已成为该领域的事实标准之一。RAGAS 提供了四个核心评测维度:忠实度(Faithfulness,衡量生成答案是否与检索上下文一致)、答案相关性(Answer Relevancy,衡量答案是否切题)、上下文精确率(Context Precision,衡量检索结果中相关片段的排名位置)和上下文召回率(Context Recall,衡量回答所需信息是否被检索到)。RAGAS 的一个重要特点是它无需人工标注的参考答案即可进行评估,而是利用 LLM 本身来判断生成质量,这使得大规模自动化评测成为可能。除 RAGAS 外,TruLens 提供了基于反馈函数的 RAG 评测方法,DeepEval 则整合了多种评测指标并支持回归测试。
对于多智能体系统,则需要设计能够衡量任务完成质量、协作效率和资源消耗(如总 token 使用量、API 调用次数)的综合评测方案。选择合适的评测框架并设计有说服力的实验方案,是将技术创新转化为可发表论文或可申请专利的关键环节。
结语
寻找一个兼具技术深度与专利价值的 AI 选题,本质上是在已知技术栈的交叉地带寻找尚未被充分解决的具体问题。RAG 与 Agentic AI 目前仍处于快速演进期,其在检索可信度、多智能体协作、自适应索引等方向都存在大量工程与理论空白。与其向社区索要现成题目,不如以这些方向为起点,结合自身兴趣与资源,深入挖掘一个能真正推进的细分问题。
核心要点
核心要点
相关推荐
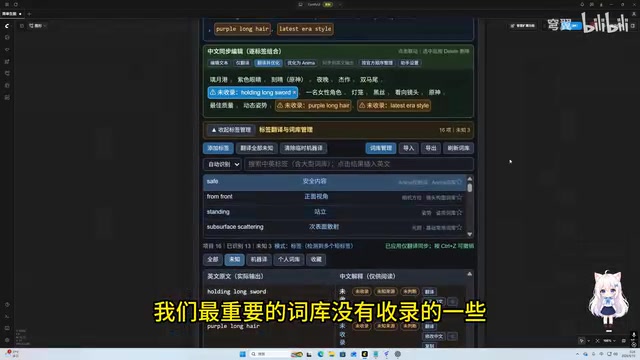
ComfyUI双语提示词节点实测:不懂英文也能玩转标签
一位B站UP主借助GPT打造的ComfyUI双语标签提示词拓展节点实测:中英标签双向联动、30万词库支持、未知标签一键翻译沉淀,让不懂英文的小白也能玩转提示词,目前适配anima本地部署模型。
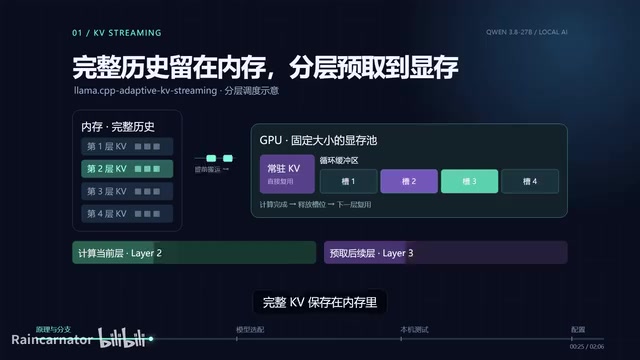
16G显存跑Qwen3 27B:192K上下文+视觉实测
在16G显存显卡上部署Qwen3 27B模型,通过llama.cpp Adaptive KV Streaming实现192K超长上下文与视觉能力。本文详解KV缓存瓶颈原理、量化版本选择及RTX 5080实测速度与任务能力。
MiniMax H3本地部署实测:开源视频模型效果与完整教程
MiniMax H3 开源视频模型本地部署实测:涵盖硬件要求、ComfyUI 完整部署教程,以及文生视频、图生视频的真实生成效果与耗时,适合想入门本地 AI 视频生成的用户参考。