深入解析Argon 4安全与对齐工作总结
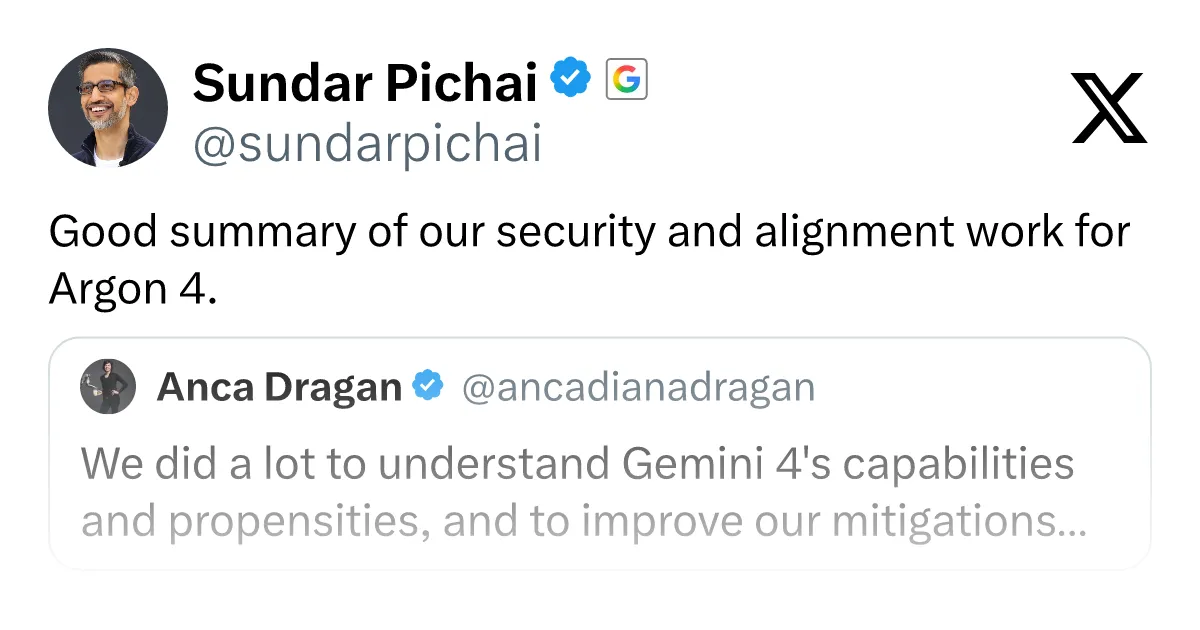
由一条推文出发,梳理Argon 4在安全与对齐方面的工作逻辑与行业意义。
文章以一条评价Argon 4安全与对齐工作的推文为线索,系统阐释了这一领域的核心概念。作者首先区分安全(抵御攻击、防止滥用与泄露)与对齐(模型行为符合人类意图与价值观)两个维度,指出二者在Argon 4中被视为同等重要的支柱。安全方面可能涉及对抗性测试、红队演练、访问控制与模型行为监控,需应对模型窃取、提示注入、数据投毒等新型威胁;对齐方面则可能包括RLHF、可解释性研究与部署后持续评估,且对齐是贯穿模型生命周期的持续过程而非一次性任务。文章肯定该总结的参考价值,同时指出推文信息量有限,缺乏技术细节与量化结果,建议读者追踪官方技术报告或论文以获取威胁模型、评估指标与对齐方法的完整图景。
引言
近日,一条推文对Argon 4在安全与对齐方面的工作进行了总结。虽然推文本身简短,但涉及的领域——AI安全与对齐——正是当前人工智能发展中最关键也最复杂的议题之一。本文将从这条线索出发,系统梳理Argon 4可能涵盖的安全与对齐要点,并分析这些工作背后的技术逻辑与行业意义。
理解Argon 4的安全框架
从推文内容看,“security and alignment work for Argon 4”表明Argon 4是一个受到安全与对齐双重约束的系统或项目。在AI语境下,安全(security)通常指向系统抵御外部攻击、防止滥用和数据泄露的能力;对齐(alignment)则关注模型行为是否符合人类意图与价值观。这两个维度共同构成了一个可信AI系统的基础。
据推文描述,该总结“good”,暗示工作成果值得肯定。结合行业惯例,Argon 4的安全工作可能涉及对抗性测试、红队演练、访问控制与模型行为监控;对齐工作则可能包括基于人类反馈的强化学习(RLHF)、可解释性研究以及部署后的持续评估。
RLHF(基于人类反馈的强化学习) 是当前大模型对齐的主流技术路径,理解它有助于把握 Argon 4 对齐工作的技术定位。其流程通常分三步:先由标注人员对模型的多条输出按质量或安全性排序,训练出一个奖励模型(reward model);再以该奖励模型为信号,用强化学习算法(如 PPO)优化语言模型策略;最后通过迭代采样与再标注持续修正。RLHF 的核心价值在于把"人类偏好"这一难以直接编码的目标转化为可优化的标量信号,从而让模型学会拒绝有害请求、保持有用与诚实。但其局限同样明显:奖励模型可能被"过度优化"(reward hacking),标注者偏好存在偏差,且对齐效果高度依赖反馈数据的覆盖面。因此业界常将 RLHF 与监督微调、规则约束、宪法式 AI 等方法组合使用。
安全与对齐的行业实践
安全:从防御到韧性
现代AI系统的安全已不再局限于传统的网络安全边界。对于类似Argon 4的系统,安全团队需要应对模型窃取、提示注入、数据投毒等新型威胁。推文中将“security”与“alignment”并列,说明二者在Argon 4中被视为同等重要的支柱。
你可能没注意到,安全工作的评估往往依赖红队测试和漏洞赏金计划,这些机制能够暴露系统在真实攻击场景下的弱点。虽然推文未提供细节,但“good summary”的定性评价暗示相关工作已形成体系化输出。
文中提到的提示注入(prompt injection) 值得单独说明,因为它是大模型应用特有的攻击面。与 SQL 注入类似,攻击者通过在输入中嵌入精心构造的指令,诱使模型偏离系统预设的角色或安全策略,例如让本应只回答客服问题的助手泄露系统提示词、执行越权操作,或绕过内容过滤。间接提示注入更进一步:恶意指令被藏在模型将要读取的外部内容(网页、文档、邮件)中,用户本身并无恶意却触发攻击。由于 LLM 无法像传统程序那样严格区分"指令"与"数据",这类攻击难以靠单一过滤器根除,通常需要输入输出双向检测、权限最小化、工具调用白名单等纵深防御手段配合。数据投毒则指在预训练或微调数据中掺入恶意样本,使模型习得后门行为,其防御依赖数据溯源与训练集审计。
对齐:从原则到可操作
对齐工作的难点在于将抽象的价值观转化为可测量的训练目标。Argon 4若涉及大语言模型,其对齐策略可能包含监督微调、偏好建模与拒绝有害请求的机制。推文作者对总结的认可,或许反映了这些机制在实际测试中表现出了预期效果。
行业内的共识是,对齐不是一次性任务,而是贯穿模型生命周期的持续过程。从预训练数据筛选到部署后的用户反馈循环,每个环节都需要对齐考量。Argon 4的工作总结若覆盖了这些环节,其价值将超出单个项目,为同类系统提供参考。
可解释性研究在对齐工作中承担"诊断"角色,是理解 Argon 4 类项目对齐策略的重要背景。机制可解释性试图从神经元、注意力头、激活向量等内部结构层面还原模型的计算过程,例如定位负责拒绝有害请求的特定方向或回路;行为可解释性则通过探针、因果干预等实验检验模型输出背后的真实依据。可解释性之所以与对齐紧密相关,是因为仅靠外部行为测试无法确认模型是"真正理解并遵守"规范,还是仅学会了表面模仿——后者在分布外场景下容易失效甚至出现欺骗性对齐。通过识别内部表征,研究者可以提前发现隐藏的目标、验证安全微调是否真正改变了模型的决策逻辑,而不仅是压制了输出。这一领域目前仍处于从实验室走向工程实践的阶段。
总结的潜在价值与局限
这条推文的价值在于它指向了一份关于Argon 4安全与对齐的系统性总结。对于关注AI治理的研究者和工程师而言,此类总结有助于理解前沿项目如何平衡能力提升与风险控制。然而,推文本身信息量有限,缺乏具体技术细节与量化结果,读者需通过原始总结获取完整图景。
从传播角度看,简短的评价性推文能够引发社区对安全对齐工作的关注,但深度讨论仍需依赖更详尽的文档。建议感兴趣的读者追踪Argon 4的官方技术报告或相关论文,以获取关于威胁模型、评估指标与对齐方法的完整信息。
结语
Argon 4的安全与对齐工作获得正面评价,是AI系统开发中重视负责任创新的一个信号。在模型能力快速迭代的背景下,将安全与对齐置于与性能同等的位置,正逐渐成为行业标准做法。这条推文虽短,却折射出AI开发文化向更稳健方向演进的趋势。
相关推荐
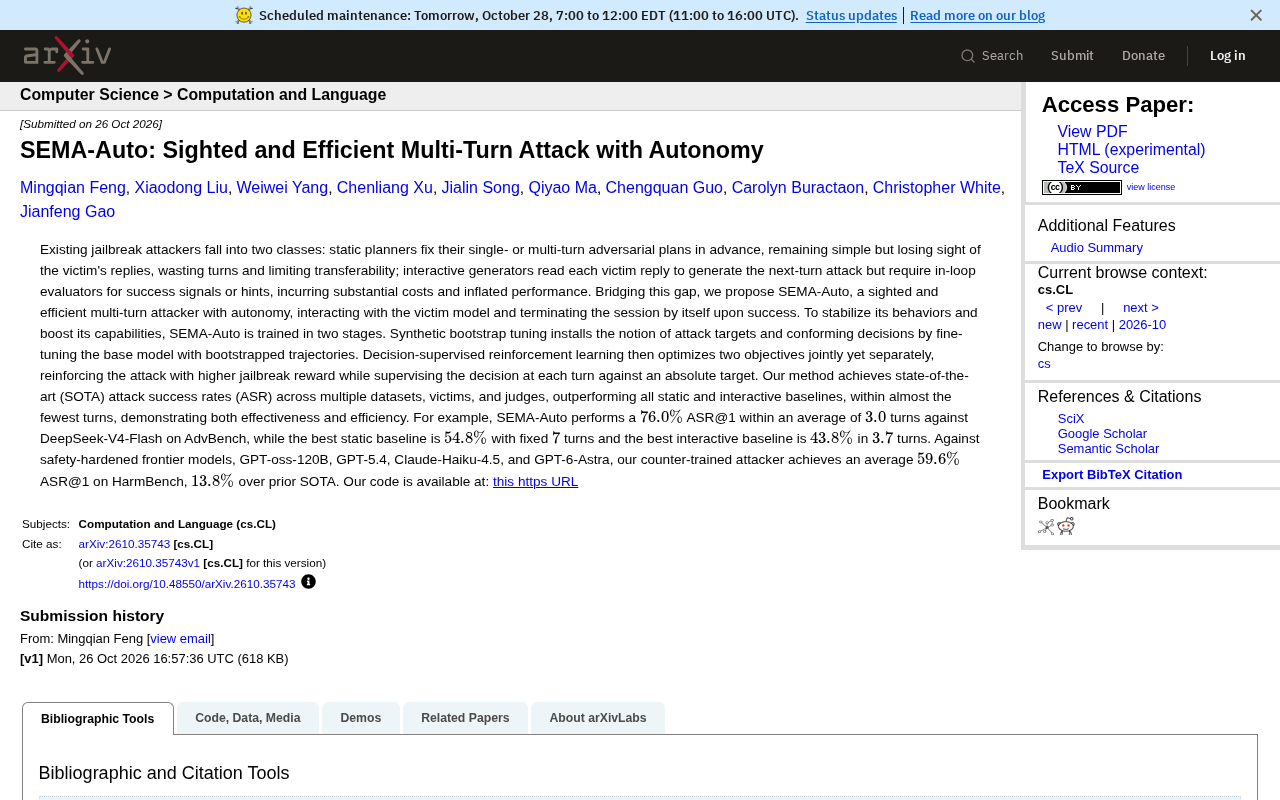
SEMA-Auto:自主多轮越狱攻击效率与成功率双突破
微软提出 SEMA-Auto 自主多轮越狱攻击方法,通过两阶段训练实现自主终止与高效攻击,在 AdvBench 上以 3 回合达 76% 成功率,超越静态与交互式基线。
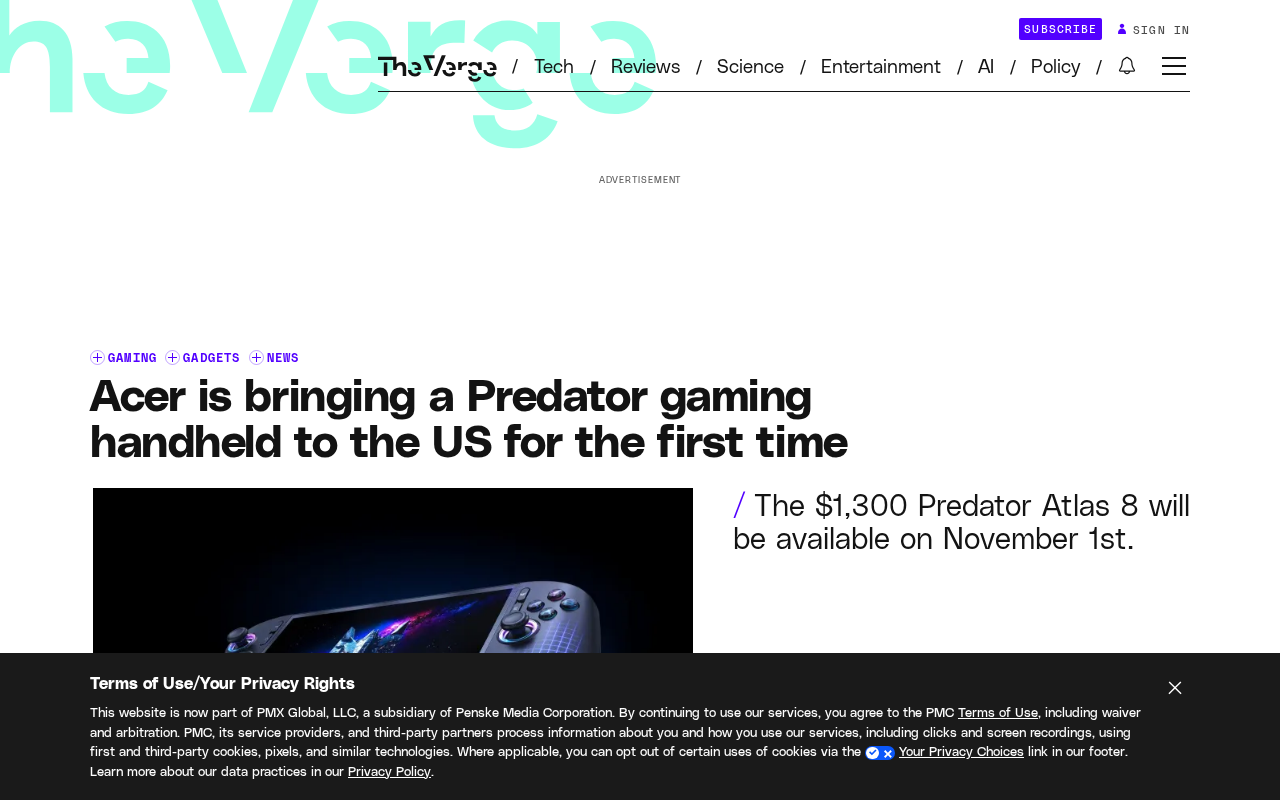
宏碁Predator Atlas 8游戏掌机首次登陆美国,独家首发Best Buy
宏碁Predator Atlas 8游戏掌机首次登陆美国市场,Intel Arc G3 Extreme版本将在Best Buy独家销售。本文梳理型号选择、渠道策略与市场竞争格局。
WorkBuddy怎么用?本地AI智能体安装与工作台搭建指南
WorkBuddy是什么?本文整理B站保姆级教程要点,讲清这款本地AI智能体的完整工作流:从官网下载安装、连接器绑定办公软件,到多智能体并行处理文档与数据分析,并对比Codex说明新手选它的理由。