深入LLM推理:从KV Cache到PD分离的Serving全景解析
系统梳理大模型推理从KV Cache原理到分布式Serving策略的核心设计思想与工程权衡
本文基于北京大学AI Infra Seminar讲座内容,系统介绍了大模型推理与服务系统的完整技术栈。自回归推理分Prefill(compute-bound)和Decode(memory-bound)两个性质迥异的阶段,但Agent场景下高KV Cache命中率正在打破这一经典假设。KV Cache是Transformer推理的核心资源,MLA等新架构可将其缩小约一个数量级。vLLM的PagedAttention借鉴OS分页思想大幅提升显存利用率;PD分离与Chunked Prefill则解决两阶段互相干扰的调度问题,代价是需要跨实例搬运KV Cache。投机解码利用Decode的memory-bound特性,通过Draft-Verify机制实现精度无损的加速。文章最后指出,所有优化都隐含了对NVIDIA GPU生态的假设,软硬件协同设计(co-design)是同等可行的另一条路径。
大模型推理(Inference)与服务(Serving)是当前AI Infra领域最活跃、演进最快的方向之一。北京大学未名超算队联合LCPU举办的AI Infra Seminar,以「Inference & LLM Serving」为主题,系统梳理了从KV Cache原理到分布式Serving策略的完整技术栈。本文基于该讲座内容,提炼推理系统的核心设计思想与关键工程权衡。
推理的两阶段计算形态
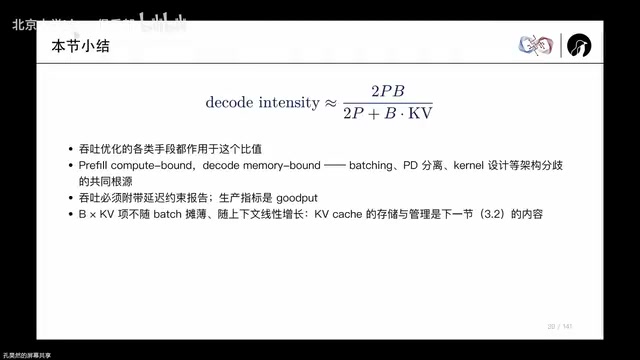
自回归模型的推理请求会经历两个性质迥异的阶段:Prefill(预填充)和Decode(解码)。Prefill阶段一次性处理全部prompt,是一个标准的GEMM(矩阵乘),算术强度高,属于compute-bound;而Decode阶段每次只产生一个token,形态类似GEMV(矩阵向量乘),算术强度极低,属于memory-bound。
这个「Prefill是计算瓶颈、Decode是访存瓶颈」的结论在过去被广泛引用,但讲座强调需要批判性看待——随着Agent与Coding场景的兴起,这一经典假设正在被打破。据DeepSeek广告公布的线上统计,输入token的cache命中率约56%,而在Agent加Coding场景下命中率可能高达90%甚至95%。当命中率极高时,Prefill只需计算未命中的后缀,计算强度骤降,未必再是compute-bound。
讲座用一个简化模型量化了Decode的性能上限:以70B的BF16模型为例,产生一个token需要读入约140GB权重,即便打满H100的3.35TB/s显存带宽,每token延迟也至少42毫秒,理论TPS上限约24 token/秒。这个数字远不能令人满意,也正是后续所有优化的起点。
KV Cache:Transformer的循环状态
KV Cache是理解推理系统的核心概念。讲座提出三个关键问题:为什么缓存是合法的?为什么缓存的是K和V?丢弃后如何找回?
缓存合法的根源在于Causal Mask(因果注意力)——新token依赖前面所有token,但这种依赖不会因新token加入而改变,因此历史的K、V可以安全缓存。之所以只缓存K和V而不缓存Q,是因为Q只在当前步被使用。一旦KV被丢弃,就只能通过重算(recompute)找回,或从多级存储中搬运(offload)回来,两者之间存在明确的成本权衡。
KV Cache的大小是模型相关的。以Llama 3.3 70B为例,采用GQA后每token约320KB;而MLA架构因采用512维latent加64维RoPE的设计,KV Cache可缩小约一个数量级,从成本上带来巨大优势。这也解释了为何attention机制的演进(从MHA到GQA到MLA再到稀疏注意力DSA)本质上都是在优化KV Cache的存储与读取开销。
KV Cache之所以只存储Key和Value而不存储Query,与Transformer注意力机制的计算结构密切相关。在每一步自回归解码中,注意力的计算公式为 Attention(Q, K, V) = softmax(QK^T / √d) · V,其中当前步的Query只与当前位置有关,用完即弃;而历史位置的K、V在后续每一步都会被重新访问(用于计算当前Q与所有历史位置的注意力分数)。因此缓存K和V可以避免对历史token重复做线性投影计算,代价是占用显存。GQA(Grouped Query Attention)是对原始MHA(Multi-Head Attention)的改进——多个Query头共享同一组K、V头,直接按比例压缩KV Cache的存储量;MQA(Multi-Query Attention)是GQA的极限情况,所有Query头共享一对K、V。MLA(Multi-head Latent Attention,DeepSeek提出)则通过低秩压缩将KV压缩到一个低维latent向量再缓存,进一步大幅降低KV Cache的存储开销,是目前业界最激进的KV压缩方案之一。
Serving的核心指标与负载特性
评估一个Serving系统需要多维指标。吞吐(Throughput)决定服务方的每token成本,延迟决定单个用户体验,两者通常难以兼顾——延迟与吞吐往往呈现此消彼长的曲线关系。学术界倾向死磕延迟优化,而工业界更关注「延迟够用即可、吞吐最大化」。
关键指标包括TTFT(Time To First Token,影响排队和首字体验)、TPOT(Time Per Output Token,衡量decode性能)、ITL(token间延迟分布)以及端到端延迟。生产环境还需关注P50、P90、P99等分位数而非仅看平均值。
负载分为online与offline两类:online负载有延迟约束,只有满足约束的吞吐才是「有效吞吐」(good throughput);offline负载则可放开延迟限制,让decode逼近compute-bound。讲座反复强调,Serving是一个高度case-by-case的复杂topic——不同场景(对话、文档概括、Agent Coding)会彻底改变系统的性质与最优优化手段。
PagedAttention与Cache管理
vLLM提出的PagedAttention是推理系统「梦开始的地方」。它借鉴操作系统虚拟内存分页思想管理KV Cache,将原本按max sequence length预留造成的巨大内碎片,压缩为单个block内的碎片,大幅提升可用batch size。这需要维护一张block table记录逻辑块到物理块的映射,同时kernel必须显式支持这种paged布局。
Page size的选择是经典权衡:page大利于访存合并和TMA传输(H100上TMA约需2KB才能打满带宽),但内碎片较多;page小则碎片少但传输效率低。此外,通过Prefix Caching可实现请求间的KV复用——vLLM采用block hash、SGLang采用radix tree,两种设计各有侧重,但实际表现需在具体workload上实测。
显存是极其昂贵的资源,KV Cache会在HBM、CPU DRAM、本地NVMe、远端存储池构成的多级hierarchy中流动。offload是否划算,取决于传输时间与重算时间的对比,以及是否满足SLO。两个符合直觉的推论是:KV Cache越小传输越划算;传输应与HBM计算做重叠。
PagedAttention在提出之前,主流推理框架(如FasterTransformer)通常按照请求的最大序列长度(max_seq_len)预先为每条请求分配连续的KV Cache显存。这种方式导致严重的内碎片问题:如果一个请求实际只用了分配长度的30%,剩余70%的显存便被白白占用直至请求结束。而不同请求之间的外碎片则让调度器难以装入更多并发请求。vLLM借鉴Linux虚拟内存的分页(paging)机制,将KV Cache切分为固定大小的物理block(通常16或32个token一块),每条请求按需动态申请block,通过block table维护逻辑序列到物理块的映射。这一设计将碎片控制在单个block以内,使显存利用率从原本的60%-80%提升至接近100%,同时天然支持跨请求的物理block共享,为Prefix Caching和Copy-on-Write(用于Beam Search)奠定基础。
PD分离与并行策略
由于Prefill和Decode性质差异巨大,将两者混在一起会互相干扰——一个超长的Prefill会抢占正在Decode的计算资源,导致SLO违约。缓解手段有两种:Chunked Prefill(将prefill切成chunk按token预算调度)和PD分离(将两者部署到独立资源池)。
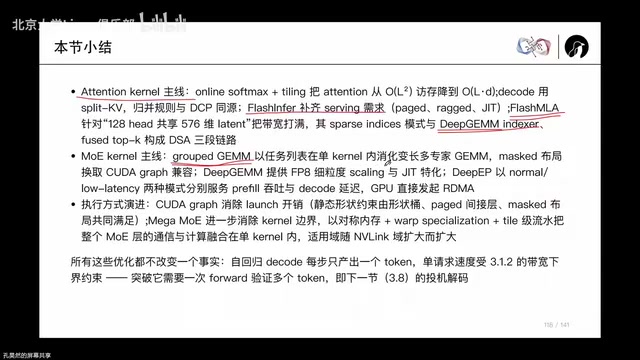
PD分离的代价是需要显式地把KV Cache从Prefill实例搬到Decode实例。讲座算了一笔账:CX7网卡打满400Gbps IB约50GB/s,搬运40GB的KV Cache需0.8秒——这对某些TTFT约束是不可接受的。业界通过Mooncake、NIXL等库实现P2P搬运,采用逐层传输和RDMA单边操作来隐藏通信延迟。
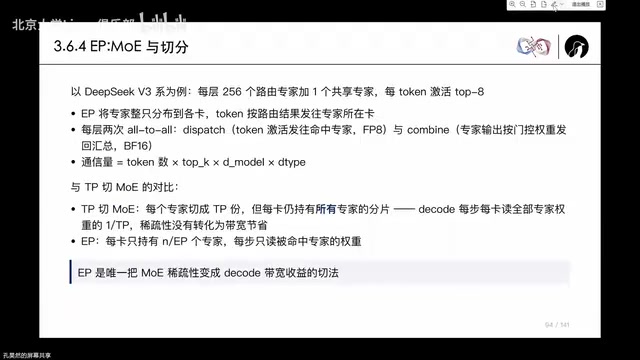
并行方式的选择由模型结构、KV Cache大小、负载类型、SLO要求、硬件互联等多重因素共同决定。常见组合是:Attention用DP、MoE用EP的大EP方案(DeepSeek V3的decode单元用了144卡EP,通过大batch均摊权重load开销并腾出显存提升batch size);长上下文场景必须开Context Parallel(如Ring Attention);TP和PP需落在NVLink域内。
RDMA(Remote Direct Memory Access,远程直接内存访问)是PD分离中KV Cache传输的关键底层技术。传统TCP/IP传输需要经过操作系统内核协议栈,延迟高且CPU开销大;RDMA允许网卡绕过CPU和OS,直接在两台机器的内存之间搬运数据,延迟可降至微秒级,且几乎不占用CPU资源。InfiniBand(IB)是数据中心中最常见的RDMA网络,CX7网卡支持400Gbps带宽。RDMA单边操作(one-sided RDMA,即RDMA Read/Write)无需远端CPU参与响应,发起方可直接读写对端内存,进一步减少协调开销。Mooncake(月饼,月之暗面开源)和NIXL(NVIDIA开源)正是在此基础上封装了P2P KV Cache传输的高层接口,支持逐层(layer-by-layer)流水线传输:Prefill实例每完成一层的KV计算即立刻发送,与后续层的计算重叠,从而将传输延迟对TTFT的影响降到最低。
投机解码:打破每步一token的假设
Decode的memory-bound特性带来一个巧妙的优化空间:既然读一次权重的访存开销固定,那能否一步产生多个token?投机解码(Speculative Decoding)正是基于此——Draft模型先猜测K个token,大模型一次性Verify。由于bound在memory上,增加的计算量近乎免费,且有严格数学证明保证精度无损。
Draft模型经历了从独立小模型、Medusa到MTP和EAGLE的演进。MTP的优势是模型训练时就把MTP头训好,开源模型可直接享受收益;EAGLE则支持tree-based draft。今年DeepFlash还开创了通过Block Diffusion做并行Drafting的新方向,一次forward即可产生整个block候选。
投机解码与batch size存在权衡:小batch下算力充足,draft收益明显;大batch逼近compute-bound时,draft的计算开销可能得不偿失。DeepSeek提出的DSpark设计通过动态调整投机参数,实现了帕累托最优的抉择。
投机解码(Speculative Decoding)的核心数学保证来自拒绝采样(Rejection Sampling)机制。验证阶段,大模型对Draft模型提出的K个token做并行forward,对每个位置计算大模型分布与Draft分布的比值,按比例决定接受或拒绝。可以严格证明,经过这一校正过程后,最终输出的分布与大模型独立采样完全等价——即投机解码是无损的(lossless)。接受率(acceptance rate)是影响实际加速比的关键因素:接受率越高,每次Draft-Verify循环产生的有效token越多,加速比越大。EAGLE等方法通过让Draft模型直接预测大模型的特征表示(feature)而非token概率,显著提高接受率。Tree-based drafting则同时维护多条候选token路径,以树形结构送入大模型并行验证,进一步提升每次验证所能接受的token数量期望值。
硬件视角的启示
讲座结尾提出一个发人深省的观点:以上所有优化都隐含了对NVIDIA GPU生态的假设。当限制因素变化时,结论可能完全不同。OpenAI选择用GQA注意力并直接设计专用AI硬件,绕开了PD分离的必要性,同样拿到了极高的FLOPs per watt和带宽利用率。
这提醒Infra从业者要以发展的视角看待问题——PD分离是特定约束下的漂亮方案,但针对不分离场景做软硬件协同设计(co-design)同样可行。整个推理系统的演进主线清晰可见:调度粒度越来越细、资源管理越来越精细、模型与系统的协同设计越来越深入。对做Serving Infra的人来说,最终目标始终是:在一个训好的模型上,满足SLO要求的前提下实现最低成本、最高吞吐。
相关推荐
Apple Watch的隐私困局:新款手表要对准谁开火?
Apple Watch Series 12和Ultra 4的音频智能功能引发隐私争议。本文深度解析苹果如何用一块手表同时对准Whoop健康追踪市场和OpenAI的AI伴侣赛道,以及Siri Recap全天监听背后的第三方隐私困局。
FDE前沿部署工程师是什么?AI落地新岗位深度解析
FDE(前沿部署工程师)是AI时代的新兴岗位,工程师深入客户现场定制落地AI解决方案。本文解析FDE的定义、出现原因、与传统软件开发的区别,以及它如何解决企业用不好AI的核心瓶颈。
AI攻克国际数学奥林匹克:最后一道难题的启示
从2024年答对4题到全部解出,AI在国际数学奥林匹克(IMO)上的进步令人瞩目。本文解析那道曾难倒机器与顶尖人类选手的2025年最后一题,探讨AI推理能力的跃升及其意义。