Opus 5深度实测:编码能力碾压竞品,成本仅为一半
开篇:Anthropic再度出招
Anthropic刚刚发布了新一代前沿大语言模型Opus 5,在几乎所有主流基准测试上都实现了显著提升。海外科技创作者Nick Saraev花费400美元进行了深度实测,结论颇具冲击力:Opus 5不仅是普通用户目前能用到的最强模型之一,更关键的是——它在保持甚至超越竞品能力的同时,成本却大幅下降。
这篇实测的价值不在于罗列基准分数,而在于从实际使用体验出发,评估这个模型"用起来到底如何"、"能产出什么样的输出"。正如作者所言,那些死板的百分比数字对普通用户其实意义有限,真正重要的是模型输出的质量与品位。
一句话生成完整3D交互应用
实测中最令人印象深刻的,是Opus 5一次性生成完整交互式应用的能力。作者演示了一个几乎完全由Opus 5创建的3D虚拟世界——用户可以在其中自由行走、查看挂在墙上的艺术作品,每当靠近一件作品,还会响起类似宝可梦图鉴登记的提示音。
这背后涉及WebGL和Three.js等浏览器端3D渲染技术。传统上,构建一个可行走、可交互的3D虚拟环境需要游戏引擎(如Unity或Unreal)或至少数周的前端开发工作。WebGL是一种嵌入在浏览器中的图形API,允许网页直接调用GPU进行硬件加速渲染,而Three.js则是基于WebGL的高层JavaScript库,极大简化了3D场景的搭建流程。模型能够在单次推理中同时处理3D场景构建、碰撞检测、用户输入响应、音频触发等多个技术层面,说明其对代码架构的整体理解已经从"逐行补全"进化到了"系统级设计"。值得一提的是,碰撞检测(Collision Detection)本身就是3D交互应用中计算开销最大的模块之一,通常需要空间分割算法(如八叉树或BVH包围盒层次结构)来优化性能,模型能在单次生成中正确处理这一部分,进一步体现了它对实时渲染管线(Render Pipeline)的深层理解。
"就在不久以前,这东西还会被认为是一款完整的游戏。"作者感叹道。而现在,它只需要几秒钟的代码生成就能实现。
更说个细节一系列物理模拟类应用:
物理与生态模拟实例
- 太空发射模拟器:类似《坎巴拉太空计划》风格,用户可以调整发射轨迹让物体进入稳定轨道,被行星引力捕获,甚至展示牛顿大炮和霍曼转移等航天概念,兼具讲解工具与游戏属性。霍曼转移轨道(Hohmann Transfer Orbit)是航天工程中最基础也最经典的轨道机动方式,由德国工程师Walter Hohmann于1925年提出,它利用两次引擎点火,通过一条椭圆轨道将航天器从一个圆形轨道转移到另一个圆形轨道,是燃料消耗最少的双脉冲转移方案。模型能够准确模拟这一物理过程,说明它不仅理解了牛顿力学的基本方程,还能将连续物理系统离散化为可在浏览器中实时运行的数值模拟代码。
- 布料模拟:布料在风中飘动,用户甚至可以将模拟的布料撕开,逼真度足以让人联想到真实拉窗帘的反应。布料模拟在计算机图形学中属于经典的软体动力学问题,最常见的实现方法是质点-弹簧系统(Mass-Spring System):将布料离散化为网格上的质点,质点之间通过弹簧连接,每个时间步长内根据胡克定律计算弹力、加上重力和风力等外力,再用数值积分方法(如Verlet积分)更新位置。撕裂效果则通过在弹簧拉力超过阈值时断开连接来实现。这类模拟在游戏和影视行业通常需要专门的物理引擎(如NVIDIA的PhysX或Havok),Opus 5能在浏览器环境中实时生成可交互的布料模拟代码,说明它掌握了从物理建模到数值求解再到渲染输出的完整技术栈。
- 捕食者-猎物生态系统:生成兔子后它们会吃草,狐狸则捕猎兔子。当狐狸把兔子吃光后,草大量过剩,而狐狸数量随即暴跌——一个完整闭环的动态生态被精准模拟出来。这本质上是经典的Lotka-Volterra捕食者-猎物模型的可视化实现,该数学模型最早由Alfred Lotka和Vito Volterra在1920年代独立提出,用微分方程描述两个物种之间的种群动态平衡。具体而言,Lotka-Volterra方程组包含两个耦合的一阶非线性微分方程,分别描述猎物和捕食者种群的增长率,其解呈现出周期性振荡——猎物数量先增长、引发捕食者繁殖、捕食压力导致猎物锐减、随后捕食者因食物不足而衰减,如此循环往复。Opus 5不仅实现了这一数学模型,还加入了草地资源层作为第三个变量,形成了更接近真实生态的三营养级模型。
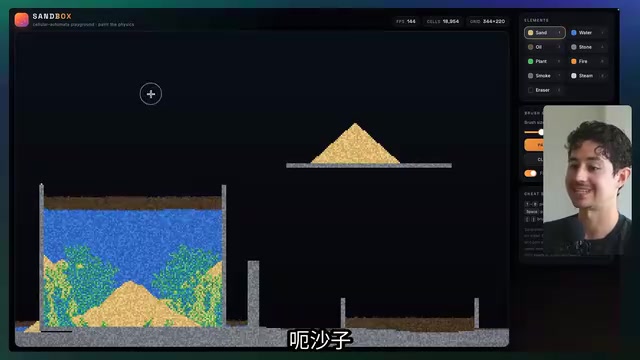
- 元胞自动机"模拟之王":管道内细胞自动生长,用户可以导入沙子、制造石油泄漏、产生蒸汽甚至点燃火焰。元胞自动机(Cellular Automaton)是一种离散数学模型,由John von Neumann和Stanislaw Ulam在1940年代提出,后因John Conway的"生命游戏"和Stephen Wolfram的系统研究而广为人知。其核心思想是:在一个网格上,每个单元格根据简单的局部规则和邻居状态决定自己的下一个状态,但这些简单规则的组合能涌现出极其复杂的全局行为。Opus 5生成的版本不仅实现了基础的元胞演化,还加入了多种物质类型之间的相互作用规则(如沙子受重力下落、水流动并蒸发、火焰传播并消耗可燃物),本质上是一个多状态、多规则的复杂元胞自动机系统,其设计复杂度远超经典的二状态生命游戏。
此外还有分形生成器(可无限缩放并调整泛光、色散等参数)、四轴无人机飞行模拟器(甚至带有真实音效,可按键降落)、双摆系统、像素画编辑器(支持撤销、洋葱皮、逐帧动画)等等。其中分形生成器涉及的数学背景同样引人注目——分形(Fractal)是数学家Benoît Mandelbrot在1975年正式命名的概念,指具有自相似性的几何结构,最著名的Mandelbrot集通过对复数平面上每个点迭代公式z_{n+1} = z_n² + c来生成。实现"无限缩放"需要处理浮点精度问题,标准64位双精度浮点数在约10^15倍放大后会出现精度丢失,更深层的缩放需要用到任意精度算术或扰动理论。而双摆(Double Pendulum)则是混沌理论中最经典的演示系统,由两个串联摆臂组成,其运动方程高度非线性且对初始条件极度敏感——初始角度的微小差异会导致完全不同的运动轨迹,正是"蝴蝶效应"的直观体现,精确模拟需要求解拉格朗日力学方程并使用高精度数值积分器(如四阶龙格-库塔法)。作者评价:"我们已经离每个人都能设计自己的定制应用非常近了。"
关键差异:自主合成而非网络抓取
在演示运动鞋配置器时,作者指出了一个容易被忽视但至关重要的进步。虽然生成的鞋子外观不算最精致,但Opus 5并不是直接从网上抓取鞋子素材,而是自己创建了这些SVG元素。
SVG(可缩放矢量图形)是一种基于XML的图形格式,与位图(如JPEG、PNG)不同,它通过数学路径和几何命令描述图形,可以无损缩放到任意尺寸。模型自主创建SVG意味着它不是从训练数据中"记住"某张图片再复现,而是理解了物体的几何结构并用路径命令从零构建。这种能力类似于人类画家从脑中构思形状再落笔,而非临摹照片,代表了从"检索式生成"向"创造式合成"的关键转变。更深层地看,这还涉及空间推理(Spatial Reasoning)能力:要用SVG路径命令(如M、L、C、A等贝塞尔曲线指令)描绘一只运动鞋的轮廓,模型需要在"脑中"维持一个二维空间的心理模型,理解各部件(鞋底、鞋面、鞋带、气垫)的相对位置和形状关系,再将其转化为精确的坐标序列。这种从抽象概念到几何具象的转化能力,在传统NLP评估中几乎不被考察,却是通往多模态创作能力的关键一步。
"这是一个很大的进步,因为这种合成通常不是模型会做的事。"
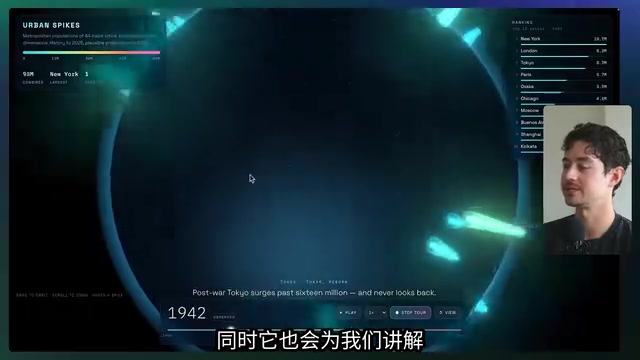
这一点也体现在人口变迁的数据可视化图表中——展示过去126年间纽约、伦敦、东京等城市的人口变化,视角可自由拖拽、缩放,并配有实时讲解。这些内容都是模型自主构建,而非调用现成资源。
基准测试成绩:全面领先,编码尤为突出
作者逐项拆解了Opus 5的基准成绩,整体表现堪称"碾压":
核心基准数据一览
| 测试项目 | Opus 5表现 | 对比 |
|---|---|---|
| 终端编码 | 领先 | 超越竞品Fable 5、GPT 5.6及Opus 4.8 |
| GDP VAL知识工作 | 1861分 | 稳超普通人水平 |
| ARC-AGI3新问题解决 | 30.2% | Opus 4.8仅1.5%,巨大跃升 |
| BrowseComp搜索 | 90.8% | 与GPT 5.6持平 |
| 多学科推理(工具增强) | 64.7% | 超过Fable的63.9% |
| 计算机使用 | 70.6 | 越来越接近人类操作 |
| 企业自动化 | 26% | 显著高于Fable的17.4% |
其中GDP VAL(General-purpose Dense Performance Validation)是一个综合评估模型在知识工作场景下表现的基准体系,涵盖文档理解、数据分析、报告撰写、电子邮件处理等日常办公任务。1861分"稳超普通人水平"意味着在标准化的知识工作任务集中,模型的综合表现已经超过了人类参与者的中位数得分,这对白领工作自动化的前景具有直接指示意义。BrowseComp则是OpenAI提出的一项评估模型网络搜索与信息综合能力的基准测试,要求模型在开放互联网环境中执行复杂的多步骤信息检索任务——不只是找到单一答案,而是需要浏览多个网页、交叉验证信息、综合推理后给出准确结论。90.8%的得分意味着模型在这种需要"深度搜索"的场景中几乎能可靠地完成任务。
计算机使用(Computer Use)评分衡量的是模型直接操作图形界面(GUI)的能力——通过截屏识别界面元素、移动鼠标、点击按钮、输入文本等方式完成任务,本质上是让AI像人类一样"使用电脑"。这项能力由Anthropic在Claude 3.5时代率先推出,是迈向通用AI助手的关键一步。70.6的得分意味着模型在约七成的标准化计算机操作任务中能够成功完成,虽然距离人类的操作可靠性仍有差距,但已经足以在大量重复性操作场景中替代人工。
说个细节,在ARC-AGI3这类衡量"新问题解决能力"的严苛测试上,从Opus 4.8的1.5%飙升到30.2%,是Opus系列内部一次极其罕见的跨越式进步。ARC-AGI(Abstraction and Reasoning Corpus for Artificial General Intelligence)由AI研究者François Chollet设计,专门用于测试模型面对全新、从未见过的抽象推理问题时的泛化能力。与常规基准测试不同,ARC的题目刻意设计为无法通过记忆训练数据来解答——每道题都呈现几组输入-输出示例,要求模型从中归纳出隐含的变换规则,再将其应用到全新的测试输入上。ARC-AGI3是该测试的第三代版本,难度进一步提升。这项测试长期被视为衡量AI是否具备"真正理解"而非"统计拟合"能力的试金石,30.2%的成绩意味着模型在"举一反三"这一被认为最接近通用智能的能力维度上取得了实质性突破。
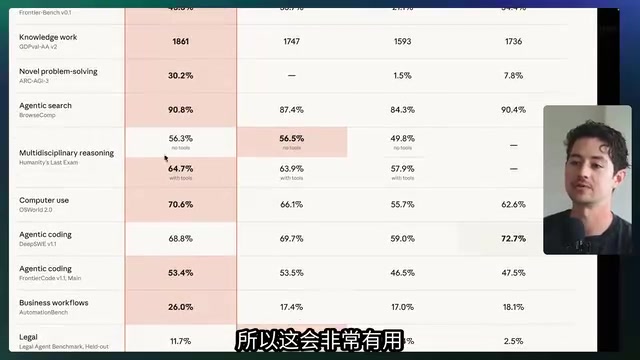
不过作者也如实指出短板:在智能体编码(agentic coding)方面表现平平,GPT 5.6在此项上仍然领先。智能体编码指的是模型在一个多步骤的编程任务中,自主规划、执行、调试并迭代修正代码的能力——不仅要写对代码,还要能像一个真正的软件工程师那样管理整个开发流程。这与单次代码生成有本质区别,更考验模型的长程规划和错误恢复能力。具体来说,智能体编码任务通常要求模型在一个真实的代码仓库环境中工作:理解项目结构、定位相关文件、编写或修改代码、运行测试、根据测试结果调试错误,整个过程可能涉及数十次工具调用和上下文切换。GPT 5.6在此项上的领先可能与其在多轮工具使用和长上下文追踪方面的架构优化有关。
真正的杀手锏:成本优势惊人
如果说能力提升是渐进的,那么成本控制才是Opus 5最具颠覆性的一面。
作者用一个网站生成任务做对比:Opus 5生成的AirLens网站成本仅69美分,而竞品Fable 5要94美分,且Opus 5的成品质量明显更优。
更宏观的"按努力程度看性价比"分析更能说明问题:
- 最弱版本的Opus 5在计算机操作任务上可拿约60%分数,单任务成本约9美元;
- 最强版本约70%分数,单任务成本约22美元;
- 而Fable 5达到中等Opus 5水平,单任务成本却接近50美元。
这里的"按努力程度"是指通过调整推理时的计算资源投入(如采样次数、思维链长度等参数)来在成本与性能之间寻找平衡点。这种"推理时计算扩展"(inference-time compute scaling)是当前大模型领域的重要技术趋势——同一个模型在不同的计算预算下可以表现出截然不同的能力水平。这一概念源于2024年以来的一系列研究发现:与其训练一个更大的模型,不如让现有模型在推理时"思考更久"——通过生成更长的思维链、对多个候选答案进行采样和验证、或者让模型反复检查和修正自己的输出。OpenAI的o1系列和Anthropic的扩展思考模式都是这一思路的产物。Opus 5在各个预算级别上都展现出了优于竞品的性价比,意味着无论用户选择"快速廉价"还是"深思熟虑"的使用模式,都能获得最优的投入产出比。
在企业自动化基准上,Opus 5接近25%通过率,而其他模型大多聚集在15%左右。在ARC-AGI3的"按成本计算新问题解决能力"维度上,Opus 5以约31%的成绩直接位于图表右上角,将得分普遍在2%左右的对手远远甩开。
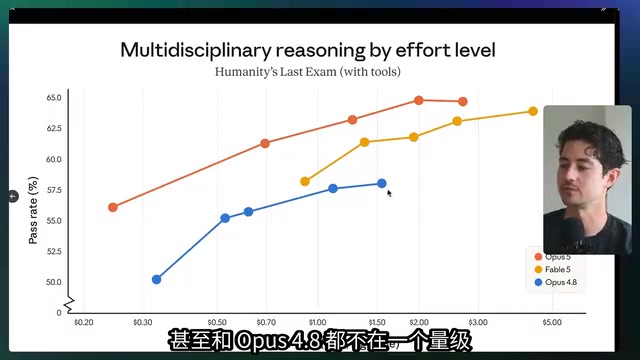
作者对Opus 5的整体定位一针见血:"基本上就是稍微聪明一点的Fable,成本大概只有Fable的一半。"
安全性表现:更对齐,更省心
除了聪明和便宜,Opus 5在"对齐"(alignment)表现上也更出色。AI对齐是当前AI安全研究的核心议题,指的是确保AI系统的行为与人类意图和价值观保持一致。这一研究领域可以追溯到Stuart Russell和Eliezer Yudkowsky等人的早期工作,核心挑战在于:如何将人类模糊、复杂且有时自相矛盾的价值观精确地传达给一个数学优化系统。在实际部署中,对齐问题表现为多个层面——从不产生有害内容(安全对齐),到准确理解用户真实意图而非字面意思(意图对齐),再到在自主执行任务时不越权行事(行为对齐)。在自动化工作流中,行为对齐尤为关键——一个不够对齐的模型可能会在未经明确授权的情况下执行超出用户预期的操作,例如在被要求编辑文件时擅自删除其他文件,或在自动化流程中做出不可逆决策。
在衡量越界行为的十分制评分中,分数越低越安全:
- Opus 4.8:2.85分
- Meso S5:2.81分
- Cloud on it 5:3.35分
- Opus 5:仅2.3分
这意味着Opus 5更不容易做出人类并不希望它执行的颠覆性动作。这项评估通常通过设计一系列"诱导场景"来完成——测试者给出模糊或可被过度解读的指令,观察模型是否会过度执行、越权操作或产生意料之外的副作用。例如,指令"清理这个项目目录"可能被过度解读为删除所有看似多余的文件,而一个良好对齐的模型应该仅执行明确在合理范围内的操作并对模糊意图寻求确认。2.3分在当前主流模型中处于最优水平,对企业级部署来说意味着更低的运营风险和更少的人工监督成本。综合来看,Opus 5实现了"更聪明、更便宜、更安全"的三重提升。
冷静的宏观思考
作者最后给出了一段颇具深度的行业观察。他认为Opus 5并没有带来真正颠覆性的技术突破,而是延续了Opus 4.5、4.7、4.8以来"缓慢而稳定"的改进节奏。
这次发布来得恰逢其时——因为开源阵营的Kimi K3一周前已经发布,打破了中国/开源模型与美国闭源前沿模型之间的力量平衡。近两年来,以Meta的Llama系列、Mistral、以及中国的DeepSeek、Qwen、Kimi等为代表的开源或半开源模型持续缩小与OpenAI、Anthropic、Google等闭源前沿模型的差距。这种竞争格局对行业影响深远:开源模型的追赶迫使闭源厂商不断降价并加速发布节奏,但也引发了关于是否应该限制最强模型开源的安全辩论。值得注意的是,开源与闭源之间的竞争并非简单的"免费vs付费"——开源模型的真正价值在于可本地部署、可微调定制、数据不出域,这对医疗、金融、国防等对数据隐私有严格要求的行业至关重要。而闭源模型的优势则在于可以集中算力提供最强的推理能力,并通过API经济实现规模化盈利。两条路线之间的张力正在重塑整个AI产业的商业格局。
他还提出了一个略显悲观的预判:随着这些模型日益成熟、具备大规模颠覆知识工作的经济价值,头部AI公司很可能会"以缓慢稳定的挤牙膏节奏"发布模型,而真正的超级智能则会被越来越明目张胆地藏在幕后,普通用户短期内难以触及。这一观点呼应了业界长期存在的担忧:当AI能力的商业价值足够巨大时,"能力领先"本身就成为了一种需要被精心管理的战略资产,而非急于分享的技术成果。从历史角度看,这种"能力囤积"现象在技术史上并非没有先例——核技术、卫星通信、半导体制造等领域都经历过类似的从开放研究到战略封锁的转变。如果AI确实走上这条路,那么当前这个"模型能力快速公开迭代"的时代,可能在回头看时会被视为一段短暂的黄金窗口期。
结语
无论宏观趋势如何演变,对当下的普通用户和企业而言,Opus 5都是一个极具吸引力的选择:它在编码、模拟生成、自动化工作流等场景中表现优异,输出质量领先竞品,成本却低得多,同时安全性更好。对于希望将AI整合进业务流程的团队来说,这几乎是一次值得立即尝试的升级。
核心要点
核心要点
相关推荐
MiniCPM-2B无审查版本地部署教程:接入llama.cpp与Hermes全流程
MiniCPM-2B 本地部署完整教程:涵盖 GGUF 模型下载、llama.cpp 配置、启动脚本编写及接入 Hermes 客户端全流程。支持 131K 上下文,普通电脑即可运行的国产轻量级大模型部署指南。
DeepSeek Harness 解析:智能体内核的三大设计问题
DeepSeek Harness 是什么?本文从三个递进问题拆解智能体 Agent 的内核设计:Harness 工程化、插件化体系原理,以及高可用 Agent 产品的架构落地思路,帮助前端开发者转型 AI 全栈。
Markdown为何是AI世界的母语?Obsidian语法保姆级教程
从Obsidian公开课整理的Markdown保姆级教程:六大类通用语法、Obsidian扩展语法(双链、标签、Callout)实操,并深入解析为什么Markdown凭借结构化纯文本与低冗余特性成为AI世界的母语。