视频模型比图像模型更懂世界?世界模型之争解析
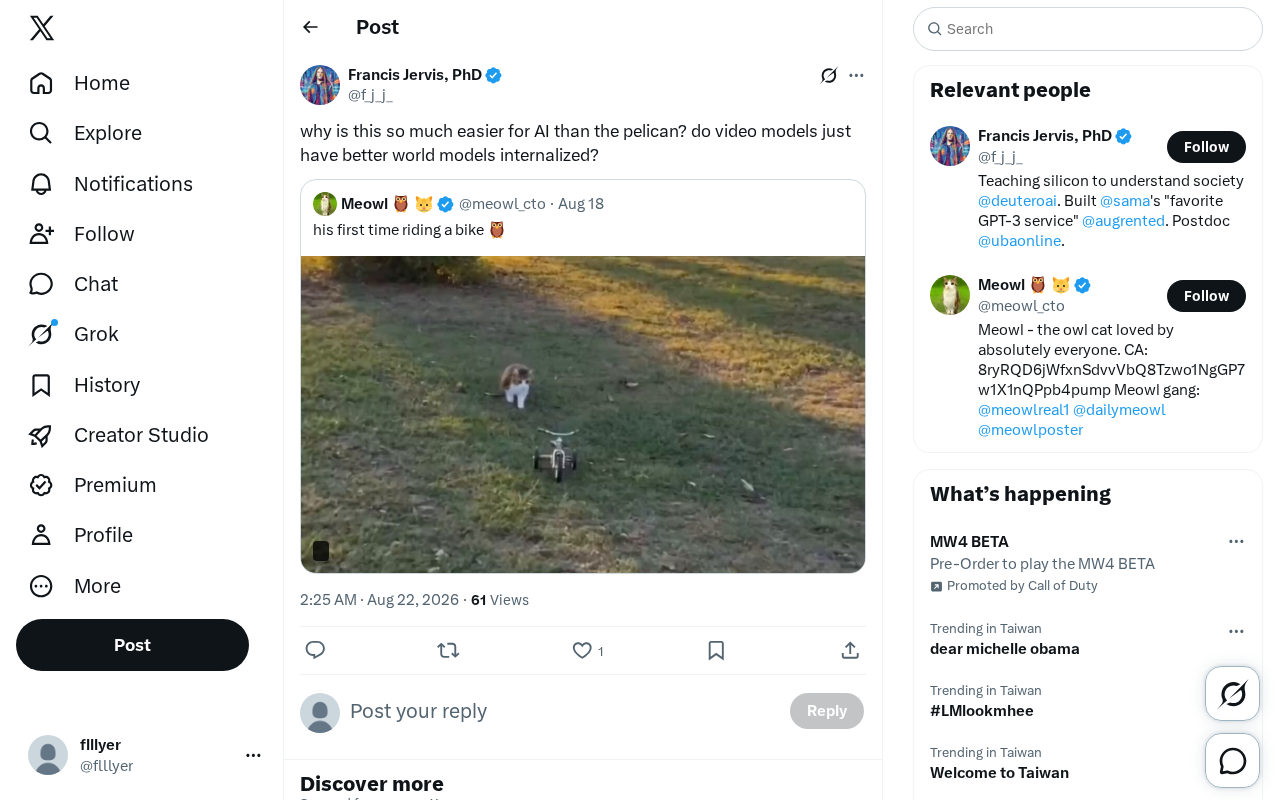
一个耐人寻味的观察
近日,一位AI研究者在社交媒体上抛出了一个引人深思的问题:「为什么这件事对AI来说比画鹈鹕(pelican)要容易得多?难道视频模型内化了更好的世界模型(world models)吗?」
这个看似随意的提问,实际上触及了当前生成式AI领域一个核心而深刻的议题——不同模态的生成模型,究竟在多大程度上「理解」了物理世界的运作规律。
世界模型(World Models)的概念解析
世界模型是AI领域中一个重要的概念框架,指的是智能体内部对外部环境运作规律的抽象表示。一个好的世界模型应该能够预测「如果我做了某个动作,环境会如何变化」。这个概念最早在强化学习领域得到系统阐述,2018年David Ha和Jürgen Schmidhuber的论文《World Models》将其推向高潮——他们用变分自编码器(VAE)压缩视觉观测,结合循环神经网络(RNN)预测未来状态,在简单游戏环境中验证了「在梦境中学习」的可行性。此后,Meta首席AI科学家Yann LeCun进一步将世界模型提升为通往自主机器智能的核心组件,他在2022年提出的联合嵌入预测架构(JEPA)明确主张:真正的智能需要在抽象表征空间而非像素空间中预测世界的演变,这与当前视频生成模型在像素级别建模的路径形成了有趣的对照和张力。
传统上,世界模型需要显式设计和训练——例如在模型预测控制(MPC)框架中,工程师需要为机器人手臂编写精确的动力学方程。但大规模生成模型的出现让研究者看到了新可能:模型是否能在海量数据的自监督学习中,自发地习得对物理世界的隐式建模能力?这正是当前视频生成模型研究的核心命题之一,也代表了从「手动编程物理规则」到「让模型自行发现物理规则」的范式转变。
「鹈鹕测试」的由来
对于熟悉AI评测圈的读者来说,「画一只骑自行车的鹈鹕」(pelican riding a bicycle)已经成为一个非正式但广为流传的基准测试。它最初由开发者Simon Willison提出,用来快速评估大语言模型和图像生成模型的能力边界。
之所以选择这个组合,是因为它要求模型具备多重能力:既要正确理解鹈鹕的解剖结构,又要理解自行车的机械构造,还要合理地把两者结合起来——一个鸟类如何「骑」在一辆为人类设计的交通工具上。
组合泛化能力(Compositional Generalization)深度解读
这对模型的组合泛化能力(compositional generalization)是极大的考验。组合泛化能力是衡量AI系统智能水平的关键指标,指的是模型能否将已学到的概念以新的方式组合,从而理解和生成训练时未曾见过的场景。这个问题有着深厚的认知科学根基——哲学家Jerry Fodor和Zenon Pylyshyn早在1988年就提出,人类思维的核心特征之一是「系统性」(systematicity):如果一个人理解「猫追狗」,就自然能理解「狗追猫」,因为概念是独立的、可自由重组的模块。这种能力是人类认知的基石——我们即使从未见过「紫色的长颈鹿开坦克」,也能立即想象出大致模样。
但对神经网络来说这极具挑战性。Lake和Baroni等人在SCAN、COGS等基准测试上反复验证,当前的深度学习模型在系统性泛化方面存在显著不足——它们往往过度依赖训练数据中的统计相关性(比如「鹈鹕」总是与「水面」「鱼群」共现),而非真正理解概念的独立性和可组合性。近年来虽然有研究表明,足够大的Transformer模型在特定条件下能展现出一定程度的组合泛化,但这种能力是否稳健、是否可迁移,仍是开放问题。「鹈鹕骑自行车」之所以成为经典测试,正是因为它要求模型真正理解「鹈鹕」和「自行车」作为独立概念,并合理推理它们的物理交互方式,这远超简单的模式匹配。
事实证明,绝大多数模型在这个任务上都会翻车,产出各种荒诞不经的图像。
视频模型为何可能拥有更强的世界模型
提问者的核心猜想是:视频生成模型可能天然拥有更强的世界模型。这并非空穴来风。
时间维度带来的物理约束
图像生成模型只需要生成一个静态的、内部自洽的画面。它可以「作弊」——只要单帧看起来合理即可,不需要考虑物体如何运动、重力如何作用、物体之间如何交互。
而视频模型则完全不同。要生成一段连贯的视频,模型必须隐式地建模时间演化过程:物体的运动轨迹要符合物理规律,遮挡关系要保持一致,光影变化要连续自然。
时间连贯性(Temporal Coherence)的技术挑战
这种对**时间连贯性(temporal coherence)**的硬性要求,迫使模型在训练过程中不得不学习更接近真实世界的动力学表示。时间连贯性是视频生成面临的核心技术挑战,要求生成的视频序列在时间维度上保持物理一致性和语义连贯性。具体包括:物体运动轨迹的平滑性和可预测性、遮挡关系的正确处理(被遮挡物体再次出现时应保持同一性)、光照和阴影的连续变化、物体间交互的因果合理性等。
早期视频生成模型常出现「闪烁」「跳变」「物体突然消失或变形」等问题,本质上就是时间连贯性建模不足。为了解决这个问题,现代视频模型引入了多种技术创新:3D卷积将空间和时间维度联合处理,时序注意力机制(temporal attention)让模型在生成当前帧时能参考先前和后续帧的信息,光流约束(optical flow constraints)则为帧间运动提供了显式的几何先验。更先进的方法还包括在潜空间(latent space)而非像素空间中建模时间动态,这不仅降低了计算成本,也让模型能在更抽象的层面捕捉运动模式。这些技术合力迫使模型不仅要生成每一帧的合理画面,还要确保帧与帧之间的转换符合物理直觉。
从像素预测到动力学建模
换句话说,当一个模型被训练去预测「下一帧会发生什么」时,它本质上是在学习世界的因果结构。这与语言模型「预测下一个token」的自监督范式异曲同工,但视频数据中蕴含的物理信息密度可能更高。
Diffusion模型与视频生成的技术演进
理解视频生成的技术突破,需要回溯扩散模型(Diffusion Models)的发展脉络。2020年,Ho等人提出的DDPM(Denoising Diffusion Probabilistic Models)奠定了基础——通过逐步向数据添加噪声再学习反向去噪过程来生成内容。2022年,Rombach等人提出的潜在扩散模型(Latent Diffusion Model,即Stable Diffusion的核心)将扩散过程从像素空间转移到压缩的潜在空间,大幅降低了计算需求。在此基础上,2023年Peebles和Xie提出的DiT(Diffusion Transformer)用Transformer架构替换了传统的U-Net骨干网络,为视频生成提供了更强大的架构基础。
这也正是为什么像OpenAI的Sora、Google的Veo等视频模型发布时,业界会反复强调它们是「世界模拟器」(world simulator)的雏形。OpenAI的Sora是2024年初发布的文本到视频生成模型,代表了视频生成技术的重大飞跃。Sora采用了DiT架构,将视频分解为时空patches(类似于ViT将图像切分为小块,Sora将视频切分为覆盖空间和时间维度的三维小块)进行处理,能生成长达60秒的高质量连贯视频。这种时空patch的处理方式使模型能够统一处理不同分辨率、不同长度、不同纵横比的视频,也让模型在注意力计算中自然地融合了空间和时间信息。
更重要的是,OpenAI在技术报告中明确提出Sora是「世界模拟器」的雏形,声称模型展现出了对3D一致性、物体持久性、长期时间连贯性的理解。这引发了学界对「视频生成模型是否真正建模了物理规律」的激烈讨论。类似的模型还包括Google的Veo、Runway的Gen-3、Kling(快手可灵)等,它们都在朝着更精确的物理世界建模方向演进。
涌现能力与视频生成的规模效应
值得注意的是,视频模型对物理规律的「理解」可能遵循类似大语言模型中观察到的涌现规律(emergent capabilities)——即模型在达到某个规模阈值后,会突然展现出在小规模时完全不具备的能力。这与Kaplan等人提出的神经网络规模定律(Scaling Laws)一脉相承:模型性能往往与参数量、数据量和计算量呈幂律关系平滑提升,但某些质变性的能力(如遵循复杂指令、进行多步推理)似乎在特定规模阈值后突然「解锁」。在视频领域,这意味着当模型规模和训练数据量达到某个临界点时,它可能从「生成看似合理的运动模式」跃迁到「真正理解重力、碰撞、流体等物理规律」。不过,这种涌现能力是真实的物理建模还是更精致的统计拟合,仍然是一个需要严格实验验证的开放问题。
Sora的技术报告中就明确提出,规模化的视频生成训练是构建物理世界通用模拟器的一条有希望的路径。
更容易,还是只是看起来更容易?
不过,这个观察也值得我们审慎看待,避免过度解读。
评测标准的差异
静态图像的「画鹈鹕」任务之所以显得困难,部分原因在于它的评判标准极其严苛——人眼可以长时间盯着一张静止图像,逐一挑出解剖学上的错误。而视频以每秒数十帧的速度流动,观看者的注意力被分散,很多细节上的破绽(比如手指数量突然变化、物体瞬间穿模)反而不容易被察觉。这种现象在心理学中被称为「变化盲视」(change blindness)——在动态场景中,人类对逐帧级别的细微变化感知能力远低于对静态画面的审视能力。
因此,视频看起来「更容易」,也可能部分是感知层面的错觉,而非模型真正掌握了更好的世界模型。这也提示我们,当前对视频生成质量的评估方法(如FVD、IS等自动指标,或简单的人类偏好评分)可能不够细致,需要开发更具物理针对性的评测基准——例如专门检测物体持久性、遮挡一致性、动力学合理性等维度的系统性测试。
训练数据的规模与质量差异
另一个不容忽视的因素是数据。视频模型往往在海量的真实视频片段上训练,这些片段本身就是物理世界的「记录」,天然包含了正确的运动和交互信息。模型可能更多是在「检索并重组」见过的真实片段,而非从头「推理」出物理规律。这一点在当前的可解释性研究中仍存在争议——有研究者通过探针实验(probing experiments)发现视频模型内部确实形成了类似深度图、物体分割等中间表征,暗示模型可能获得了某种结构化的场景理解;但也有研究指出,这些表征的鲁棒性远不如传统计算机视觉方法,在面对训练分布外(out-of-distribution)的场景时会迅速退化。
对AI发展与具身智能的启示
无论最终结论如何,这场讨论指向了一个越来越清晰的趋势:多模态、时序化的训练数据,可能是通往更强世界模型的关键路径。
具身智能(Embodied AI)与Sim-to-Real的范式转变
如果视频模型确实内化了更好的物理直觉,那么这对具身智能(embodied AI)、机器人控制、自动驾驶等需要精确世界建模的领域将有深远意义。具身智能是AI研究的新兴范式,强调智能必须通过与物理世界的交互来涌现和发展,而非仅仅处理抽象符号。这一理念挑战了传统的「智能即符号推理」观点,认为身体感知和运动控制是高级认知的基础——这与认知科学中「具身认知」(embodied cognition)的理论一脉相承,该理论认为人类的抽象思维根植于身体经验。
在机器人、自动驾驶等领域,具身智能要求AI系统不仅要理解视觉和语言信息,还要准确预测自身动作对环境的影响,并根据物理反馈调整策略。然而,长期以来,这一领域面临一个核心瓶颈:模拟到真实世界的迁移鸿沟(sim-to-real gap)。在仿真环境中训练的策略往往难以直接应用于真实世界,因为仿真器的物理引擎无法完美复现真实世界的所有复杂性——摩擦系数、材质弹性、光照条件等都存在系统性偏差。传统上,研究者通过域随机化(domain randomization)来缓解这一问题,即在训练时随机化仿真环境的物理参数,使策略对环境变化更具鲁棒性。
一个能够准确「想象」物理后果的模型,可以在虚拟环境中进行大量试错,从而降低真实世界训练的成本和风险。如果视频生成模型真的习得了可靠的世界模型,那么它们可以成为具身智能的「想象引擎」——不再依赖传统物理引擎的手动参数调优,而是用数据驱动的视频模型作为「神经仿真器」(neural simulator),自动捕捉真实世界中难以建模的复杂动力学。机器人可以在这种神经仿真环境中「想象」不同行动的后果,从而进行安全、高效的规划和学习,而无需在真实世界中进行危险和昂贵的试错。近期,已有研究团队(如Google DeepMind的UniSim、李飞飞团队的相关工作)开始探索用视频生成模型作为可交互的世界模拟器,初步结果显示这条路径具有巨大潜力。
从「画一只鹈鹕」这样一个略带戏谑的测试,到关于世界模型本质的严肃讨论,这恰恰体现了AI社区的一种独特文化——用最朴素的例子,逼问最深刻的问题。
结语
视频模型是否比图像模型「更懂世界」,目前尚无定论,需要更系统的对照实验来验证。但可以确定的是,随着模型从处理孤立的静态数据转向理解连续的时空过程,AI对物理世界的把握正在变得越来越细腻。从扩散模型的技术突破,到时空注意力的架构创新,再到规模化训练中可能涌现的物理直觉,每一步进展都在缩小AI「理解」与「模仿」之间的鸿沟。这或许正是我们向通用人工智能迈进过程中,一个安静却重要的里程碑。
核心要点
相关推荐
开源AI的真相:你拿到的只是蛋糕,不是配方
海外博主深度揭秘开源AI真相:你下载的只是权重(蛋糕),而非训练数据与代码(配方)。文章拆解开放权重与真正开源的差异,剖析Meta、阿里、DeepSeek的商业策略,以及中美欧三国政府如何用营收门槛与算力上限重画开放边界。
DSH白嫖DeepSeek V4.1 Flash:积分批量领取与国际版WorkBuddy实测
DSH项目最新升级实测:WorkBuddy端可批量领取100积分,限流额度提升、重置时间缩短,国际版WorkBuddy现已支持免费调用混元4与DeepSeek V4.1 Flash,附使用建议与风险提示。
DSH-SUBAGENT-UI插件:DeepSeek Harness子代理管理神器
DSH-SUBAGENT-UI 是 DeepSeek Harness Web 客户端插件,提供子代理总览、搜索、本地分类与完成快照功能,数据存本地不侵入原会话,一条命令即可安装,助力多子代理工作流高效管理。